SetupAI商業
商業
清華數學系大神跳槽OpenAI!曾主導SAM與Llama開發
清華大學數學系頂尖人才跳槽加入OpenAI。他先前主導Meta的SAM影像分割模型與Llama大型語言模型開發。
量子位 · 206 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
清華大學數學系頂尖人才跳槽加入OpenAI。他先前主導Meta的SAM影像分割模型與Llama大型語言模型開發。
量子位 · 206 天前

Pika 以 AI 影片聞名,推出 AI Selves,讓使用者創造並養育個性化 AI 分身,可自訂人格、記憶,甚至如花生過敏等細節。這些數字分身能處理群聊、製作遊戲、打電話,並在 X、Discord 等平台上與使用者共同進化。
机器之心 · 210 天前

據報 DeepSeek Flash 4.1 已開始內部 Beta 測試,並透過 API 陸續推出。這個中間版本宣稱具備原生多模態支援、更強能力、更快推理速度與更低成本,同時維持 DeepSeek V4 Flash 的定價。
Reddit r/LocalLLaMA · 11 天前
一名開發者聲稱在三週內抓取了 59.4 億部 TikTok 影片與 32.3 億個個人檔案,並將影片資料集發布到 Hugging Face。資料還包括個人檔案、留言、回覆、標籤與音訊,但抓取方式可能違反 TikTok 服務條款,完整程式碼也需付費取得。
Reddit r/MachineLearning · 17 天前

Anian 是一套用於圍產期心理健康支援的安全閘門多模態後端,會將使用者輸入經過結構化狀態表示、保守風險融合及受控回應生成。其原型在分類與路由測試中取得良好內部結果,但作者強調,這些結果尚未證明臨床有效性、診斷準確度或真實世界安全性。
ArXiv AI · 21 天前
神秘模型 OxAlpha 突然上線,聲稱支援百萬級上下文視窗,以及圖像、文字和影片的多模態輸入輸出。該模型目前提供免費輸入與輸出,但其開發公司和技術來源尚未明確。
虎嗅 · 26 天前

據報 Tencent 的 Hunyuan Hy4 已出現在 Yuanbao App 的模型選擇清單中,被標示為專家級模型,並具備工具使用能力。它的定位高於 Hy3,並與 DeepSeek 並列;此前 Tencent 曾表示,更大參數規模的 Hy4 將很快推出,並提升效能與多模態能力。
Reddit r/LocalLLaMA · 30 天前
據報導,Tencent 正將多模態 AI 方向從內容生成轉向上下文理解與在真實世界中行動。這項轉變似乎更接近梁文鋒對推理與執行的重視,也與 Fei-Fei Li 偏向世界模型的研究路線有所區隔。
钛媒体 · 31 天前
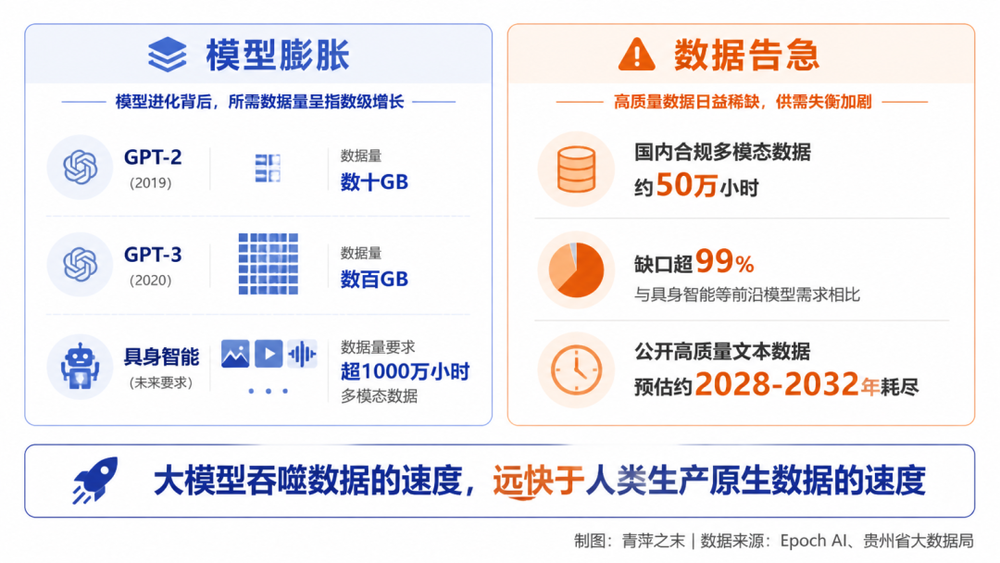
文章指出,隨著 AI 模型持續擴大並拓展至多模態應用,高品質且可合法使用的訓練資料正逐漸稀缺。出版商與內容擁有者可能因此取得新的議價能力,但版權複雜性、資料工程成本、合成資料與模型效率提升,仍可能限制其定價權。
虎嗅 · 33 天前

Hugging Face 推出 LFM2.5-VL-3B,這是一款旨在為邊緣裝置提供更佳、更快速視覺能力的視覺語言模型。此次更新強調適合需要本地端或低延遲多模態推理的應用情境。
Hugging Face Blog · 38 天前

紫东太初推出適用於多模態模型的 GMC 核心集剪枝方法。這項免訓練、開箱即用的技術據稱可減少 80% Token 使用量,同時保留多模態能力。
量子位 · 38 天前
Ming-Flash-Omni 被介紹為全模態統一基礎模型。文章聚焦於建構可端到端處理多種模態模型的關鍵技術與實務經驗。
InfoQ中国 · 45 天前
OpenAI 正在為其 Codex 模型測試全新的即時語音模式。此功能旨在協助使用者處理日常任務(如管理 Slack 更新與訂餐),將其應用範圍從單純的程式編碼擴展至日常事務。
TestingCatalog · 58 天前

Google 在 Gboard 中整合了手語識別功能,標誌著鍵盤從單純的輸入工具轉型為多模態 AI 平台。此舉不僅提升了無障礙體驗,也展示了將複雜的電腦視覺任務整合至日常行動介面的能力。
钛媒体 · 61 天前
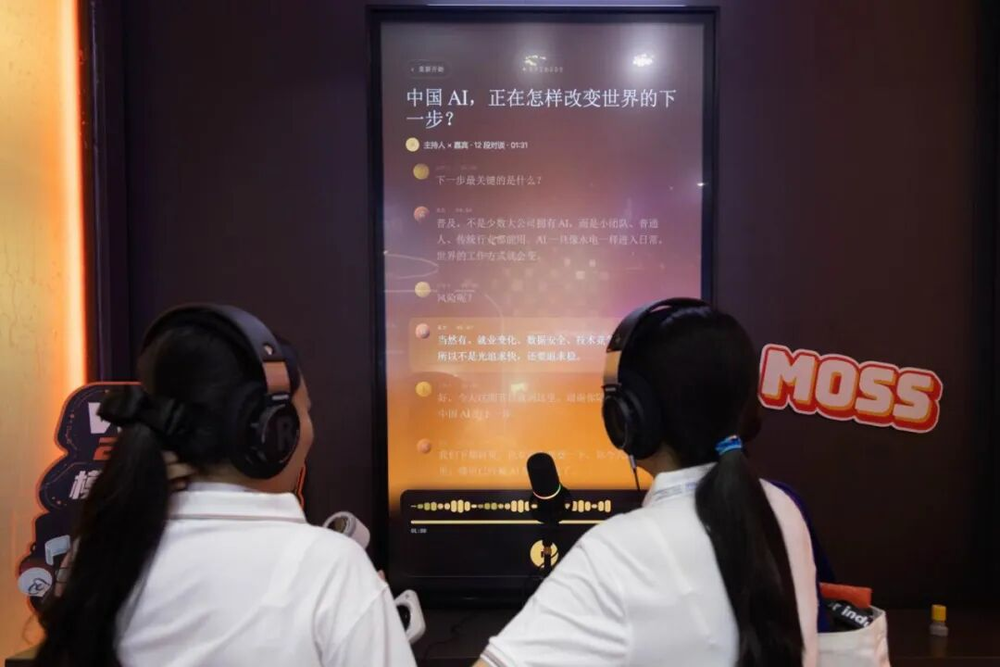
早期中國大語言模型 MOSS 的開發團隊成立了模思智能,將重心轉向「情境智能」,優先發展端到端語音交互而非純文本模型。目前正開發語音轉寫、視頻理解及 TTS 等系列模型,旨在實現更自然的人機交互。
虎嗅 · 63 天前
Google 已將 Gemini Omni 與個人 AI 虛擬替身整合至 Vids 平台。這些功能讓付費用戶能透過自然語言描述來生成與編輯影片內容。
Digital Trends · 65 天前
NeurIPS 2026 首屆 RTCA 工作坊現正徵求關於即時多模態對話代理的論文。重點在於解決即時互動系統中的延遲、輪流對話及評估等挑戰。
Reddit r/MachineLearning · 65 天前
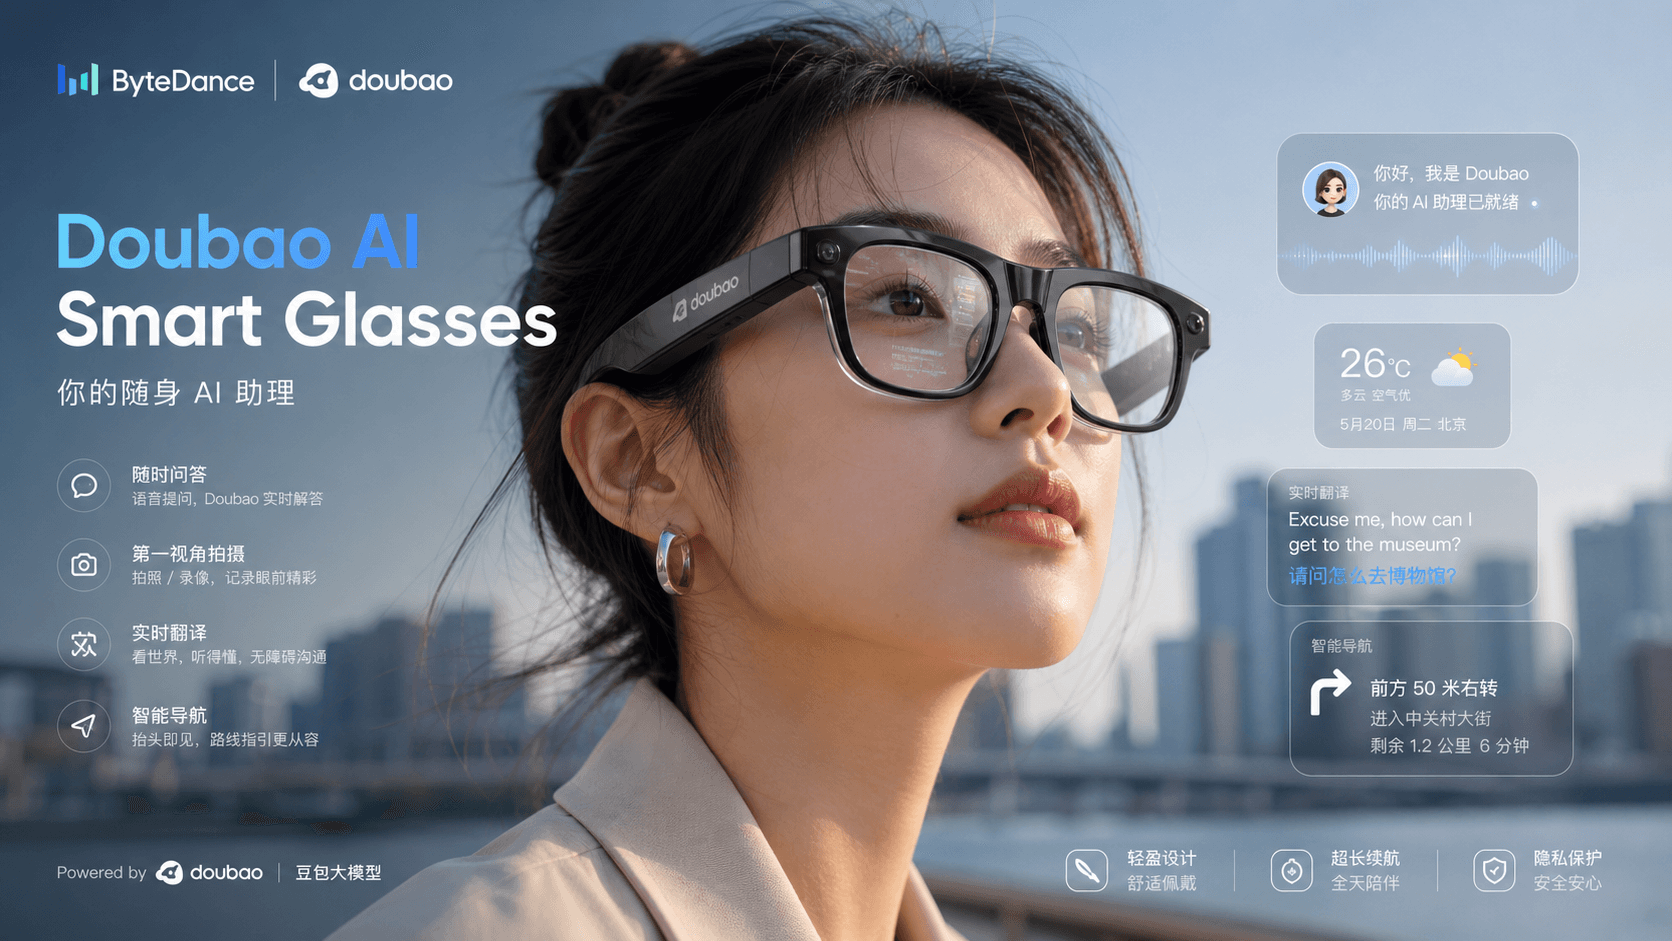
ByteDance 取消了第一代 AI 眼鏡計畫,轉而專注於更具競爭力的雙模型第二代產品。此舉旨在於快速成長的市場中挑戰 Meta 的 Ray-Ban 智慧眼鏡。
Pandaily · 65 天前

全球AI全模態內容互動娛樂平台SeaArt近日完成超億元人民幣B輪融資。資金將用於多模態底層研發、全球市場拓展及AI垂類應用孵化。
36氪 · 68 天前

YouTube 已在美國推出 AI 驅動的搜尋功能,允許使用者透過描述特定情境、想法或活動來尋找影片。這種對話式介面旨在透過超越簡單的關鍵字匹配,來提升內容搜尋的精準度。
Digital Trends · 70 天前

ChatGPT 最新的 Live Voice 更新具備同時監聽、對話與線上搜尋的能力。此功能為使用者帶來了更自然、更接近真人的互動體驗。
ZDNet AI · 72 天前

Horus Hiero 是一款基於 Qwen 3.5 的新型開源多模態模型,專為翻譯古埃及象形文字而設計。它支援 150 種語言,並具備 512K 的超大上下文視窗。
Reddit r/LocalLLaMA · 73 天前
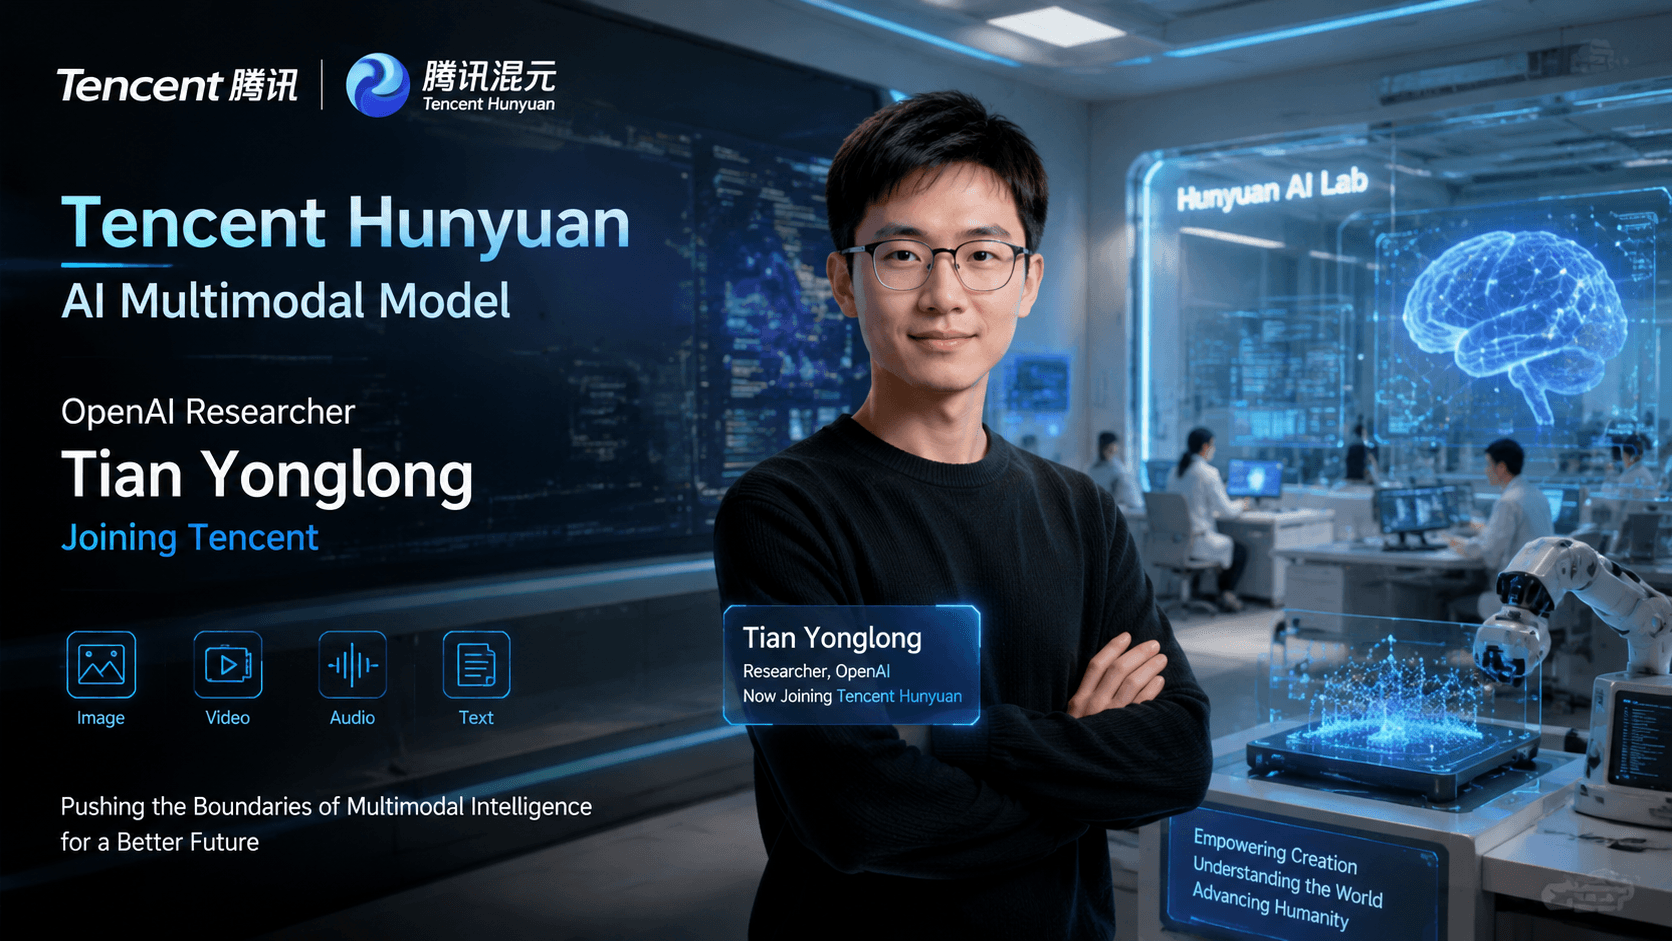
Tencent HY 延攬 OpenAI 研究科學家 Tian Yonglong 領導其多模態模型開發。他將直接向首席 AI 科學家 Yao Shunyu 匯報,此舉為該公司戰略性人才招募的一環。
Pandaily · 73 天前
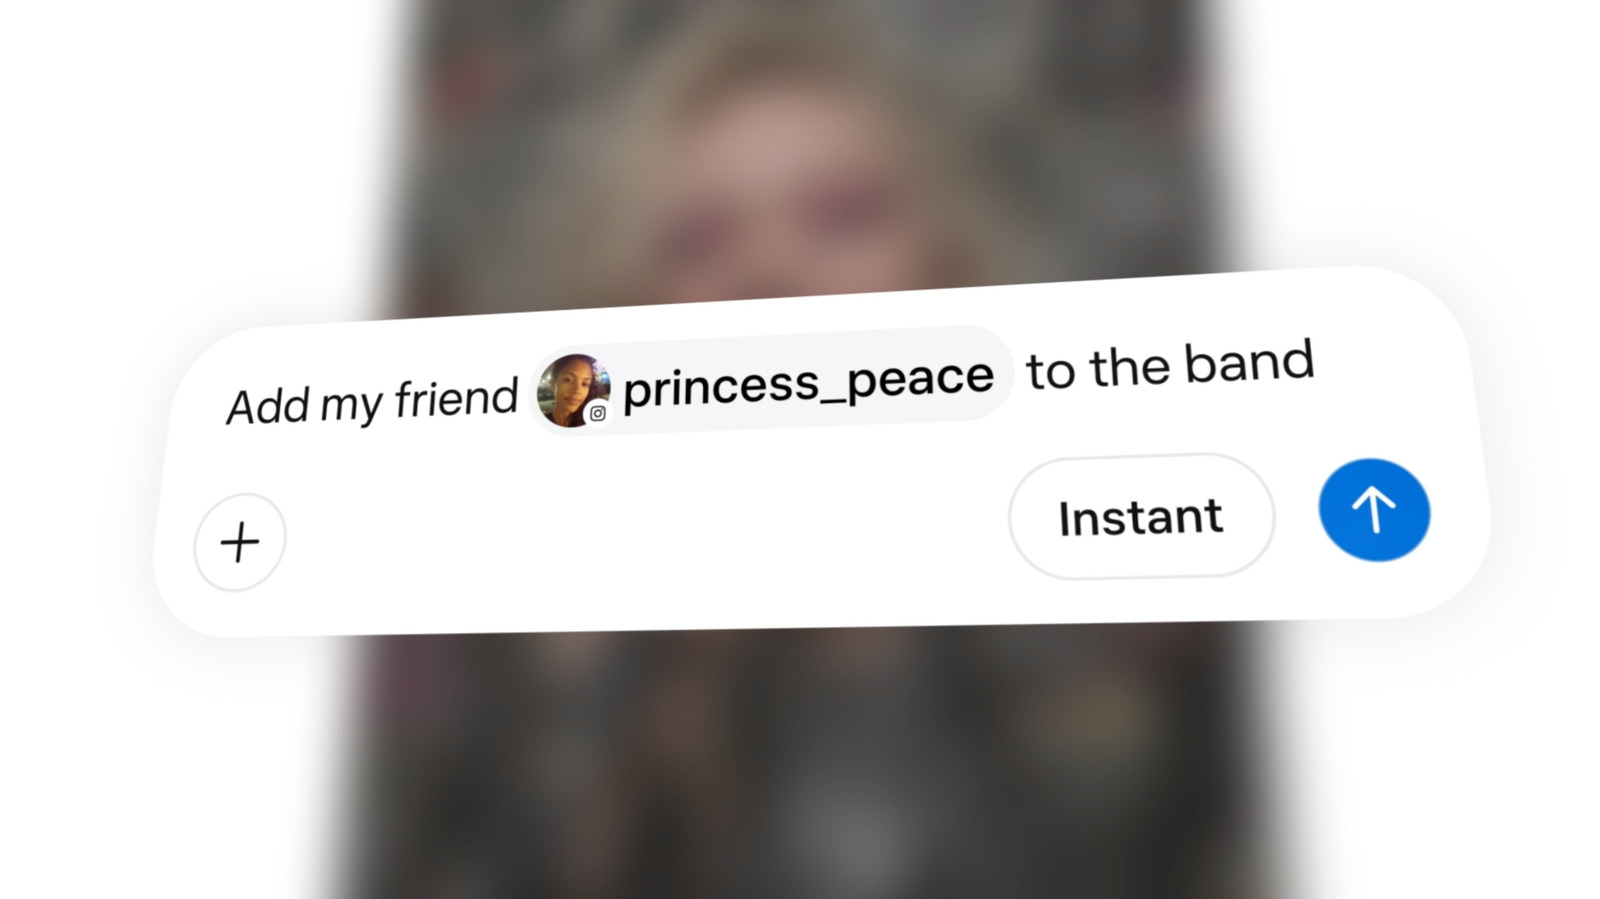
Meta 將其 Muse 圖像生成模型與 Instagram 整合,允許使用者將社群媒體個人檔案作為 AI 生成圖像的基礎。該模型目前也正被部署於 WhatsApp 的圖像生成功能,以及 Stories 的創意特效中。
Engadget · 74 天前
openJiuwen 推出了全新的多模態範式 Skill-Omni,讓 AI 代理能夠從視覺數據而非僅僅是文字說明書中學習。此轉變使代理能夠建立更直觀且全面的經驗庫。
量子位 · 74 天前
在上海舉辦的「電動版F1」賽事中,Google的Gemini AI提供了實時解說,標誌著多模態AI在體育轉播中的獨特應用。
量子位 · 75 天前
AI 影片開發的重心正從視覺保真度轉向功能性智慧。下一代虛擬人將優先考慮「看」與「聽」的能力,從而實現更具互動性與情境感知能力的體驗。
The Next Web (TNW) · 79 天前
Om AI 發布了 VLX,這是一款專為物理世界互動而設計的流式多模態模型,旨在推動端側 AI 應用的發展。
量子位 · 80 天前
智譜 AI 唐杰發起全球意見徵集,探討即將推出的 GLM-5.3 模型開發方向。社群反饋顯示,使用者對增強視覺處理能力有強烈需求。
量子位 · 81 天前
虎牙發布了 VAM 1.0 即時多模態數位人,支援 24 小時不間斷直播。該技術僅需一張照片即可生成能聊天、唱跳並與觀眾互動的虛擬形象。
量子位 · 81 天前