
模型
美團發布原生多模態 LongCat-Next
美團於3月27日發布並全面開源原生多模態大模型 LongCat-Next 及其核心組件——離散原生分辨率視覺分詞器 dNaViT。該模型打破以語言為中心的傳統拼湊式架構,將圖像、語音與文本統一映射為同源離散 Token。
36氪 · 176 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
美團於3月27日發布並全面開源原生多模態大模型 LongCat-Next 及其核心組件——離散原生分辨率視覺分詞器 dNaViT。該模型打破以語言為中心的傳統拼湊式架構,將圖像、語音與文本統一映射為同源離散 Token。
36氪 · 176 天前
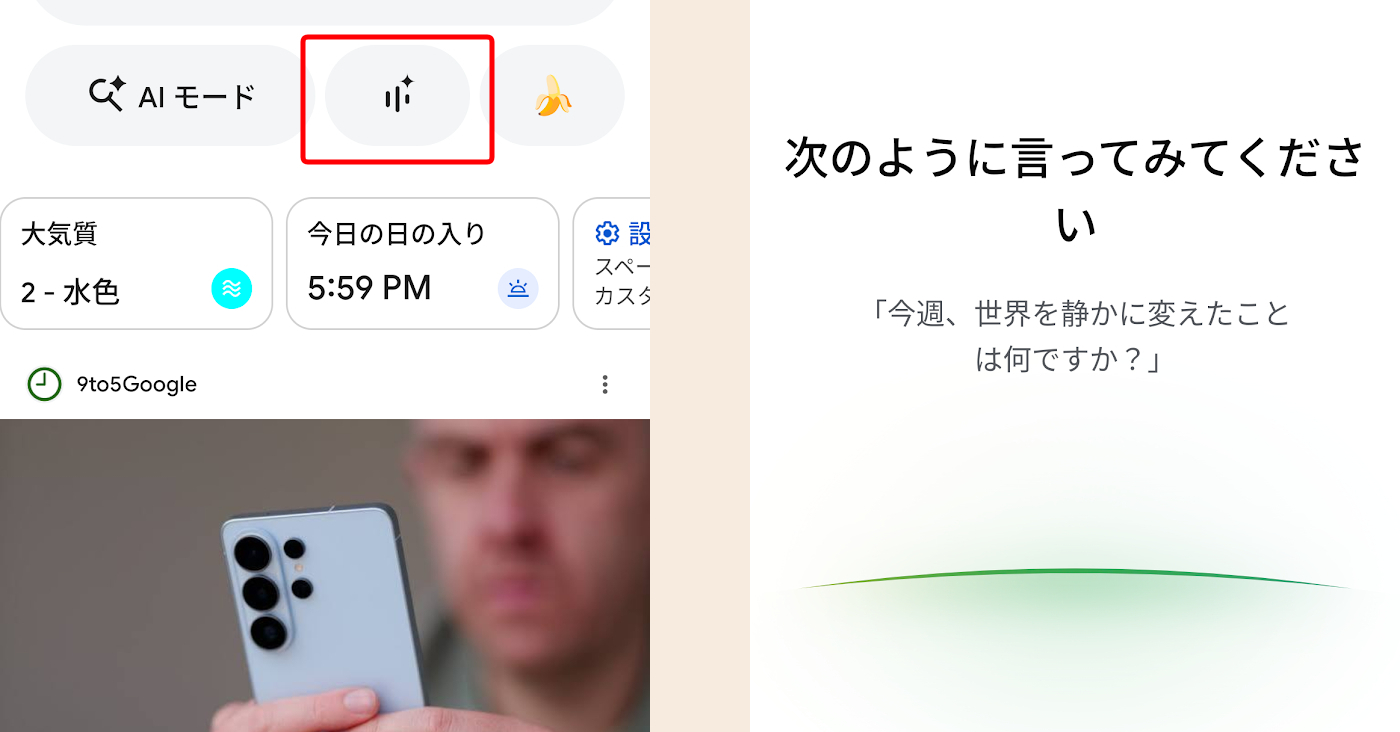
Google 在日本及所有啟用 AI 模式的地區推出「Search Live」功能。由 Gemini 3.1 Flash Live 驅動,可進行即時語音與相機互動,具備更好的音訊細微差別理解及情緒適應回應。
ITmedia AI+ (日本) · 176 天前

字節跳動推出 Dreamina Seedance 2.0 新一代多模態影片生成模型,已正式整合至 CapCut 影片剪輯應用。OpenAI 關閉 Sora 應用之際,字節跳動加碼消費級影片生成領域。
cnBeta (Full RSS) · 177 天前
谷歌 TurboQuant 將 AI 記憶體使用量縮減 6 倍,導致 SanDisk 和 Micron 股價下跌。本文拆解其背後的軟硬體博弈。
钛媒体 · 177 天前
Google 為 Google TV 推出三項 Gemini AI 功能:更豐富的視覺幫助處理如體育比分和食譜查詢、互動主題深度探索,以及語音體育簡報。這些功能將被動觀看轉為教育體驗。
Engadget · 179 天前

Hugging Face 推出 Nemotron 3 Content Safety 4B,這是一個 40 億參數的先進內容審核模型。它支援如文字和圖像等多模態輸入,並處理多種語言以適用全球應用。
Hugging Face Blog · 183 天前

精選開源多模態工具彙總:FlashMotion 快速影片生成、Foundation 1 音樂生產、GlyphPrinter 文字渲染等,包括 MatAnyone 2 和 ViFeEdit。權重/程式碼皆可本地運行。
Reddit r/LocalLLaMA · 185 天前

Mistral AI 推出 Forge 平台,讓企業使用內部資料訓練 AI 模型。它支援多模態輸入與代理優先調校,用於客製化企業解決方案。
TestingCatalog · 185 天前
Openrouter 的隱藏模型 Hunter Alpha 和 Healer Alpha 正式確認為 MiMo V2 Pro 和 MiMo V2 Omni。Hunter Pro 提供 1M 上下文的純文字推理,Healer Omni 支援文字+圖像,上下文 262K。
Reddit r/LocalLLaMA · 185 天前

OpenAI 推出 GPT-5.4 mini,讓 ChatGPT Free 和 Go 用戶可透過「Thinking」模型選擇器存取先進功能。它在推理、多模態理解和工具使用方面優於 GPT-5.0 mini,且執行速度快兩倍以上。
Engadget · 186 天前

H Company 發布 Holotron-12B,這是與 NVIDIA 合作開發的開源多模態模型,專為電腦使用代理設計。效能與 Holo2/Qwen 相當,但吞吐量高 2 倍。
Reddit r/LocalLLaMA · 186 天前

中國出海AI營銷公司Titanium Tech年收從2023年7282萬美元增至2025年前9月1.3億美元,向港交所遞表IPO。AI解決方案佔比90%,自研多模態模型,毛利率82%以上,但應收5.57億美元及平台依賴成隱憂。
虎嗅 · 187 天前
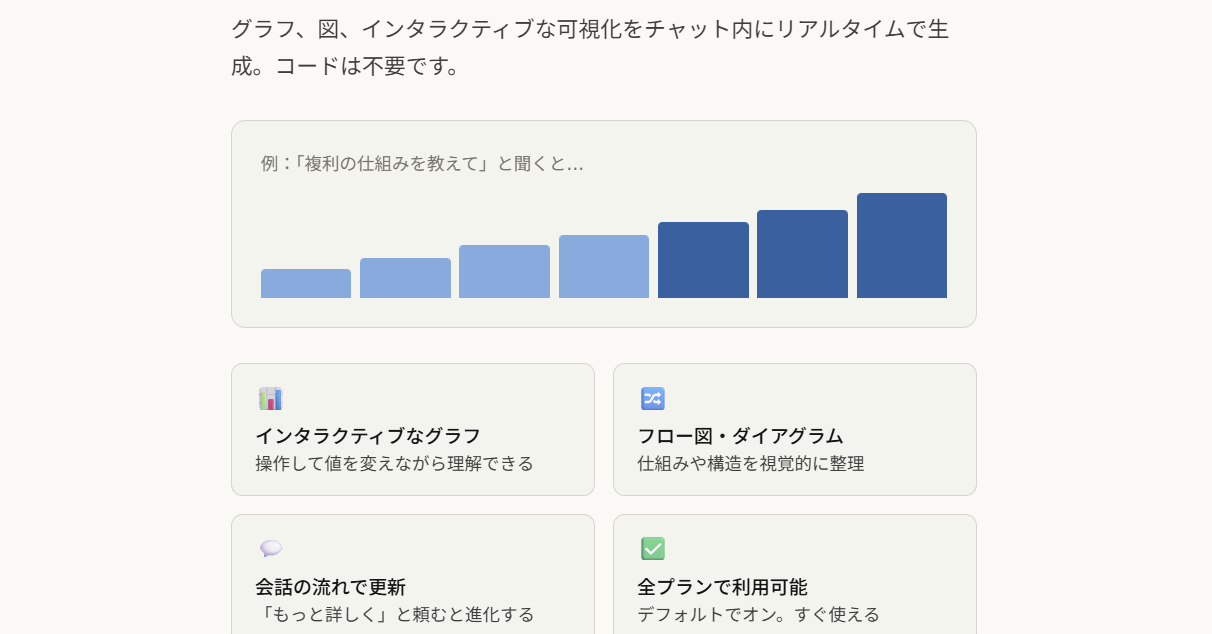
Anthropic 在 Claude 中推出 β 版功能,可在聊天回應中內嵌生成表、圖表與影像。此功能基於 2025 年 9 月發布的「Imagine with Claude」,所有用戶包含免費版均可使用。
ITmedia AI+ (日本) · 190 天前

OpenAI 的 Sora 影片生成器據報將整合至 ChatGPT 成為內建功能。目前僅限於其網站或獨立 App,使用率低於 ChatGPT,此舉類似去年新增圖像生成功能。
The Verge · 192 天前
新 4.5B 參數模型 ColQwen3.5-v1,基於 Qwen3.5-4B 採用 ColPali 晚期互動,於 ViDoRe V1 達 nDCG@5 0.917 SOTA。Apache 2.0 授權於 Hugging Face;v2 目標 ViDoRe V3 SOTA。
Reddit r/MachineLearning · 192 天前

谷歌推出首個原生多模態嵌入模型,將文字、圖像、影片、音頻統一至單一嵌入空間。戲劇性示範讓龍蝦「看懂」螢幕。
量子位 · 192 天前

Google 推出 Gemini Embedding 2 模型,這是一款全新多模態嵌入解決方案。它支援文字、圖像、影片、音訊和文件嵌入於統一向量空間中。
TestingCatalog · 193 天前
商湯徹底摒棄多模態模型中的VE與VAE元件,移除所有中間編碼器,打造簡化架構。其全新2B參數模型大幅超越傳統範式。
量子位 · 196 天前

Luma 推出 UNI-1,這是視覺理解與影像生成的統一模型。它合併文字與影像處理來處理推理任務。
TestingCatalog · 197 天前

Luma 推出 Luma Agents,由其新「Unified Intelligence」模型驅動。這些代理能協調多個 AI 系統,生成橫跨文字、圖像、影片與音訊的端到端創意作品。
TechCrunch AI · 198 天前
YuanLab.ai 正式開源發布 Yuan3.0 Ultra 多模態基礎大模型。它將 MoE 大模型訓練效率優化系統性引入模型結構設計,並針對企業應用進行深度優化。
36氪 · 198 天前
Microsoft 推出 Phi-4-reasoning-vision-15B,這是 15B 參數的開放權重多模態模型,在視覺語言任務、數學/科學推理與 GUI 導航表現出色。僅用 200B 多模態 token 訓練—僅對手 1/5—透過優異資料策劃匹敵更大模型。
VentureBeat · 199 天前

Microsoft 發布 Phi-4-Reasoning-Vision-15B,這是使用 SigLIP-2 視覺編碼器與中融合架構的輕量開源多模態模型。它支援思維鏈推理或直接推論,用於數學、圖說與 GUI 定位等任務。
Reddit r/LocalLLaMA · 199 天前

Anthropic 在 Claude Code 推出語音模式。此功能為 AI 程式設計輔助增添語音能力。
TechCrunch AI · 200 天前
Qwen3.5-4B 模型的新無審查版本以 GGUF 格式發布,在 465 次測試中零拒絕。保留完整能力,支持多模態輸入,提供從 2.6GB 到 7.9GB 的各種量化版本。
Reddit r/LocalLLaMA · 200 天前

阿里千問開源四款 Qwen3.5 小尺寸模型:0.8B、2B、4B、9B。繼承強大多模態能力,適用邊端設備至緊湊伺服器。
IT之家 · 201 天前

SleepLM 推出基礎模型,將多模態多導睡眠圖與自然語言對齊,用於睡眠分析。它策劃首個大規模睡眠-文字資料集,來自超過 10 萬小時、涵蓋 10,000 多人的資料。
ArXiv AI · 201 天前
Reddit 貼文詳細說明如何在 opencode 中使用 llama.cpp 啟用 Qwen 3.5 的多模態圖像理解。使用者需在 opencode.json 檔案中新增「modalities」設定,指定文字與圖像輸入。
Reddit r/LocalLLaMA · 203 天前
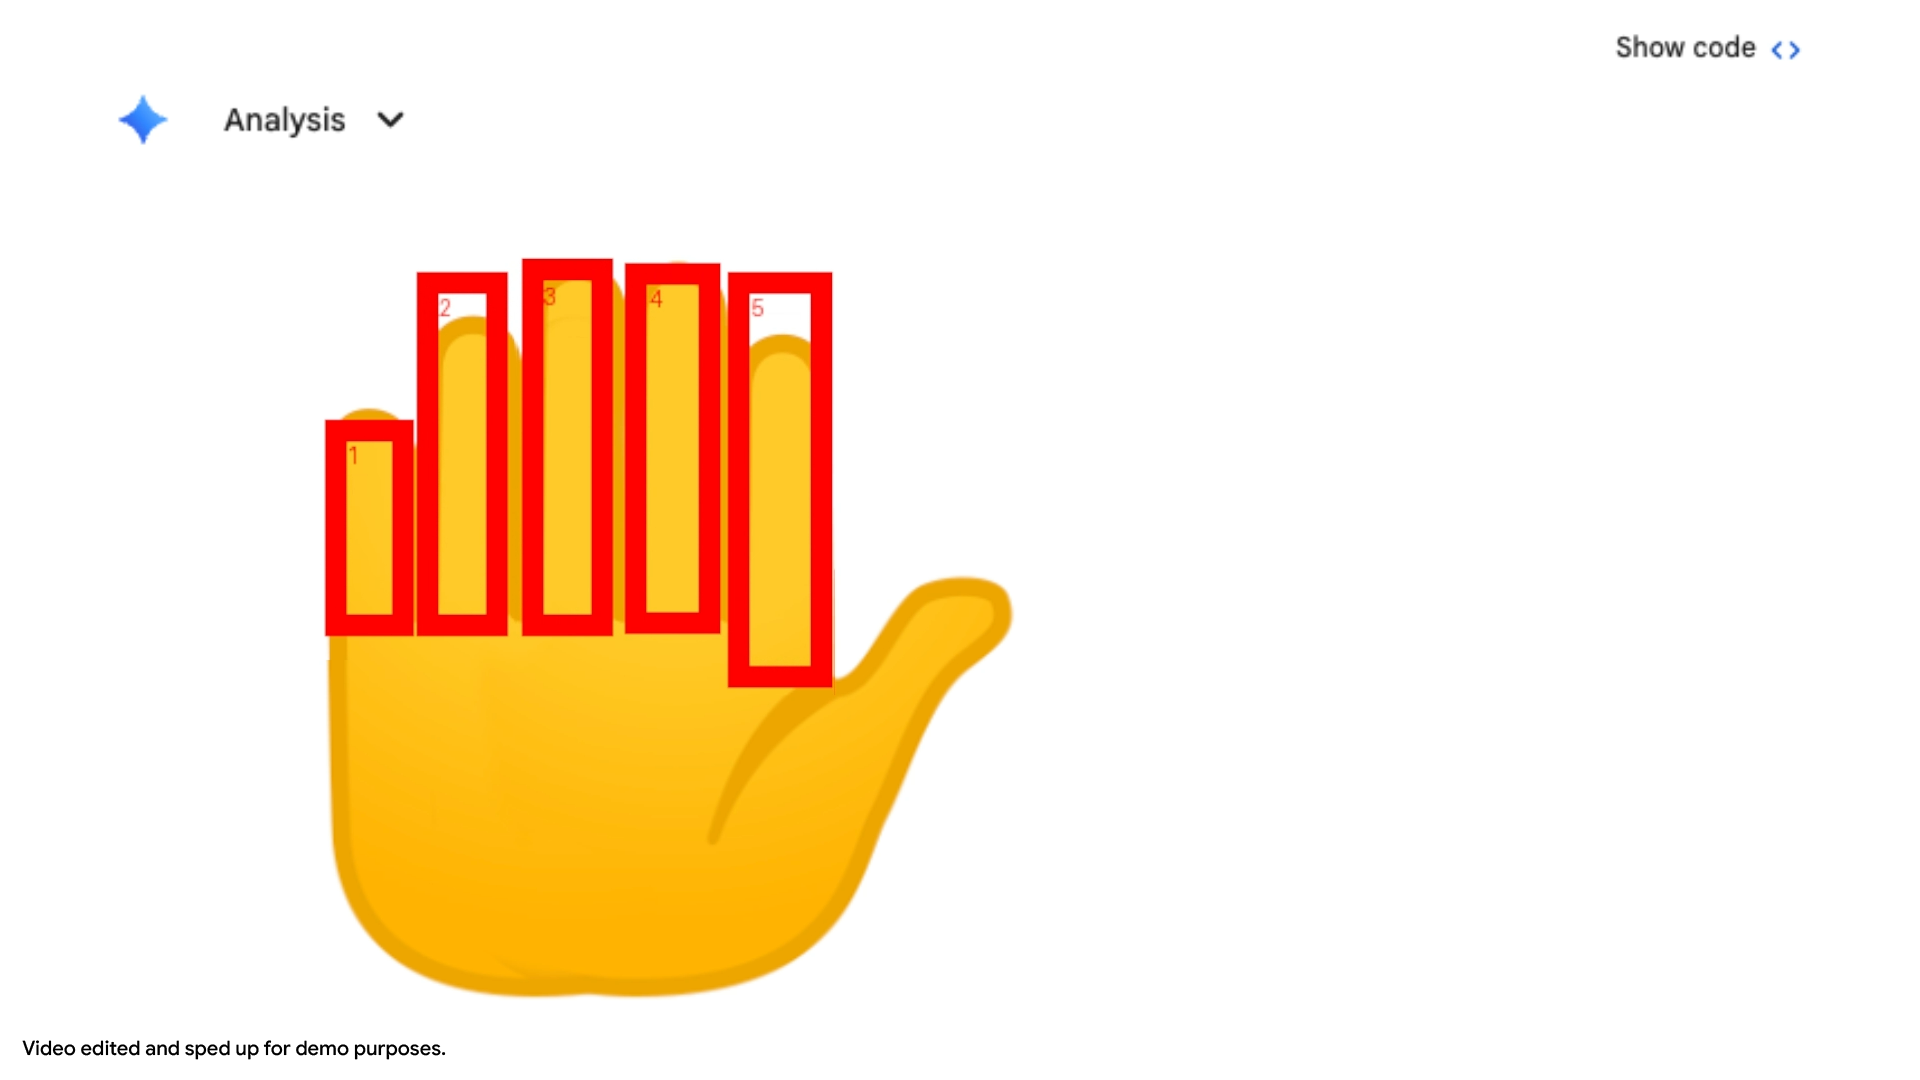
Google 為 Gemini 3 Flash 推出新功能「Agentic Vision」,結合視覺推論與程式碼執行。它會自動產生 Python 程式碼調查影像,將影像理解精度提升 10%。
ITmedia AI+ (日本) · 204 天前
Gemini 3.1 Flash Image Preview(Nano Banana 2)現已在 AI Gateway 上線,提升視覺品質同時維持 flash 階層的速度與成本。它使用 Google Image Search 以真實世界資料 grounding 影像,並引入可配置思考等級(Minimal/High)來處理複雜提示。
Vercel News · 205 天前