
研究
COMPASS:統一多模態模型中的組合意圖接地技術
COMPASS 是一個全新的統一多模態框架,旨在提升細粒度組合識別與控制能力。透過在感知與生成任務中共享專家標記,該模型實現了對圖像生成的精確佈局控制。
ArXiv AI · 81 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
COMPASS 是一個全新的統一多模態框架,旨在提升細粒度組合識別與控制能力。透過在感知與生成任務中共享專家標記,該模型實現了對圖像生成的精確佈局控制。
ArXiv AI · 81 天前
由日本多家大企業共同出資的 AI 開發公司宣布更名為「Noetra」。該公司正與產業技術總合研究所(AIST)合作,開發國產多模態 AI 基礎模型。
ITmedia AI+ (日本) · 81 天前
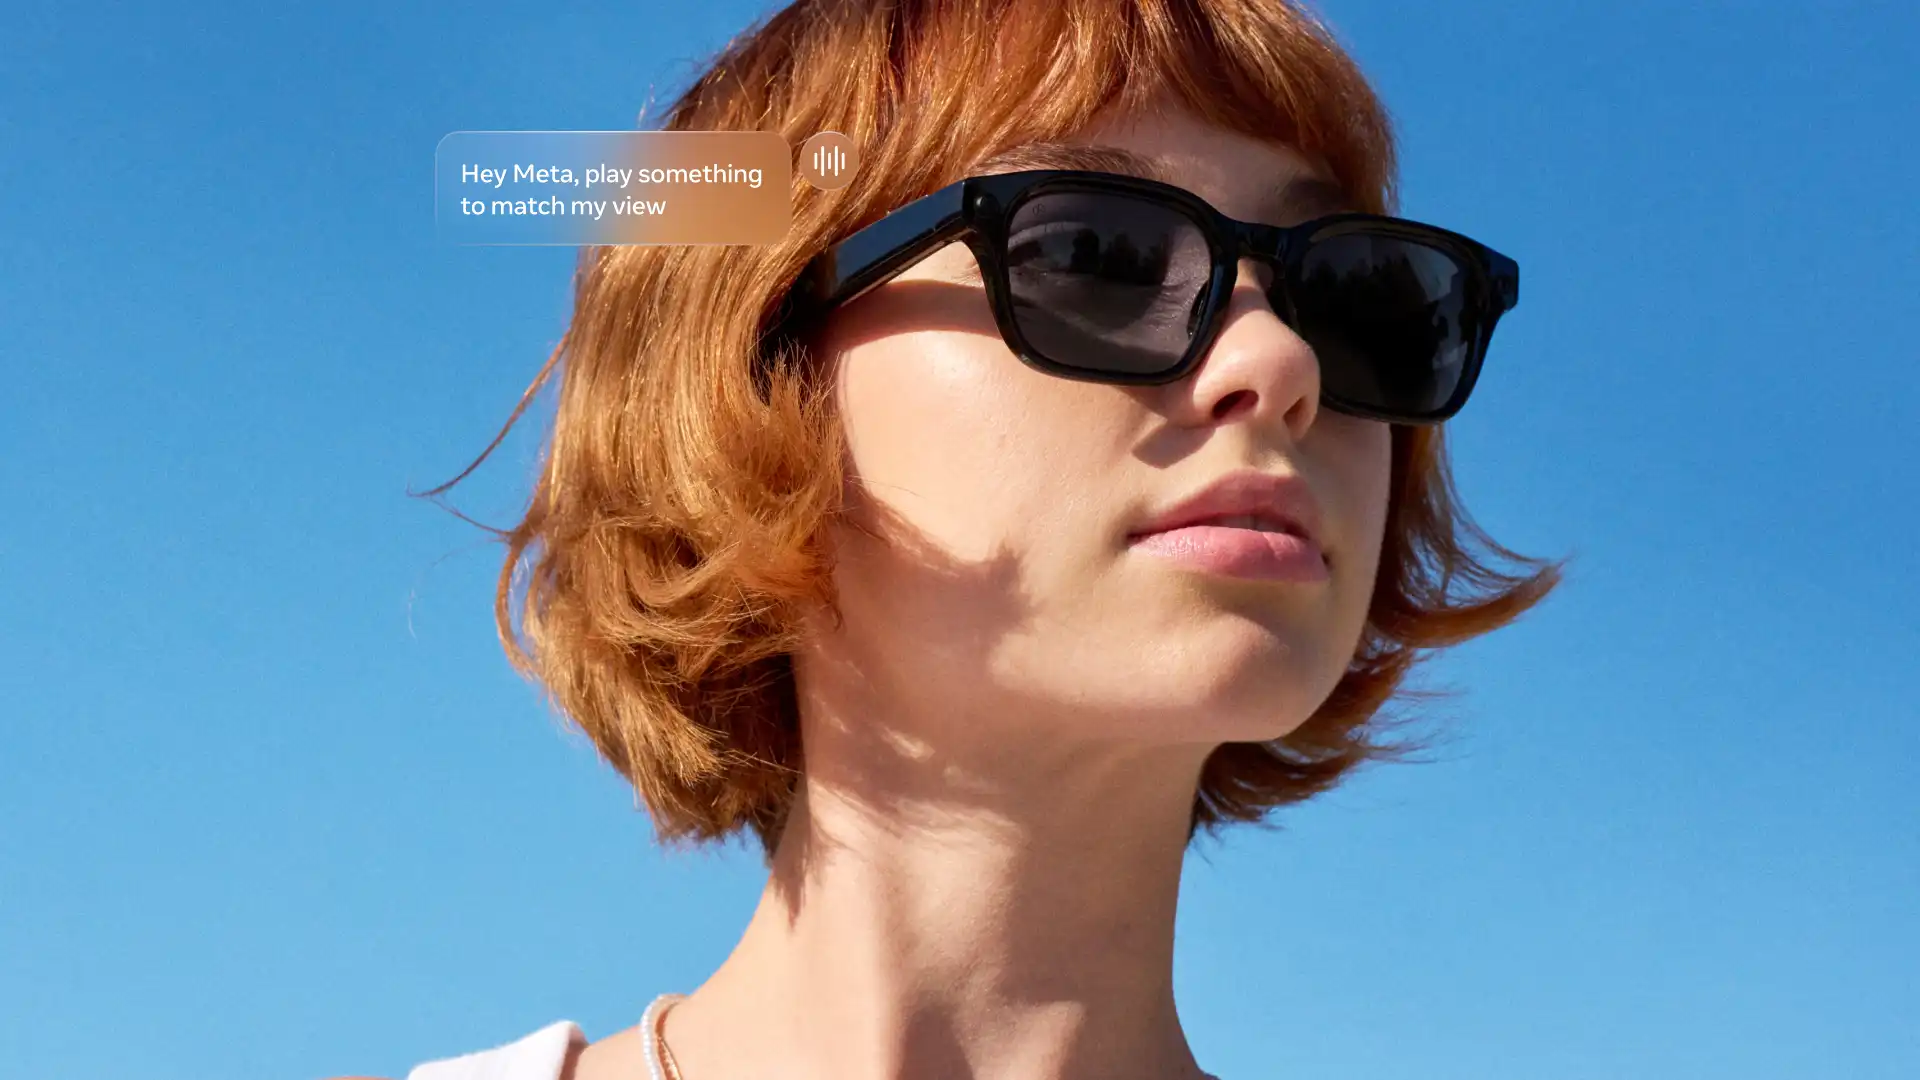
Meta 與 EssilorLuxottica 合作推出新款 AI 智慧眼鏡。該產品具備智慧音訊與免持拍攝功能,並提供 26 種鏡框款式選擇。
TestingCatalog · 87 天前
Meta 推出了售價 299 美元的新款自有品牌智慧眼鏡。該公司目前也在研發未來可能推出的無鏡頭硬體版本。
Bloomberg Technology · 88 天前
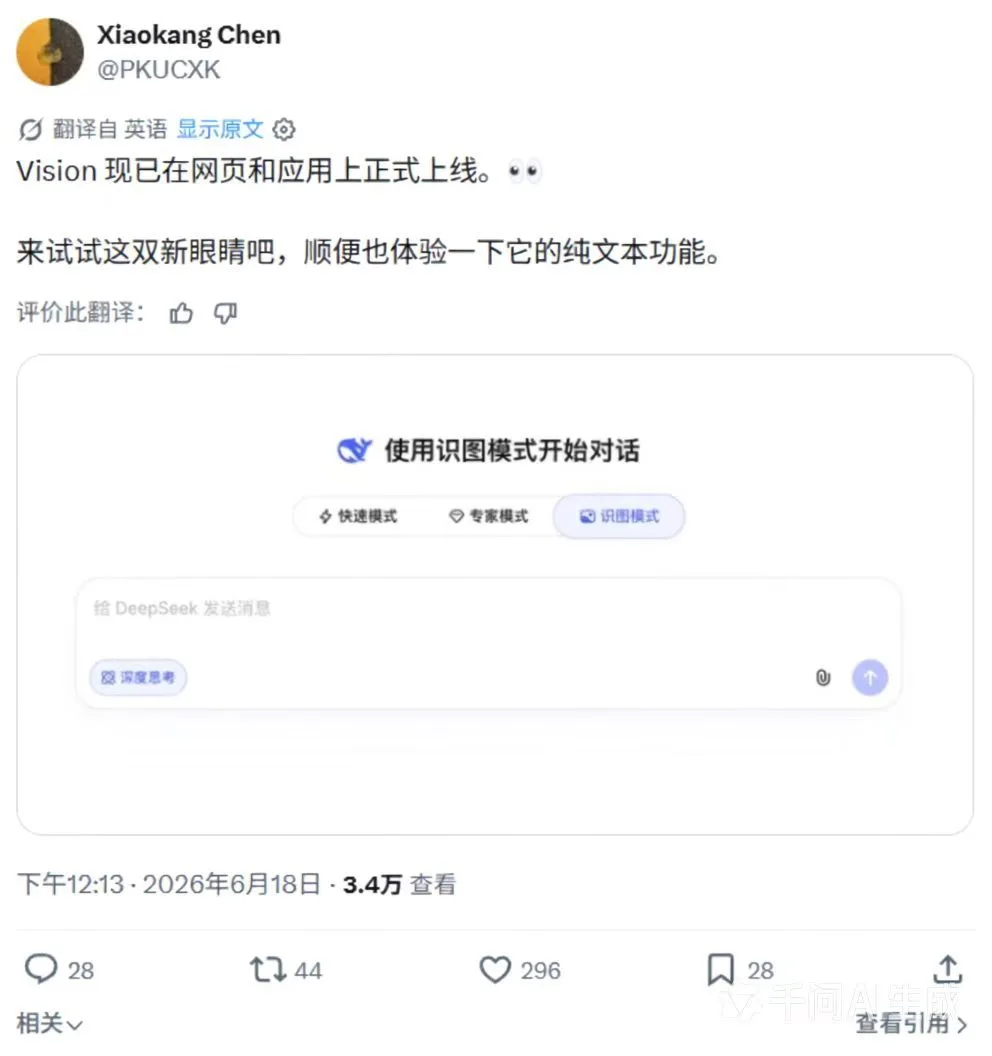
DeepSeek 已正式在網頁與 App 端推出多模態識圖功能。目前網頁端已可使用,但 App 端仍顯示該功能處於內部測試階段。
cnBeta (Full RSS) · 93 天前
SERAF 是一個透過結合數值數據與自生成文字描述來提升時間序列預測的新框架。透過執行雙重檢索,它克服了傳統基於相似度的方法在非平穩環境中的限制。
ArXiv AI · 95 天前
v0.18.0-preview.0 版本為 Qwen-code CLI 帶來了顯著改進,包括自動更新支援、qwen3.7-plus 的多模態支援以及新的自動化分類工作流程。此外,該版本還透過更好的狀態顯示和擴展的技能管理功能優化了使用者體驗。
Qwen (GitHub Releases: qwen-code) · 102 天前
「Query Retrieve Conclude」框架透過檢索即時網路證據,解決了解釋動態新興迷因的挑戰。該框架在迷因理解與偵測任務中,表現優於現有的零樣本基準模型。
ArXiv AI · 105 天前

針對 MiniMax M3 模型進行實測,測試其在面對複雜的 Nvidia 簡報時的視覺推理能力。實測結果展示了該模型處理與理解高密度視覺資訊的能力。
量子位 · 109 天前

Amazon 為陣亡將士紀念日大幅調降了 Meta Ray-Ban 智慧眼鏡的價格。折扣適用於第二代 Ray-Ban 和 Oakley HSTN 型號。
ZDNet AI · 120 天前

字節跳動旗下的影片剪輯軟體 CapCut 已正式接入 Google 的 Gemini 模型。用戶現在可以透過自然語言對話指令來生成或編輯影片內容。
Ifanr (爱范儿) · 120 天前

Chance AI 獲得由美圖領投的數百萬美元天使輪融資。該公司正在開發以攝像頭為主要交互入口的「視覺智能體」,旨在理解用戶意圖並執行任務。
36氪 · 122 天前

Google 正準備為 Mac 版 Gemini 桌面客戶端進行重大更新。此次發布將引入包括 Voice Mode、Stream to Cursor 以及 Omni 影片生成在內的多項進階功能。
TestingCatalog · 124 天前
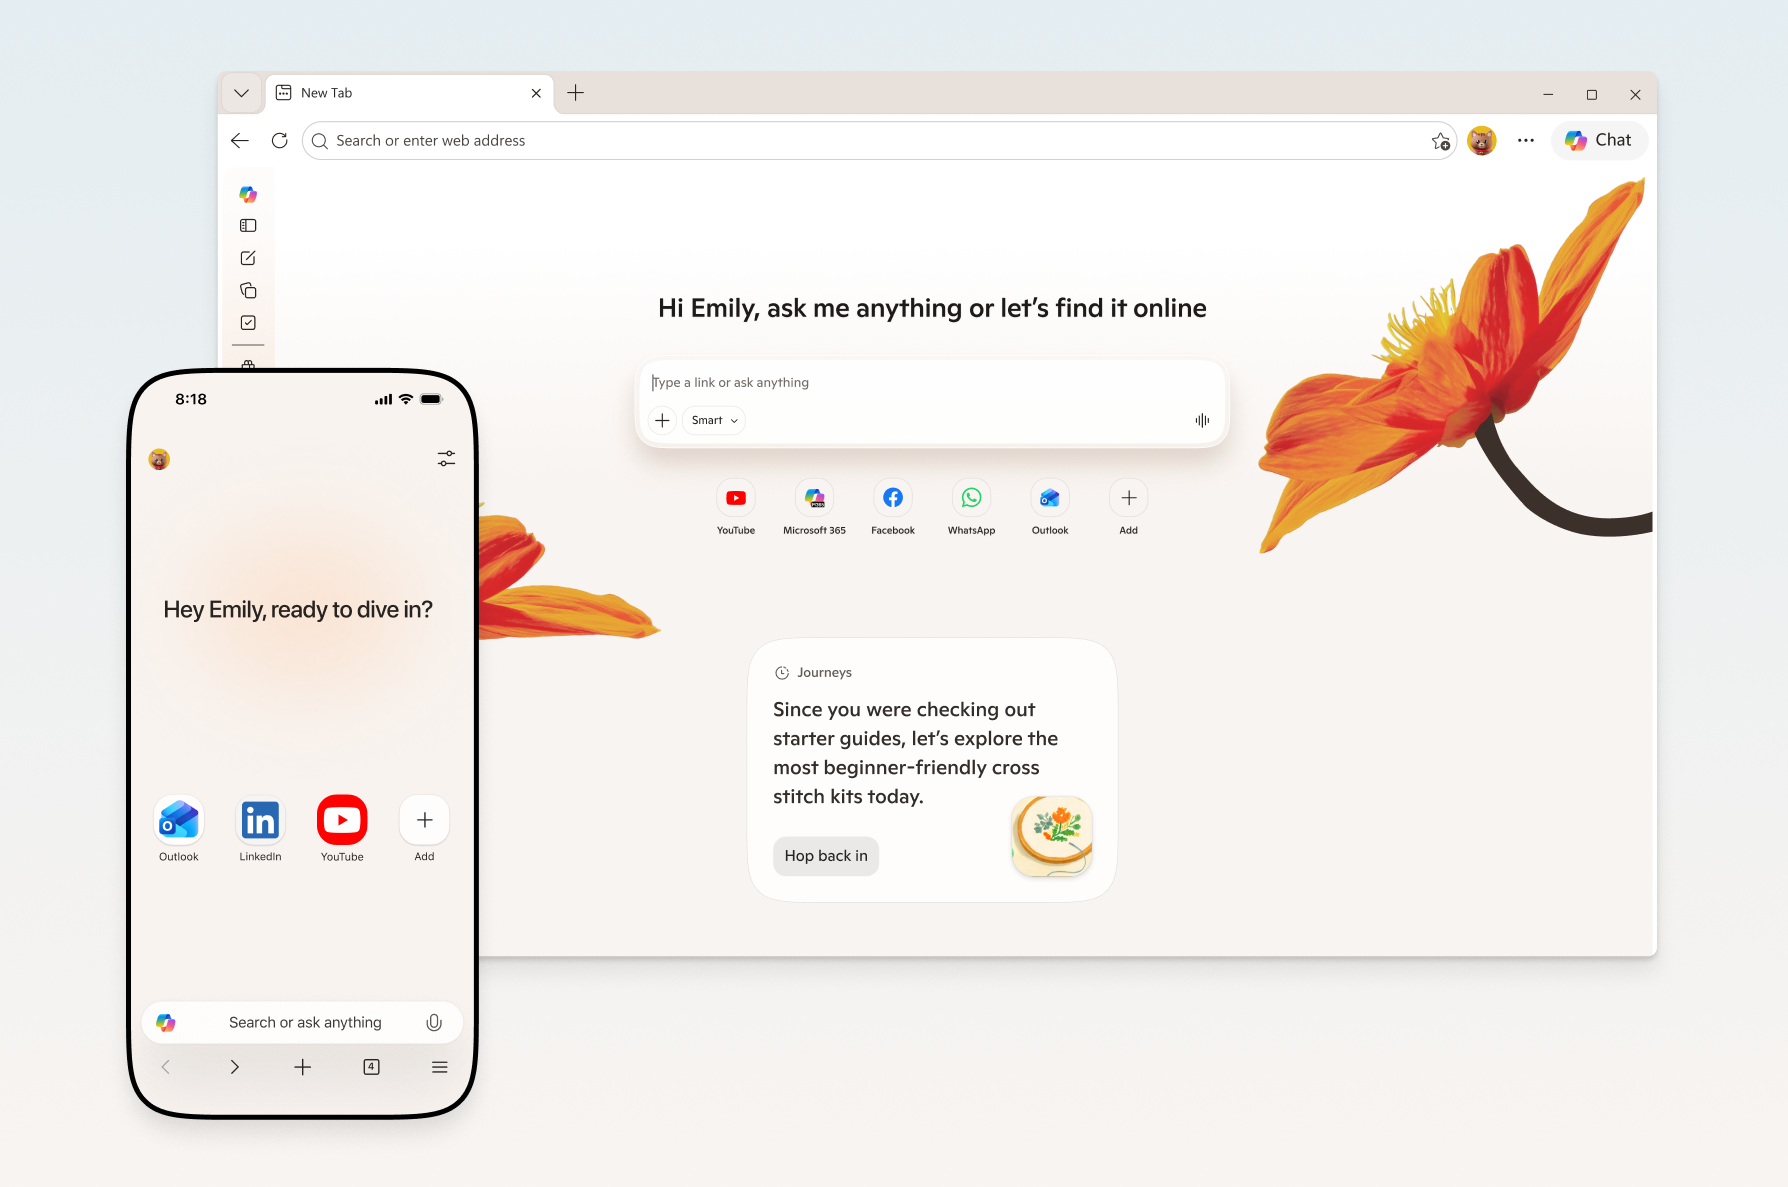
Microsoft 將先進的 AI 工具直接整合至桌面版與行動版 Edge 瀏覽器中。新增功能包括多頁籤推理、Vision、語音功能以及專門的學習工具,旨在提升用戶生產力。
TestingCatalog · 128 天前

Google 正在 Chromebook 上以 Gemini AI 重新定義電腦游標。使用者可指向螢幕元素、語音指令,並獲得桌面全方位脈絡幫助。
Digital Trends · 129 天前

Thinking Machines 正在開發一款 AI 模型,能同時處理使用者輸入並產生回應。這改變了目前輪流互動的模式(說、聽、回應),轉為即時如電話般的對話。
TechCrunch AI · 130 天前
ArXiv新論文顯示,在圖表影像上疊加座標網格的空間引導,顯著優於語義提示,提升多模態LLM資料萃取準確率。語義方法如元資料優先與思維鏈無顯著改善。
ArXiv AI · 130 天前

Thinking Machines 發表全新 Interaction Voice Models。這項預覽展示了其 AI 在音頻、視頻和文字上的即時原生交換功能。
TestingCatalog · 130 天前
卓驭科技在北京車展發布面向移動物理AI的原生多模態基礎模型,強調視覺、音頻與動作的預訓練融合。副總裁于貝貝認為,此轉型是演算法廠商的生存法則,以應對數位AI巨頭競爭。
36氪 · 140 天前
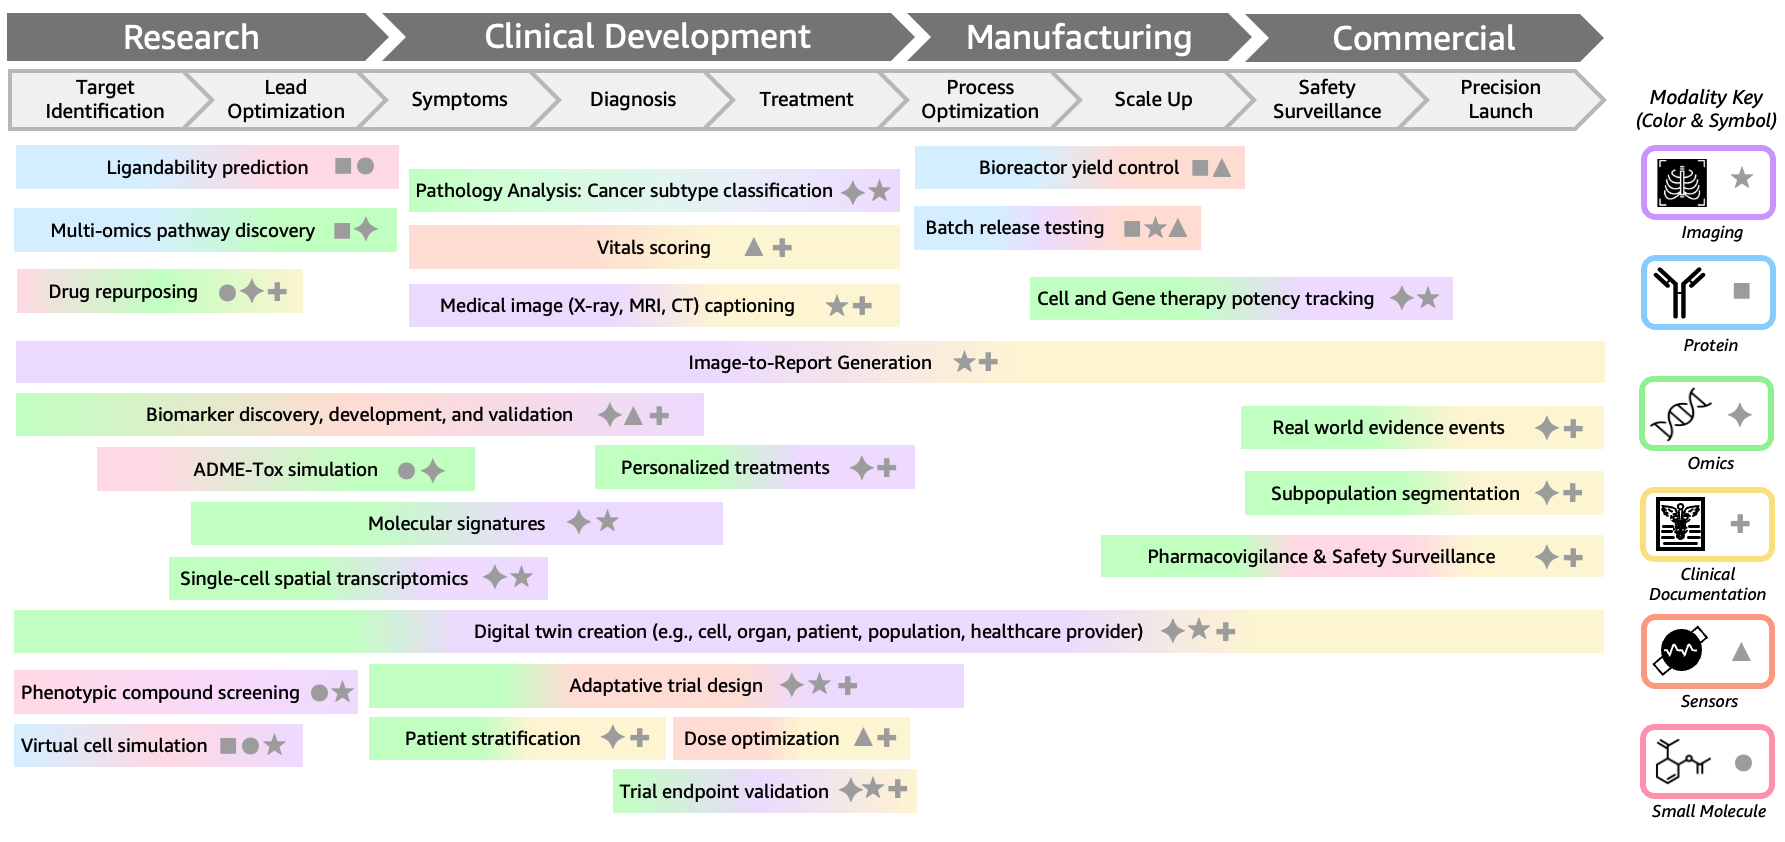
這篇 AWS 機器學習部落格文章探討多模態生物基礎模型 (BioFMs) 的運作原理。它展示其在藥物發現與臨床開發的實際應用。
AWS Machine Learning Blog · 149 天前

使用者分享的堆疊讓 Qwen3.6-27B 模型在單一 RTX 3090 GPU 上達到 85 個 token 每秒、125K 上下文長度並支援視覺功能。此設定一夜之間完成,並在 Reddit 上發布給社群使用。
Reddit r/LocalLLaMA · 149 天前

地平線機器人推出類似特斯拉FSD結合Grok的系統。此系統讓機器適應人類表達習慣。
Ifanr (爱范儿) · 149 天前

繼豆包之後,阿里巴巴的千問也追求「臉」或人設。大廠開始為 AI 模型注入人格化。
钛媒体 · 150 天前

OpenAI 已重新奪回 AI 圖像生成領域的領先地位。此更新強調其在該領域的新領導力。
The Neuron · 150 天前
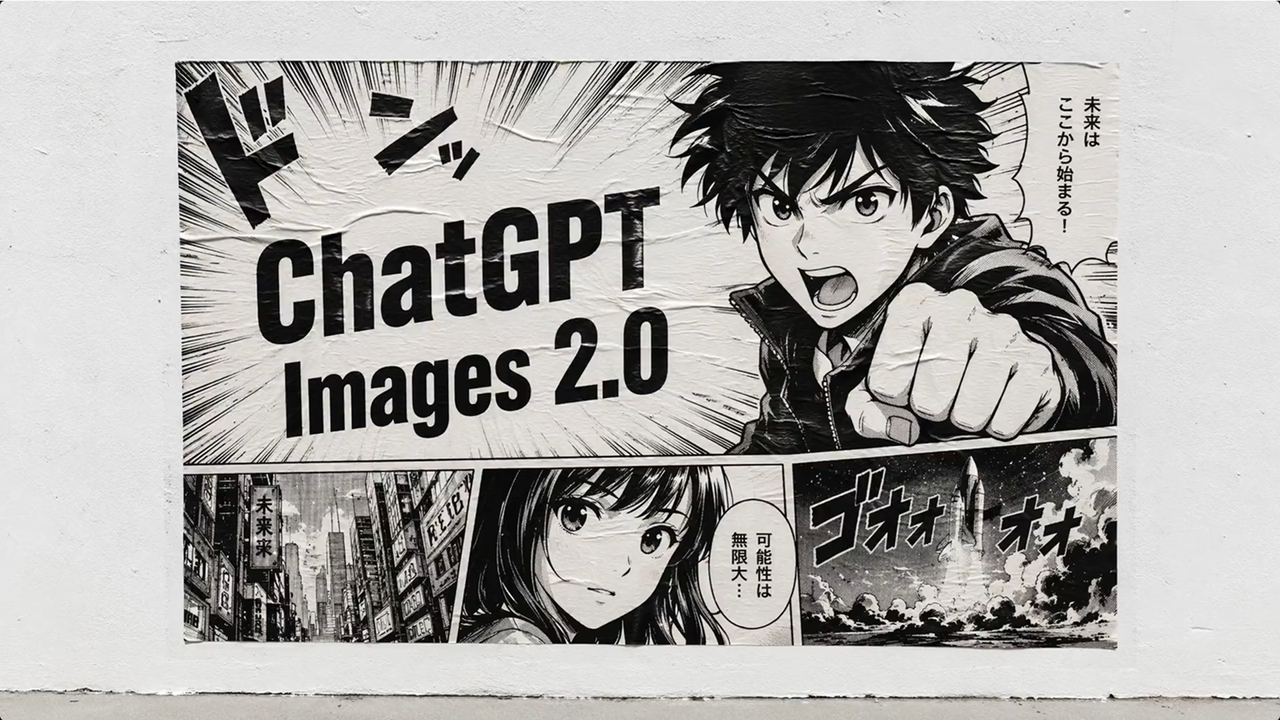
ChatGPT Images 2.0 升級圖像生成,具備更強的推理能力,產生更清晰的文字與更可靠的輸出。此進展使其更接近真正的多模態 AI,有望徹底改變 AI 圖像創作流程。
TechRadar AI · 150 天前
Kimi K2.6 被推薦為 Opus 4.7 的強力替代品,在大多數任務上達到 85% 的品質。具備視覺、瀏覽器使用功能,並擅長長時程任務。
Reddit r/LocalLLaMA · 151 天前
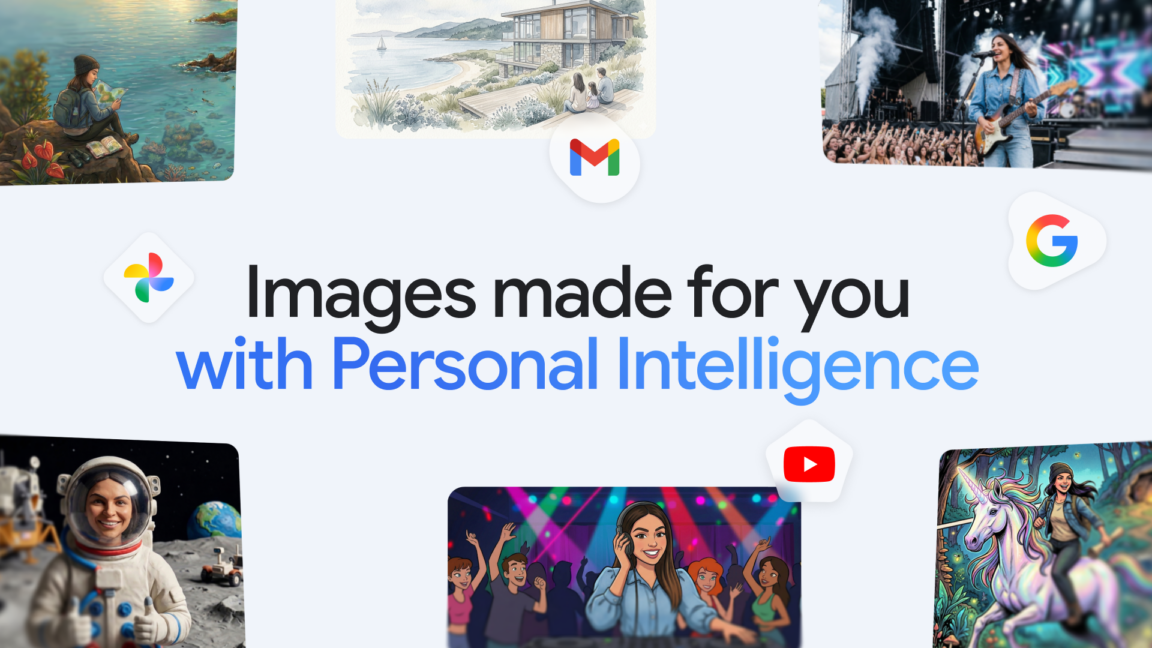
Google 的 Gemini 現在可存取使用者 Google Photos 圖庫,產生個人化 AI 圖像。此更新簡化將個人照片輸入稱為 Nano Banana 的圖像生成系統,提供更相關的輸出。
Ars Technica · 156 天前
Google 的 Gemini 應用程式現提供建立個人化圖像的新方式。Nano Banana 2 利用您的個人脈絡與 Google Photos,生成反映您獨特生活的圖像。
Google AI Blog · 156 天前

Gemma 4 31B 從複雜圖像如 F1 賽車生成優質 3D 模型,勝過 Claude Sonnet 4.6、Gemini 3.1 Pro、ChatGPT 及 Qwen3.5 27B。僅用 3600 令牌產生優異結果,對手需 6800+ 且有缺陷。
Reddit r/LocalLLaMA · 156 天前
智象未來完成新一輪融資,金額超過5億元人民幣。公司計劃全力打造下一代原生全模態世界模型。
量子位 · 156 天前