
編程
Anthropic 推出 Claude Opus 4.7 模型
Anthropic 推出最強一般可用模型 Claude Opus 4.7。它在進階軟體工程、複雜編碼、影像分析、指令遵循及創意文件生成表現優異。
The Verge · 156 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
Anthropic 推出最強一般可用模型 Claude Opus 4.7。它在進階軟體工程、複雜編碼、影像分析、指令遵循及創意文件生成表現優異。
The Verge · 156 天前

Cloudflare 將 AI Gateway 發展為 AI 代理的統一推理層。開發者現在可呼叫 14+ 提供者的模型。
Cloudflare Blog · 156 天前

LLM-HYPER 將大型語言模型視為超網路,透過少樣本思維鏈提示生成冷啟動廣告的無訓練 CTR 模型參數,利用多模態內容。使用 CLIP 嵌入擷取相似活動作為示範。
ArXiv AI · 156 天前

Cloudflare Agents SDK 的實驗語音管線支援 WebSockets 即時語音互動。提供連續 STT 和 TTS。
Cloudflare Blog · 157 天前

阿里巴巴 Qwen 助手推出免費試算表代理。可從自然語言提示、圖像或 PDF 在數分鐘內生成與編輯 Excel 檔案。
Pandaily · 157 天前

llama.cpp 的 llama-server 現支援使用 Gemma-4 E2A 和 E4A 模型進行語音轉文字 (STT)。此更新為本地 LLM 伺服器帶來音訊處理功能。
Reddit r/LocalLLaMA · 160 天前

中國團隊打造首個大規模超聲專屬數據集,包含36.4萬圖文對。此數據集讓AI真正理解超聲影像的臨床診斷語義。
量子位 · 160 天前
阿里巴巴正在重組其AI組織,同時開發HappyHorse,這款排名頂尖的影片模型。此舉支持涵蓋AI模型、雲端服務及應用程式的更廣泛推進。
Pandaily · 162 天前
MiniMax 推出 MMX-CLI,這是一款專為 AI 代理自動化設計的命令列介面。它讓 AI 代理能夠自主執行完整的多模態工作流程。
Pandaily · 163 天前

Google在日本推出「Gemini for Home」早期存取,取代Google Assistant。處理模糊指示、文脈對話,用於音樂、家電及智慧攝像頭分析。
ITmedia AI+ (日本) · 163 天前
Hugging Face 宣布整合 Sentence Transformers 的多模態嵌入與重新排序模型。這些模型可處理文字與影像資料,提升檢索與排序任務效能。
Hugging Face Blog · 163 天前
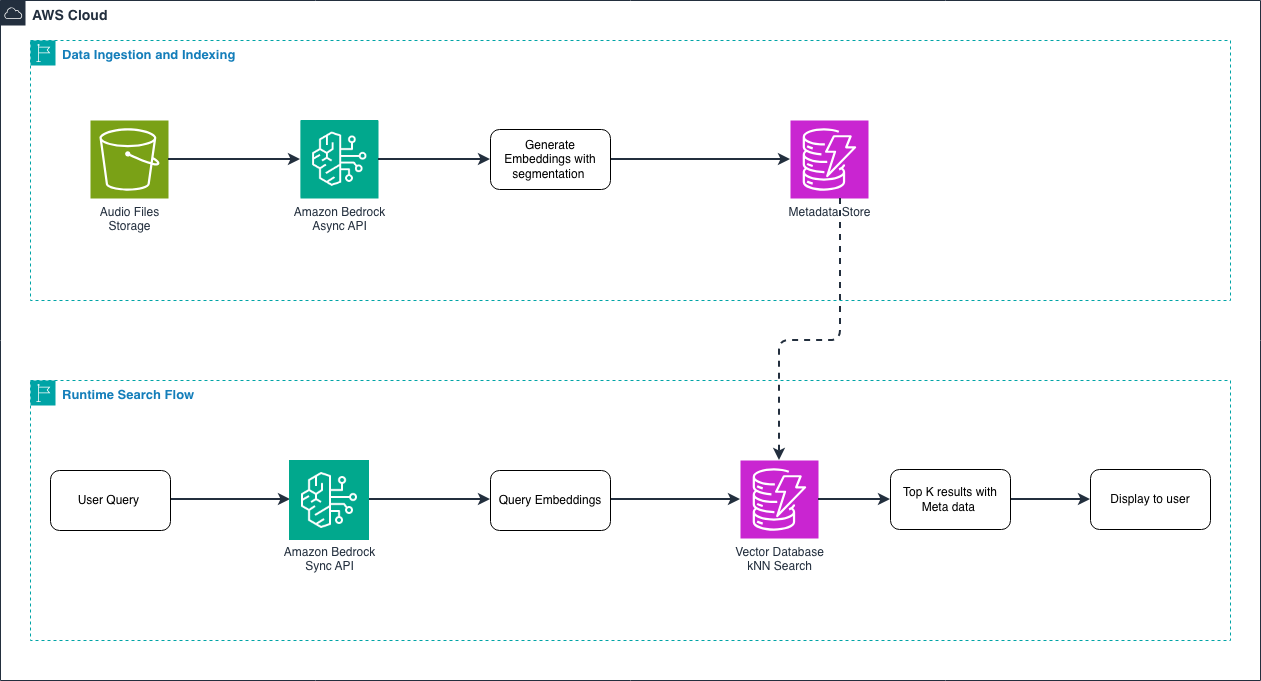
本文解釋音訊嵌入和 Amazon Nova 多模態嵌入,用於語意音訊搜尋。提供索引和查詢音訊庫的程式碼,實現生產就緒系統。
AWS Machine Learning Blog · 164 天前

X 推出由 Grok 驅動的自動翻譯功能,打破語言障礙。同時引入 AI 照片編輯器,使用簡單文字提示即可調整圖像。
Digital Trends · 164 天前

阿里巴巴的 HappyHorse 多模態模型即將發布開源權重,在 Artificial Analysis 擊敗 Seedance 2.0。支援文字轉影片、圖像轉影片及音頻,8 步推論達 720p。
Reddit r/LocalLLaMA · 164 天前
MedGemma 1.5 4B 在 MedGemma 1 基礎上擴展,支援高維醫學影像如 CT/MRI 體積與病理全切片,加上解剖定位與多時間點 X 光分析。它取得重大進展:3D MRI 分類提升 11%、病理 macro F1 達 47%,並改善臨床 QA 與 EHR 理解。
ArXiv AI · 164 天前
TRACE-KG 是一個多模態框架,從複雜文件建構上下文豐富的知識圖譜與誘導架構,而無需預定義本體。它透過結構化限定詞捕捉條件關係,並確保完全可追溯至來源證據。
ArXiv AI · 165 天前
OpenClaw 2026.4.5 為代理程式引入內建 video_generate 和 music_generate 工具,支援 ComfyUI、Google Lyria 和 MiniMax 等提供者。它移除舊版設定別名,並透過 openclaw doctor --fix 提供遷移支援,同時新增 12 種語言的多語系 UI。
OpenClaw (GitHub Releases) · 166 天前

展示使用 Gemma E2B 在 M3 Pro Mac 上實現即時音頻/視頻輸入與語音輸出,適合語言學習如對準物體拍照。模型支援多語言,可回退至母語。
Reddit r/LocalLLaMA · 167 天前

微軟推出 MAI-Transcribe-1 新語音轉文字模型。內部開發的 MAI-Voice-1 與 MAI-Image-2 首次廣泛提供給開發者商用。
GeekWire · 170 天前
智譜AI推出GLM-5V-Turbo,一款多模態模型支援視覺編程。使用者僅需一張手繪草圖,即可生成完整前端程式碼。
量子位 · 170 天前
阿里巴巴 Qwen 團隊推出 Qwen3.5-Omni,全模態 AI 模型。支援 113 種語言的語音辨識及 36 種語言的語音生成。
Pandaily · 172 天前

阿里巴巴在 Reddit r/LocalLLaMA 上發布 Qwen3.5-Omni 的基準測試結果。貼文分享模型效能細節。
Reddit r/LocalLLaMA · 172 天前
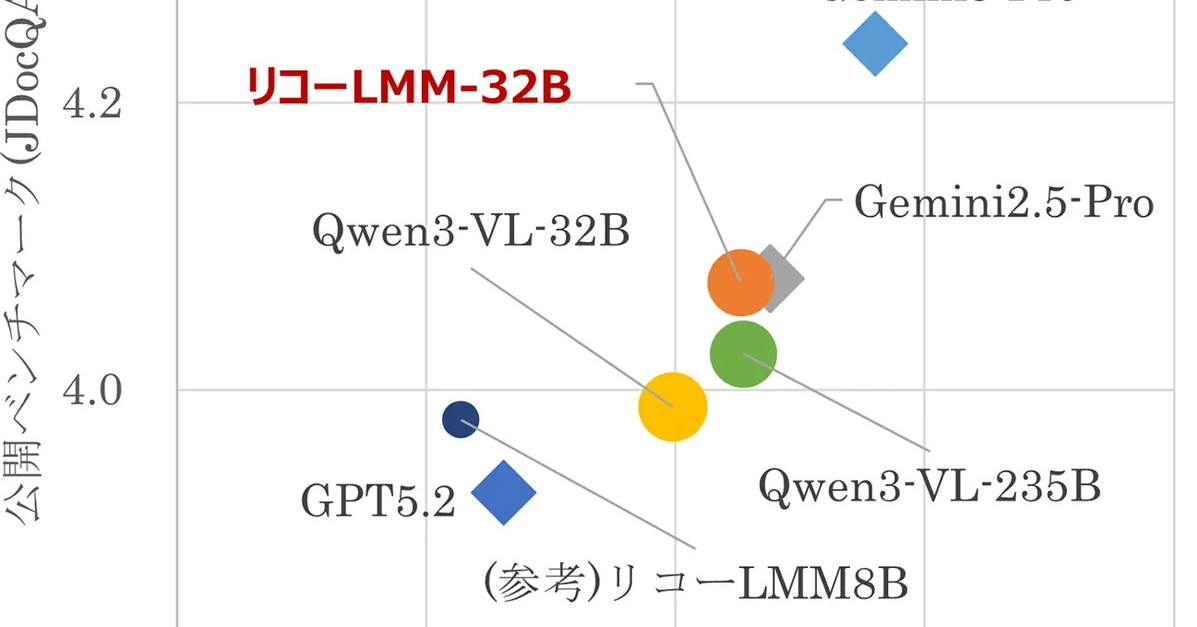
Ricoh 開發了 Qwen3-VL-Ricoh-32B-20260227,這是一款擁有 320 億參數的多模態 LLM,能以日語進行推論。宣稱性能匹敵 Gemini 2.5 Pro,並可讀解包含複雜圖表的日語資料。
ITmedia AI+ (日本) · 173 天前
美團開源了 LongCat-Next,這是一個真正的原生多模態模型。它將文字、視覺和音頻統一為單一架構中的 token,無需獨立的模態編碼器。
Pandaily · 173 天前

Meta 內部工具顯示 Avocado 變體正在評估中:9B 模型、多模態 Mango 代理、TOMM 工具模型、Thinking 5.6,以及純文字 Paricado。這暗示即將推出具代理與多模態功能的開源模型。
Reddit r/LocalLLaMA · 174 天前
天工AI在全模態領域領先後,進軍世界模型領域。國產玩家不再藏拙。
量子位 · 176 天前

深度機智為中關村學院與中關村人工智能研究院孵化首家具身智能企業,於3月27日中關村論壇發布PhysBrain 1.0。該模型採用人類學習範式與多模態大模型架構,將物理常識內化於參數中,具備物理世界理解的時空一致性。
36氪 · 176 天前
美團於3月27日發布並全面開源原生多模態大模型 LongCat-Next 及其核心組件——離散原生分辨率視覺分詞器 dNaViT。該模型打破以語言為中心的傳統拼湊式架構,將圖像、語音與文本統一映射為同源離散 Token。
36氪 · 176 天前
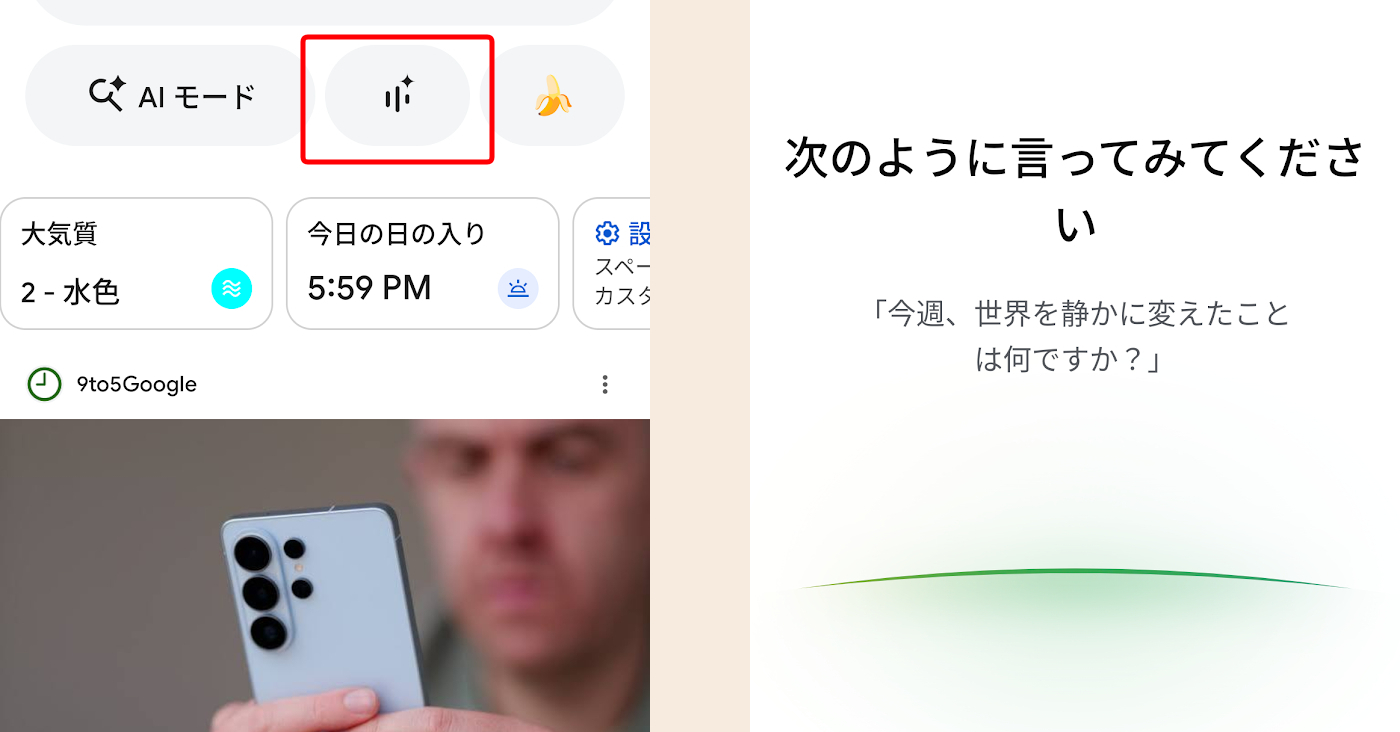
Google 在日本及所有啟用 AI 模式的地區推出「Search Live」功能。由 Gemini 3.1 Flash Live 驅動,可進行即時語音與相機互動,具備更好的音訊細微差別理解及情緒適應回應。
ITmedia AI+ (日本) · 176 天前

字節跳動推出 Dreamina Seedance 2.0 新一代多模態影片生成模型,已正式整合至 CapCut 影片剪輯應用。OpenAI 關閉 Sora 應用之際,字節跳動加碼消費級影片生成領域。
cnBeta (Full RSS) · 177 天前