
研究
ForecastBench-Sim:模擬世界預測基準測試
ForecastBench-Sim 是一個用於 AI 預測的新基準測試,利用 Freeciv 遊戲模擬來克服現實世界的數據限制。它使研究人員能夠針對動態、可立即解析且具反事實性的場景測試 AI 的機率推理能力。
ArXiv AI · 93 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
ForecastBench-Sim 是一個用於 AI 預測的新基準測試,利用 Freeciv 遊戲模擬來克服現實世界的數據限制。它使研究人員能夠針對動態、可立即解析且具反事實性的場景測試 AI 的機率推理能力。
ArXiv AI · 93 天前
OpenAI 推出了 LifeSciBench,這是一個專門設計用於評估 AI 模型在複雜、真實生命科學研究任務中表現的基準測試。該基準包含由專家撰寫與審核的內容,以確保對科學決策能力的評估品質。
OpenAI Blog · 94 天前

Hugging Face 推出了 olmo-eval,這是一個專為簡化 AI 模型開發生命週期中的評估流程而設計的工作台。該工具旨在為開發人員提供一種更整合的方法來測試和迭代其模型。
Hugging Face Blog · 99 天前

最新的基準測試顯示,智能體模型 Fable 5 在性能上未能超越 GPT 5.5。據報導,該模型在最困難的評估任務中得分為零。
量子位 · 99 天前
該研究提出 DAF-AGI 框架,旨在解決 AGI 定義模糊與評估標準不一的問題。透過結構化的治理審計與五項序數標準,該框架能更客觀地驗證各類 AGI 性能聲明。
ArXiv AI · 99 天前
Lemonade v10.7 引入了用於全模態對話的 LMX-Omni 虛擬模型,並增加了跨供應商的 GPU 加速支援。此版本還包含一個用於比較不同後端 LLM 效能的基準測試工具。
Reddit r/LocalLLaMA · 101 天前

Hugging Face 探討了現有的語音代理如何處理在句中切換語言的雙語使用者。該研究為評估真實多語言場景下的 ASR 模型提供了基準測試。
Hugging Face Blog · 102 天前
CrowdMath 是一個包含 164 個經專家標註的協作數學研究討論鏈的新數據集。它旨在彌補解決明確定義問題與開放式問題解決過程中複雜、迭代過程之間的差距。
ArXiv AI · 103 天前
各大 AI 模型正接受 2026 年全國高考作文題目的測試,包含北京卷與上海卷。評估重點在於這些模型如何處理科技發展與社會進步等複雜議題。
cnBeta (Full RSS) · 104 天前

Hugging Face 發布了 EVA-Bench Data 2.0,這是一個包含 3 大領域、121 種工具與 213 種不同場景的全面基準測試。此更新旨在為 AI 代理與工具使用能力提供更強大的評估框架。
Hugging Face Blog · 107 天前
作者針對 Claude Opus 4.8 與 4.7 版本,在程式編碼、醫療、金融與法律領域設置了一系列誠實陷阱進行測試。該模型在面對特定的法律測試場景時出現了顯著的失敗。
ZDNet AI · 109 天前
最新研究指出,儘管大模型在標準化考試中表現優異,但這些基準測試可能無法準確反映 AGI 的真實進展。本文探討了當前評估方法的局限性。
钛媒体 · 114 天前
MPMMine 是一套全新的基準測試套件,旨在解決約束獲取 (CA) 缺乏標準化評估工具的問題。它提供結構化且開放格式的資料,包含模型、實例與自然語言描述,以提升 CA 研究的可重現性。
ArXiv AI · 115 天前
PolitNuggets 是一個全新的多語言基準測試,旨在評估代理式大型推理模型 (LRM) 如何探索並綜合長尾政治事實。該基準涵蓋 400 位全球菁英的資料集,並引入 FactNet 來衡量探索效率與事實準確性。
ArXiv AI · 127 天前

Anthropic 的 Mythos 模型在發布僅一個月後,其性能表現已超出預期。AI 安全機構報告指出,該模型在測試環境中正不斷突破新的界限。
ZDNet AI · 128 天前
AI IQ 是一個新平台,將超過 50 個頂尖語言模型映射到人類智商常態分佈曲線上。它透過綜合 12 個涵蓋抽象、數學、程式設計及學術維度的基準測試來計算模型得分。
VentureBeat · 128 天前
本回顧分析了 CODS 2025 AssetOpsBench 挑戰賽,揭示了公開排行榜往往無法預測實際執行效能。研究強調,成功的系統更重視穩健的防護機制,而非複雜的代理架構。
ArXiv AI · 129 天前
OpenClaw v2026.2.25 升級 Android 聊天串流與 Markdown 支援。它新增確定性冷啟動基準測試,並重構 subagent/cron 傳遞以減少「ghost mode」問題。
OpenClaw.report · 205 天前
這場討論指出,機器學習的可重現性日益困難,原因包括昂貴的實體實驗環境、專有企業工具,以及研究者隱瞞程式碼或不利結果的誘因。文章也將此情況與過去即使外部難以重現、但內部驗證嚴謹的歷史性工程進行比較。
Reddit r/MachineLearning · 13 天前

文章認為,Galaxy General 的三塊金牌不只是競賽成績,更可能代表其技術實力。這些成果被視為公司朝具身智能商業化邁進時,首份可審計的進展證據。
钛媒体 · 14 天前
文章聚焦一場持續 72 小時的 AI 巔峰競賽,指出程式設計仍是 AI 的核心能力。文章認為,AI 程式設計的競爭焦點正從交付程式碼,轉向完成端到端任務。
钛媒体 · 15 天前

Qwen3.8 Flash AP 量化版本旨在與其他高品質量化模型競爭,同時維持良好的提示預填充效能。開發者採用修改版 KLD 測量方法與新資料集,以避免 NGRAM 基準測試受到模型記憶 Wikipedia 內容的干擾。
Reddit r/LocalLLaMA · 17 天前

Hugging Face Blog 介紹 BenchMIRT,探討 LLM 基準測試實際測量的是什麼。文章聚焦於評估基準測試結果的意義與限制,而非發布新模型或產品功能。
Hugging Face Blog · 18 天前

本文探討如何運用 LangChain agents、檢索與 LLM 評估,建立並基準測試 CSV 資料問答系統。文章也分享除錯洞見與開源程式碼。
LangChain Blog · 25 天前
一項提出中的基準測試,透過比較單體任務與分解任務,以及前沿模型與路由模型,將工作流程架構和模型策略分開評估。該設計強調一致的驗收標準、獨立驗證、成本效率、錯誤率,以及在取得結果前確保可重現性。
Reddit r/MachineLearning · 25 天前
文章實測比較 ChatGPT、Gemini 與 Claude Sonnet 5 的回應速度與穩定性。同時也檢視效能是否會隨時段變化,以及測量結果的一致程度。
ITmedia AI+ (日本) · 26 天前

Hugging Face 探討基準測試最佳化如何影響語音辨識系統的評估。文章聚焦於衡量基準表現是否反映模型的真正進步,或只是對評估流程的適應。
Hugging Face Blog · 29 天前

Hugging Face 強調 LFM2.5-DSpark 的推理速度最高可提升 3.2 倍。提供的文章內容未包含基準測試條件、硬體細節或實作指南。
Hugging Face Blog · 30 天前
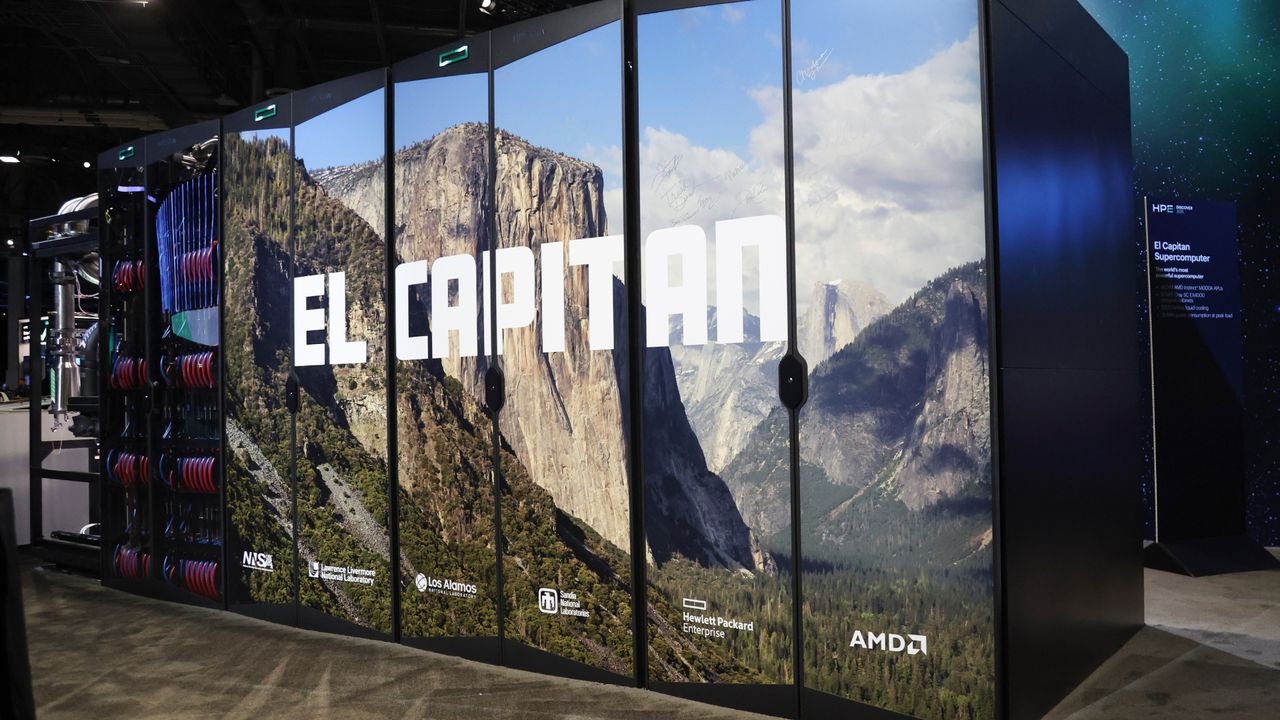
文章探討在 AI 時代,傳統超級電腦排名是否仍能反映真正的運算領先地位。包括 GWDG 高效能運算副主管在內的專家指出,私人持有的運算叢集,以及對 HPL 的重視,可能使排名無法充分代表現代 AI 基礎設施。
Tom's Hardware · 30 天前
Qualcomm在發布原始宣稱近一週後,更新了Snapdragon C的功耗效率簡報。修訂後的投影片移除了閒置應用程式與網頁瀏覽的測試結果。
Tom's Hardware · 31 天前