編程
Qwen Code 在 SWE-bench 冒煙測試取得 100% 分數
Qwen Code v0.21.13 完成了隔離式 DSW EAS 網路與 watchdog 冒煙測試,成功解決唯一的 SWE-bench Verified 案例,取得 100% 分數。Terminal-Bench 2.0 執行雖已完成,但發生基礎設施錯誤,因此結果無法計分。
Qwen (GitHub Releases: qwen-code) · 31 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
Qwen Code v0.21.13 完成了隔離式 DSW EAS 網路與 watchdog 冒煙測試,成功解決唯一的 SWE-bench Verified 案例,取得 100% 分數。Terminal-Bench 2.0 執行雖已完成,但發生基礎設施錯誤,因此結果無法計分。
Qwen (GitHub Releases: qwen-code) · 31 天前
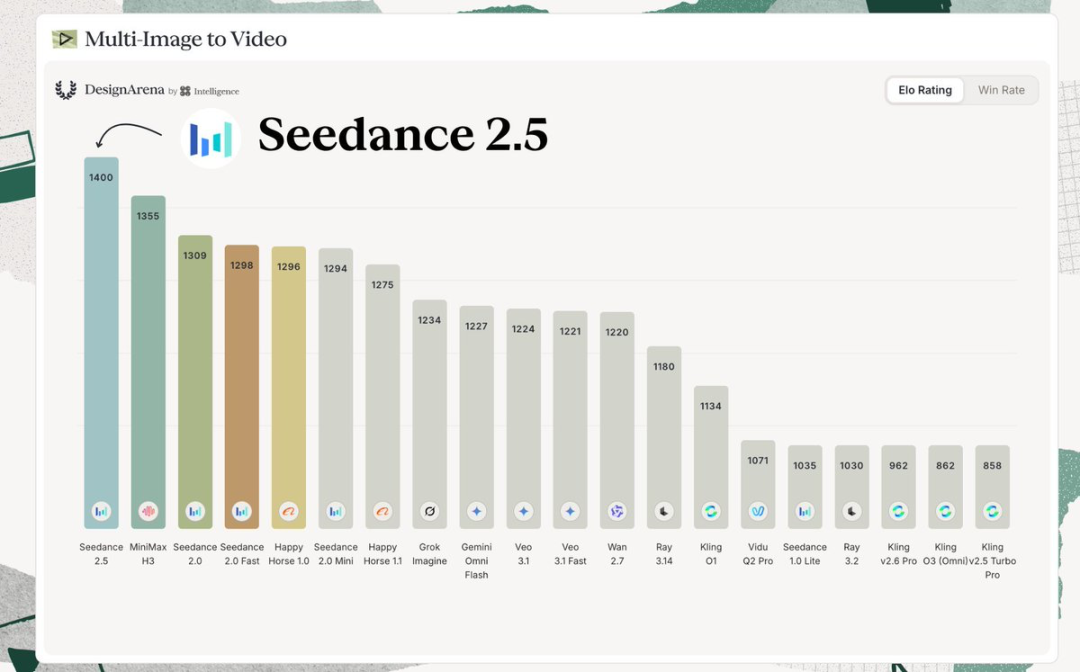
文章指出,MiniMax H3 正快速縮小與 Seedance 之間的差距。隨著模型能力迅速普及,Seedance 過去的領先優勢可能已所剩不多。
钛媒体 · 32 天前
一名研究人員批評某些評估做法,指出這些做法可能讓稀疏注意力與 KV cache 壓縮方法看起來比實際更有效。文章點出簡單的檢索任務、不對等的基準調校、有利提示詞,以及實作上的優勢,都可能扭曲比較結果。
Reddit r/MachineLearning · 33 天前

文章提出一套更嚴格的電商 AI 模型評測理念。方法是從真實使用者需求定義任務,並透過仿真環境中的狀態驗證結果,而不是接受「差不多」的表現。
Ifanr (爱范儿) · 33 天前
Qwen Code 發布 DSW EAS full E2E r3,重新執行完整的評測流程。流程涵蓋版本發布、DSW SWE-bench Verified(500 題)、Terminal-Bench 2.0(89 題),以及相同版本的發布作業。
Qwen (GitHub Releases: qwen-code) · 34 天前
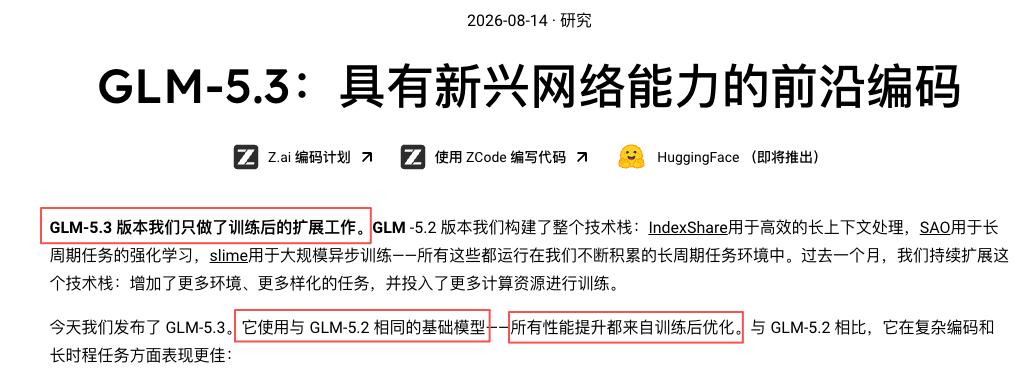
實測顯示,GLM-5.3 在測試中可能表現得像兩個不同的 AI 系統。它在不同能力面向上的表現並不均衡,但在安全性項目取得高分。
钛媒体 · 35 天前
代理技能 Ponytail 在貢獻者質疑原始評估後,修正了其基準測試結果。這起事件凸顯代理工具進行透明且可重現基準測試的重要性。
InfoQ中国 · 39 天前
Qwen 3.8-Max 的基準測試結果會因時間、Token 與推理強度上限不同而大幅變化。文章主張,實務團隊應以每個成功任務的成本評估模型,而非只看每 Token 價格或基準分數。
VentureBeat · 44 天前
社群討論關於託管雲端推論平台(如 Together AI)與自架 vLLM 實例之間的潛在效能差異。討論重點在於不同基礎設施配置下,貪婪解碼(greedy decoding)的結果是否保持一致。
Reddit r/MachineLearning · 67 天前
針對領先圖像生成模型的比較測試顯示,這些模型在提示詞遵循與創意輸出方面存在顯著差異。結果凸顯了不同架構在理解使用者意圖上的表現。
TechRadar AI · 68 天前

金融AI武道大賽正式開賽,包含四道真實業務難題。出題人表示,尋找最優解極具挑戰性。
量子位 · 80 天前
一位機器學習工程師正在尋求社群建議,探討比較雲端 GPU 供應商以進行 LLM 推論的最佳指標與方法。討論重點在於如何平衡成本、吞吐量與可靠性。
Reddit r/MachineLearning · 88 天前
討論評估 AI 生成的外銷銷售電子郵件及後續郵件的挑戰。現有指標如回覆率、準確性和編輯時間無法完全捕捉真正品質。
Reddit r/MachineLearning · 141 天前
開發者打造基本混亂猴子框架,用於生產環境多代理系統測試,避免不良使用者體驗。框架需強化以用於基準測試。
Reddit r/MachineLearning · 155 天前
Reddit 貼文尋求 PyTorch 自訂 RL 演算法資源、在 Gym 基準測試對比基線。詢問程式碼優化、目錄結構、Docker、Mac/Linux 相容。
Reddit r/MachineLearning · 165 天前
Meta 測試其最新 AI 用於內容審核,發現其表現優於人類,儘管僅在先前糟糕的系統上略有改善。企業工具長期偵測到如不可能登入等問題,但人類審核員未能察覺。
The Register - AI/ML · 183 天前
一名學生研究者正在一個推理密集型基準上評估前沿模型,包含900個問題。先導測試顯示高成本:Gemini 3.1 Pro 平均輸出約30k 個 token,GPT 5.2 運行約15分鐘。
Reddit r/MachineLearning · 201 天前
Qwen Code v0.21.14 成功完成一項 SWE-bench Verified 任務及一項 Terminal-Bench 2.0 任務。兩項基準測試均取得 100% 分數,且沒有未解決案例、執行錯誤或基礎設施故障。
Qwen (GitHub Releases: qwen-code) · 30 天前
Qwen Code v0.21.13 成功完成一項 SWE-bench Verified 任務與一項 Terminal-Bench 2.0 任務。兩項基準測試皆取得 100% 分數,且沒有未解決案例、執行錯誤或基礎設施故障。
Qwen (GitHub Releases: qwen-code) · 33 天前
Qwen Code 發布涵蓋 SWE 與 Terminal-Bench 工作流程的單案例端到端冒煙測試。此更新修正了 Terminal-Bench verifier proxy 前置內容的跳脫問題,並確保只有在 SWE 成功發布後才執行 Terminal-Bench。
Qwen (GitHub Releases: qwen-code) · 35 天前
Qwen Code v0.21.12 使用 qwen3.7-plus 模型,對 SWE-bench Verified 與 Terminal-Bench 2.0 執行發布事件煙霧測試。兩項工作流程均標示為成功,但各自記錄一次基礎設施故障、未產生案例軌跡,也未發布任何分數。
Qwen (GitHub Releases: qwen-code) · 35 天前

一篇 Reddit 貼文介紹 Muse Glimmer 基準測試,指出該模型的能力略遜於 Qwen,但每項任務使用的 token 大幅減少。這顯示它可能在品質與效率之間取得不同取捨,但提供的文字未包含基準測試方法或分數。
Reddit r/LocalLLaMA · 40 天前
Tom's Hardware 推出 Bench 2.0,這是一款專為 Premium 訂閱者重新打造的基準測試分析工具。新版瀏覽器加入多項功能,讓基準測試資料更容易理解、篩選、排序與使用。
Tom's Hardware · 43 天前
此版本為臨時預發布版本,僅用於內部基礎設施測試。其目的在於驗證連接 GitHub Actions、ECS 基準測試工作節點與結果發布路徑的自動化流程。
Qwen (GitHub Releases: qwen-code) · 59 天前

AI 從業者正在討論 Qwen 與 Gemma 模型在基準測試效能上似乎陷入停滯或「僵局」,這引發了對評估指標有效性的質疑。
Reddit r/LocalLLaMA · 75 天前
一位 CVPRW 去噪挑戰賽的參賽者指出,主辦單位未能發布官方報告或在 NTIRE 頁面上公布結果。該使用者正在尋求關於這種缺乏透明度的情況是否在其他學術挑戰賽中也很常見的資訊。
Reddit r/MachineLearning · 94 天前
針對 iPhone、Samsung 與 OnePlus 設備,使用原廠與 Anker 充電器進行快充速度的比較測試。結果顯示廣告宣稱的速度與實際表現存在差異。
ZDNet AI · 95 天前
Reddit 討論批評 NeurIPS/ICLR 充斥 LLM 基準測試論文。專有模型每月更新,基準測試版本在發表前即過時。
Reddit r/MachineLearning · 190 天前