
模型
Karpathy 力推《魔戒》大模型評測基準
Andrej Karpathy 正倡議將《魔戒》作為評估大型語言模型的新基準。這項提議可用於測試模型處理及推理長篇複雜敘事的能力。
量子位 · 43 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
Andrej Karpathy 正倡議將《魔戒》作為評估大型語言模型的新基準。這項提議可用於測試模型處理及推理長篇複雜敘事的能力。
量子位 · 43 天前

一名 Reddit 使用者詢問 Mach-1 Additive 是否能以約十分之一的規模,達到 Qwen 3.6 35B 95% 的效能。貼文將此結果描述為可能具重大意義的效率提升,但未提供基準測試方法或驗證資料。
Reddit r/LocalLLaMA · 46 天前
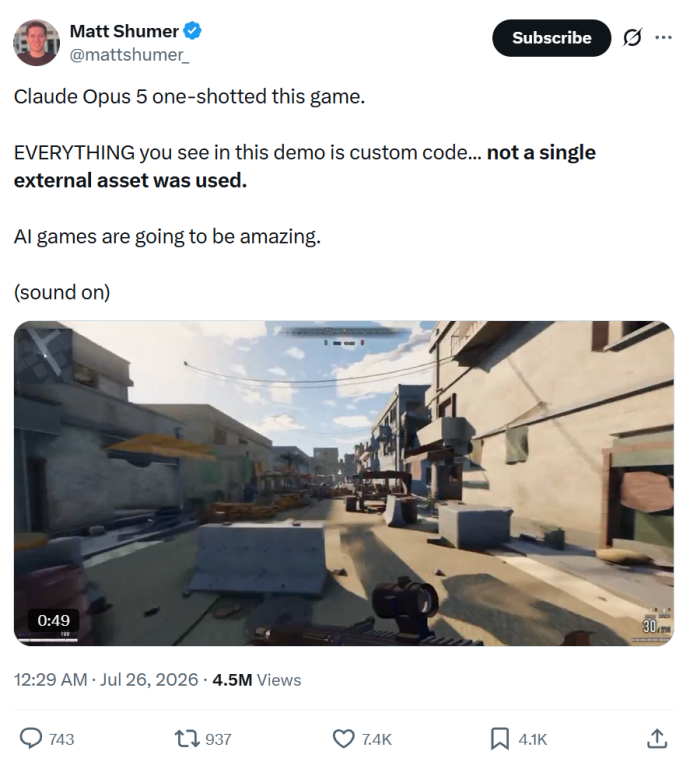
一項禁用外部工具的測試比較 Opus 5 與 GPT-5.6,並認為兩者的能力差距因此更加清晰。文章也指出,更強的原生推理能力可能降低傳統提示詞工程的重要性。
钛媒体 · 46 天前

這項研究提出以互動為核心的分類法,將 Agent 失敗定位到模型、Harness、使用者、工具、記憶體與環境之間的互動。其 41 種失敗模式可指出修復工作應歸屬於模型後訓練、Harness 工程、環境重新設計或基準測試修正。
ArXiv AI · 46 天前
本研究評估 LSR-Synth 能否區分真正的符號發現、方程式記憶與傳統運算子搜尋。研究發現,固定且不具語意的詞彙已能解決目前大多數任務;只有在刻意移除部分詞彙覆蓋範圍時,語言模型生成的候選項才會帶來顯著價值。
ArXiv AI · 47 天前
一名 Reddit 用戶指控一份品質低劣且內容荒謬的參賽作品,贏得了 DeepMind 與 Kaggle 舉辦的「邁向 AGI 之進展」挑戰賽 2.5 萬美元獎金。該評論對評審過程以及獲獎研究方法的有效性提出了質疑。
Reddit r/MachineLearning · 63 天前
本文探討使用「判斷預測任務」(即 AI 預測特定專家對主觀問題的回答)作為基準測試概念推理能力的方法。文中強調了在主觀領域中,相較於客觀基準數據集,判斷預測面臨著雜訊與意見分歧的挑戰。
AI Alignment Forum · 63 天前

Apple 研究人員推出了 Visual Concept Inference from Sets (VICIS),這是一項旨在評估視覺語言模型從少量圖像集中推斷共享概念能力的新任務。研究顯示,目前的頂尖模型在將這些視覺概念應用於新的、未見過的輸入時表現不佳。
Apple Machine Learning · 64 天前

Hugging Face 推出了 Real World VoiceEQ,這是一個旨在評估語音 AI 系統人類感知品質的新框架。它旨在為語音模型在現實場景中的自然度與品質提供更準確的基準測試。
Hugging Face Blog · 66 天前

NVIDIA 分析了 Nemotron Model Reasoning Challenge 的數據,該挑戰賽吸引了超過 5,000 名參與者探索提升推理準確性的技術。研究重點在於標準化基準測試與基礎架構如何揭示開源模型的有效優化策略。
NVIDIA Developer Blog · 67 天前
GPT-5.6-sol 模型正式進入 DRACO 評測榜單。該模型透過 OpenSquilla 整合方案,在 Brave 組別中展現了領先的品質與成本效益。
量子位 · 67 天前

本文強調維持在地化 AI 基礎設施與開源評測工具日益重要。主張應減少對中心化專有供應商的依賴。
Reddit r/LocalLLaMA · 68 天前

Google 全面翻新了 Android Bench 排行榜,並導入了全新的測試框架。此次更新加入了八款新的 AI 模型,旨在更精確地評估 Android 開發的編碼效能。
Digital Trends · 71 天前
Google 已更新 Android Bench 平台,納入更多大型語言模型。儘管有所新增,Gemini 在效能表現上仍落後於競爭對手模型。
Ars Technica AI · 73 天前
開發者指出在細粒度汽車分類任務中,DINOv2 使用 k-NN 的表現顯著落後於 SigLIP2。討論探討了 DINOv2 的自監督特性是否需要額外的訓練層,而非僅依賴原始嵌入進行檢索。
Reddit r/MachineLearning · 73 天前

Meta 在 AI 圖像生成排行榜上的排名有所提升,顯示其生成式模型能力取得顯著進展。此更新凸顯了 Meta 持續致力於與頂尖圖像合成模型競爭的決心。
The Neuron · 73 天前
CSTutorBench 是一個全新的基準測試,旨在評估小型語言模型 (SLM) 在 VEX VR 等區塊程式設計環境中作為導師的有效性。研究顯示,儘管模型在語氣和詞彙方面表現出色,但在避免洩漏答案和追蹤學生除錯歷史等教學任務上仍面臨挑戰。
ArXiv AI · 73 天前
Incognita 是一個旨在評估「社交分散式任務環境」中生成式代理的新框架,該環境中的知識會依角色進行劃分。它將社交互動與基礎執行分離,使研究人員能夠衡量代理如何獲取資訊並執行特定環境的操作。
ArXiv AI · 74 天前
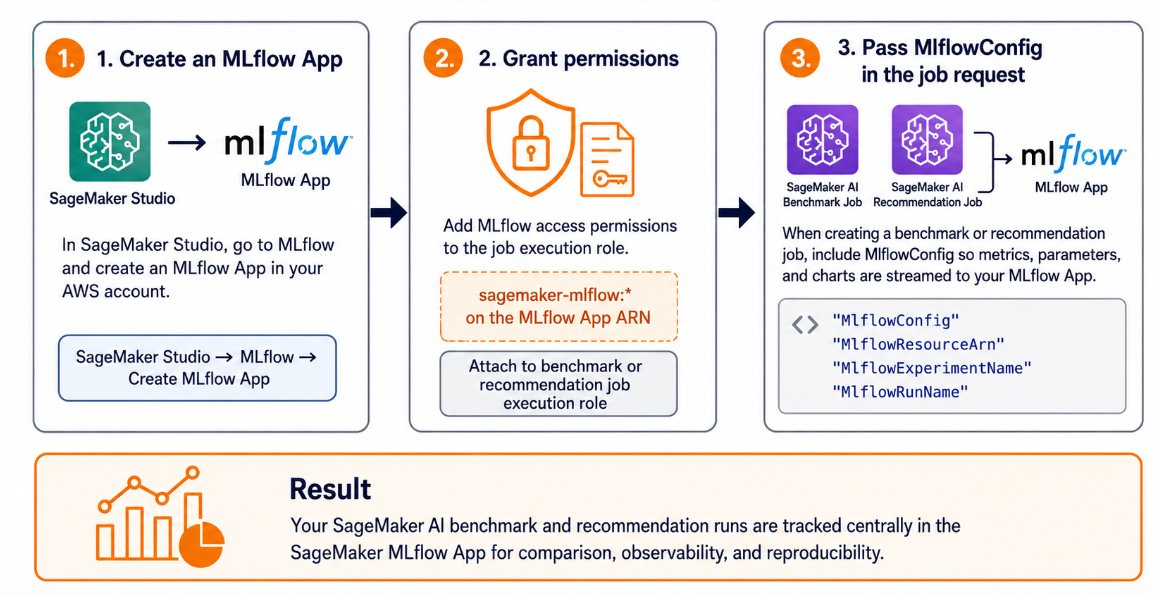
Amazon SageMaker AI 現支援將基準測試和推薦結果即時串流至 MLflow。這為實驗期間追蹤指標、參數和圖表提供了統一的介面。
AWS Machine Learning Blog · 75 天前
OpenSquilla 0.5.0 Preview 正式發布,並在 DRACO 基準測試中取得榜首成績。此次更新的對比清單中出現了最新的旗艦模型 Fable 5。
量子位 · 75 天前
兩家美國 AI 公司分別發布了調查報告,探討 Claude Fable 5 在暫停服務前後的性能是否發生變化,旨在釐清關於模型性能下降的疑慮。
ITmedia AI+ (日本) · 78 天前
Seed2.0 是一個旨在解決複雜、長跨度任務的新型模型系列,專注於長尾知識與指令遵循。它引入了一套基於真實用戶需求的可靠評估系統,以縮小基準測試與實際應用之間的差距。
ArXiv AI · 79 天前
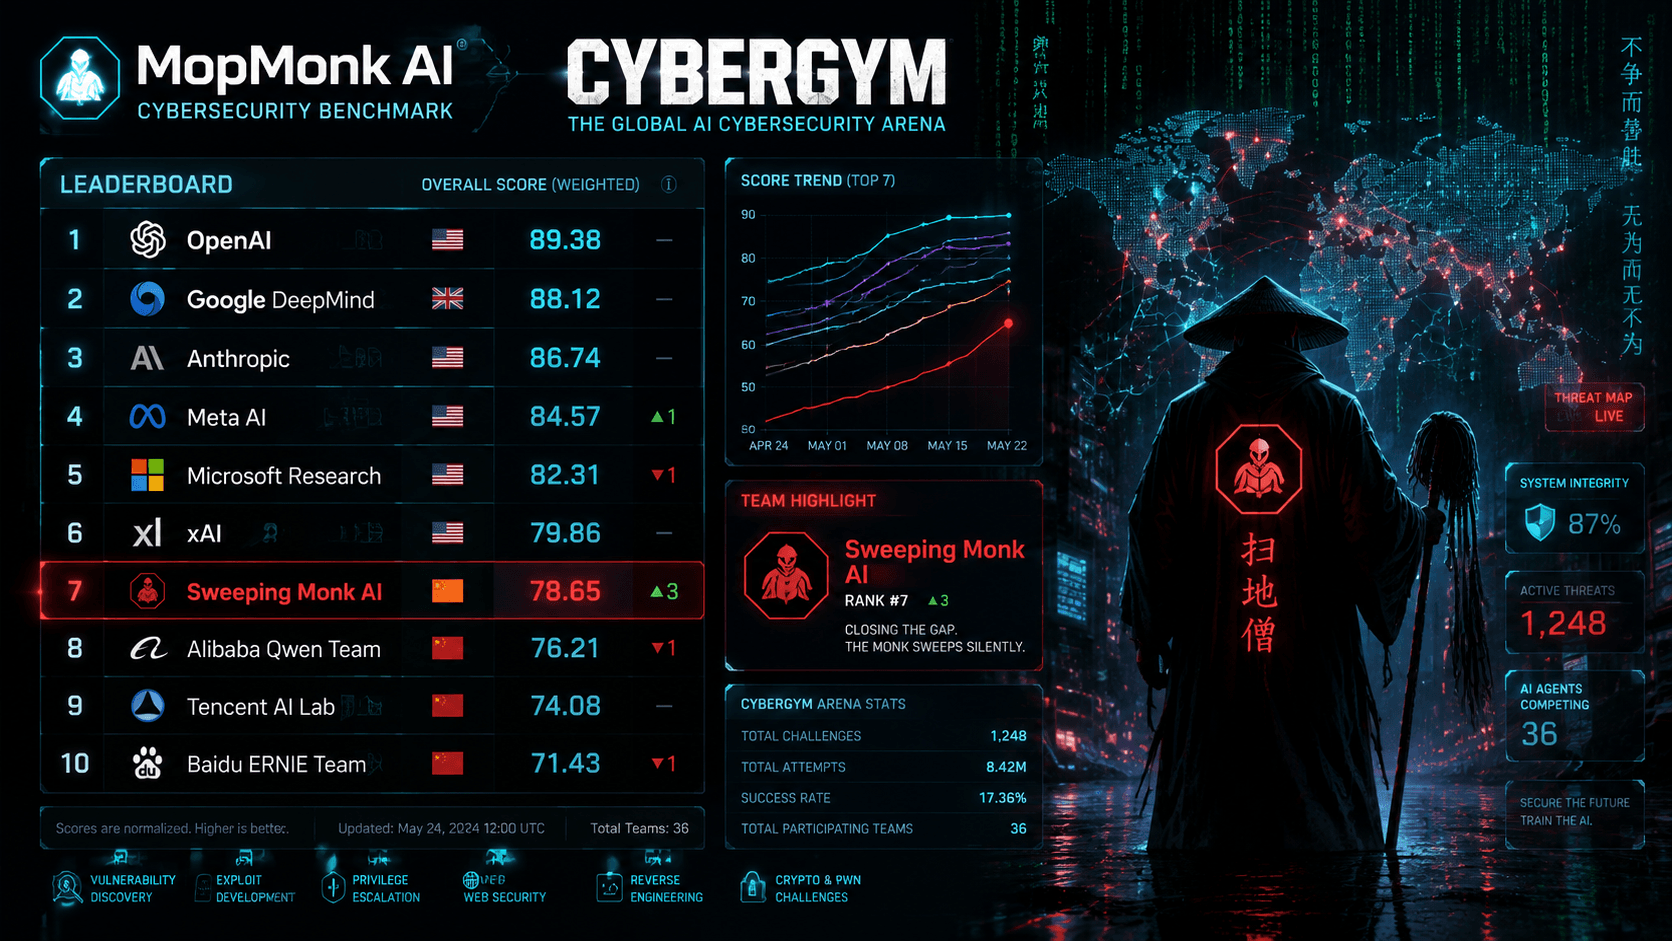
一個名為「MopMonk」的神祕中國 AI 研究團隊在 CyberGym 資安基準測試中躋身全球前七名。該團隊取得了 73.1% 的績效分數,凸顯了專業 AI 在資安任務中日益增強的能力。
Pandaily · 81 天前
中國信通院(CAICT)發布了業界首個針對 AI 基礎設施運維的評測基準。該框架目前支援針對五款主流國產 AI 晶片的效能與穩定性測試。
量子位 · 81 天前

Hugging Face 更新了模型頁面,現在可以顯示完整的評估結果。此項變更讓開發者能更輕鬆地直接在平台上比較各個模型的基準測試表現。
Hugging Face Blog · 81 天前
熱門 AI 排行榜 Arena 背後的初創公司已達到 1 億美元的估值。這一里程碑是在他們去年 9 月成功推出商業服務後達成的。
TechCrunch AI · 82 天前

ModelBrew 發布了專為機器學習模型中的即時持續學習所設計的新基準測試。此舉旨在解決在動態、真實環境中維持模型效能的挑戰。
Reddit r/MachineLearning · 84 天前
研究人員針對能源領域的工具增強型 LLM 代理提出了新的基準測試,涵蓋市場數據檢索、量化建模與決策分析。該研究針對 243 項專家策劃的能源任務,對開源與閉源模型進行了比較分析。
ArXiv AI · 85 天前

Hugging Face 推出了 FFASR 排行榜,旨在評估真實世界條件下的自動語音識別 (ASR) 系統。此舉旨在提供超越標準學術數據集的更準確性能評估。
Hugging Face Blog · 87 天前

Papers with Code 平台新增了 SOTA 徽章、基於 Hugging Face 資源的全新趨勢指標,以及對第三方評估結果的支援。這些更新旨在提升研究的可發現性,並提供更全面的模型效能檢視。
Reddit r/MachineLearning · 89 天前