SetupAI基建
基建
TurboQuant Pro:嵌入向量壓縮5-42倍
TurboQuant Pro 是一個開源工具包,可將高維向量壓縮 5-42 倍,同時保留 0.95+ 餘弦相似度。它在 240 萬個真實 BGE-M3 嵌入向量上基準測試 6 種方法,並與 pgvector/FAISS 整合。
Reddit r/MachineLearning · 163 天前
RAG 是企業把大模型用到自有數據上的主流路徑。這裡追蹤相關技術、工具與落地經驗。
142 篇文章
TurboQuant Pro 是一個開源工具包,可將高維向量壓縮 5-42 倍,同時保留 0.95+ 餘弦相似度。它在 240 萬個真實 BGE-M3 嵌入向量上基準測試 6 種方法,並與 pgvector/FAISS 整合。
Reddit r/MachineLearning · 163 天前
開源原型將 Unix 哲學應用於 ML 檢索管線,具可替換階段及類型合約,如 PII 遮罩與分塊。便於隔離變更精準評估比較。
Reddit r/MachineLearning · 173 天前
開發者分享在澳洲合規領域(如建築和礦業)部署 RAG 機器人的寶貴經驗。關鍵洞見包括查詢擴展優於區塊大小、來源提升、分層提示、本地嵌入,以及每個客戶獨立 VM。
Reddit r/LocalLLaMA · 174 天前

研究人員提出將微調與檢索結合,用於 LLM 代理以實現對未見任務的更好泛化。他們開發了優越的 LoRA 基礎 SFT 配方,並分析儲存、查詢和選擇的最佳檢索策略。
ArXiv AI · 183 天前

NVIDIA 推出 NeMo Retriever,這是一款超越傳統語義相似度方法的通用代理式檢索管道。該工具託管於 Hugging Face,能為 AI 系統提供更先進且適應性強的檢索功能。
Hugging Face Blog · 189 天前
Databricks 推出 KARL,一款透過強化學習訓練的 RAG 代理,能處理六種企業搜尋行為,並使用合成資料。於 KARLBench 基準測試中,其效能匹配 Claude Opus,但查詢成本降低 33%、延遲降低 47%。
VentureBeat · 198 天前
YuanLab.ai 正式開源發布 Yuan3.0 Ultra 多模態基礎大模型。它將 MoE 大模型訓練效率優化系統性引入模型結構設計,並針對企業應用進行深度優化。
36氪 · 198 天前
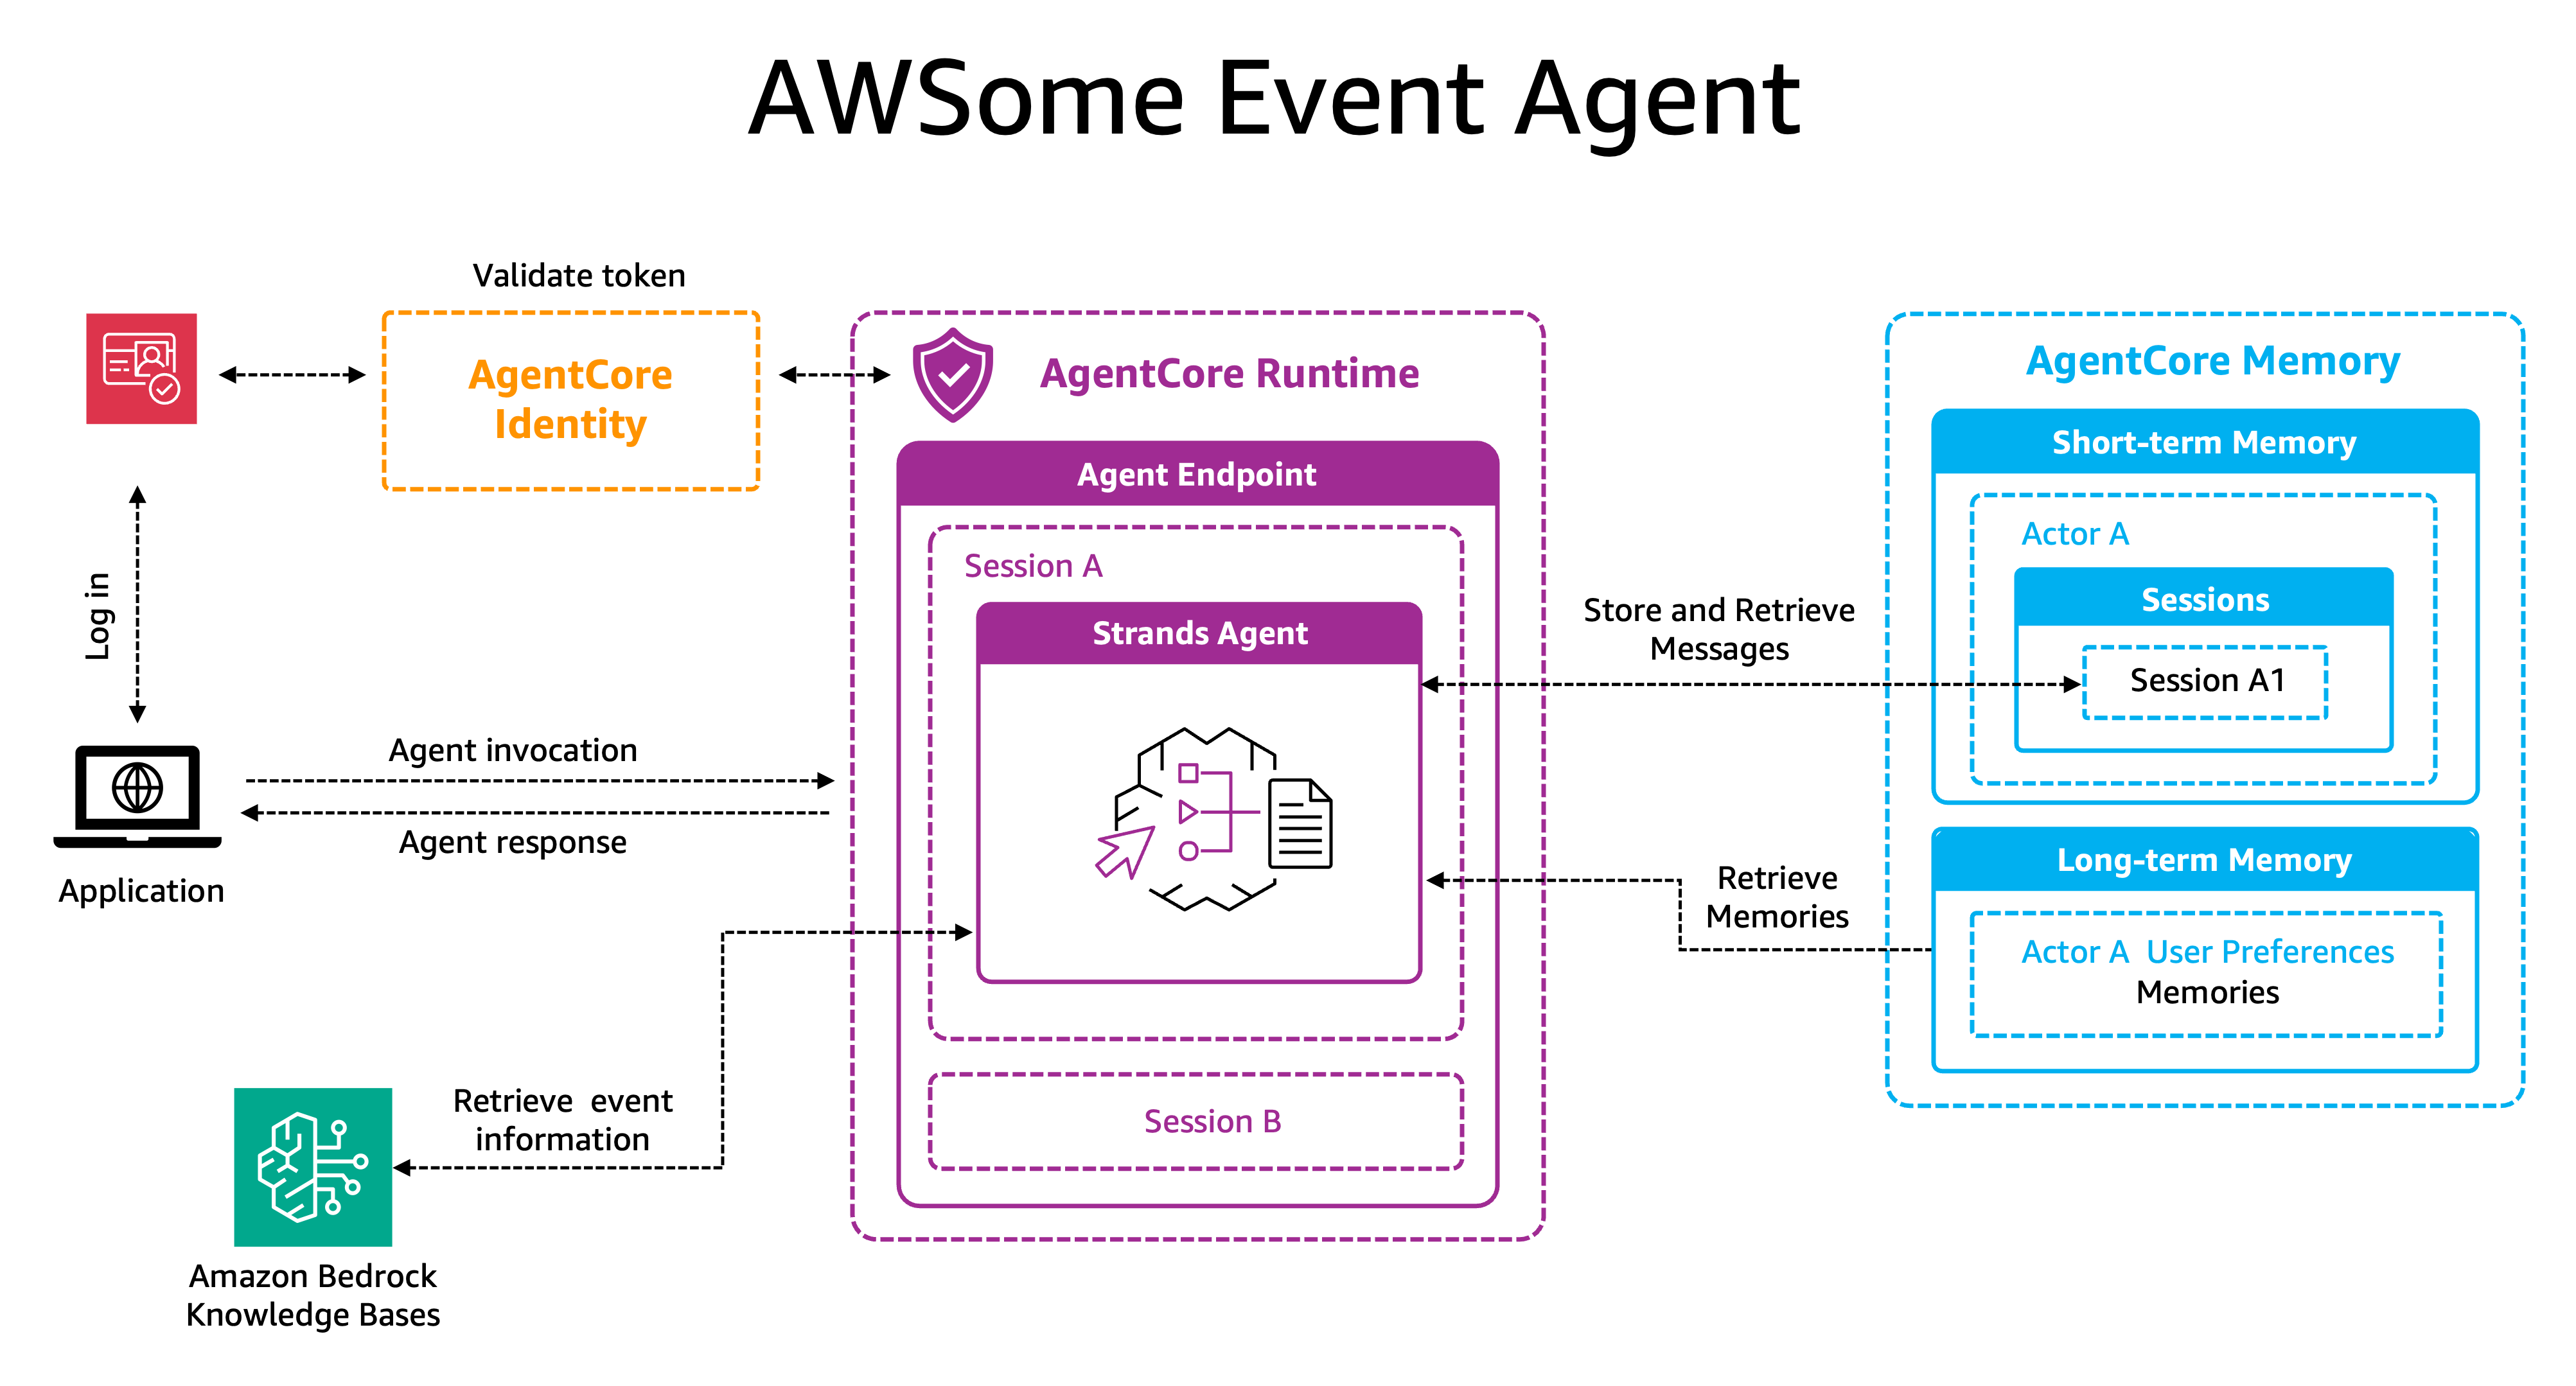
這篇 AWS 部落格示範使用 Amazon Bedrock AgentCore 元件快速部署生產就緒的活動助理。它處理對話脈絡與偏好記憶、安全認證、無伺服器擴展,並透過 Knowledge Bases 進行 RAG 以提供個人化與會者體驗。
AWS Machine Learning Blog · 205 天前
SurrealDB 推出 3.0 版,這款多模態資料庫以 Rust 原生引擎儲存代理記憶、向量、圖形與結構化資料,確保交易一致性。解決 RAG 系統中 Postgres、Pinecone 和 Neo4j 等工具的同步問題。
VentureBeat · 214 天前
embedflow 提出一種嵌入模型遷移方法:重新排序現有索引所取回的少量文件,藉此避免完整的向量回填。在涵蓋 63 次遷移、最多 100 萬份文件的測試中,Qwen 4B 升級至 8B 時,使用 50 份重新排序文件即可達到與原生檢索相當的品質。
Reddit r/MachineLearning · 11 天前
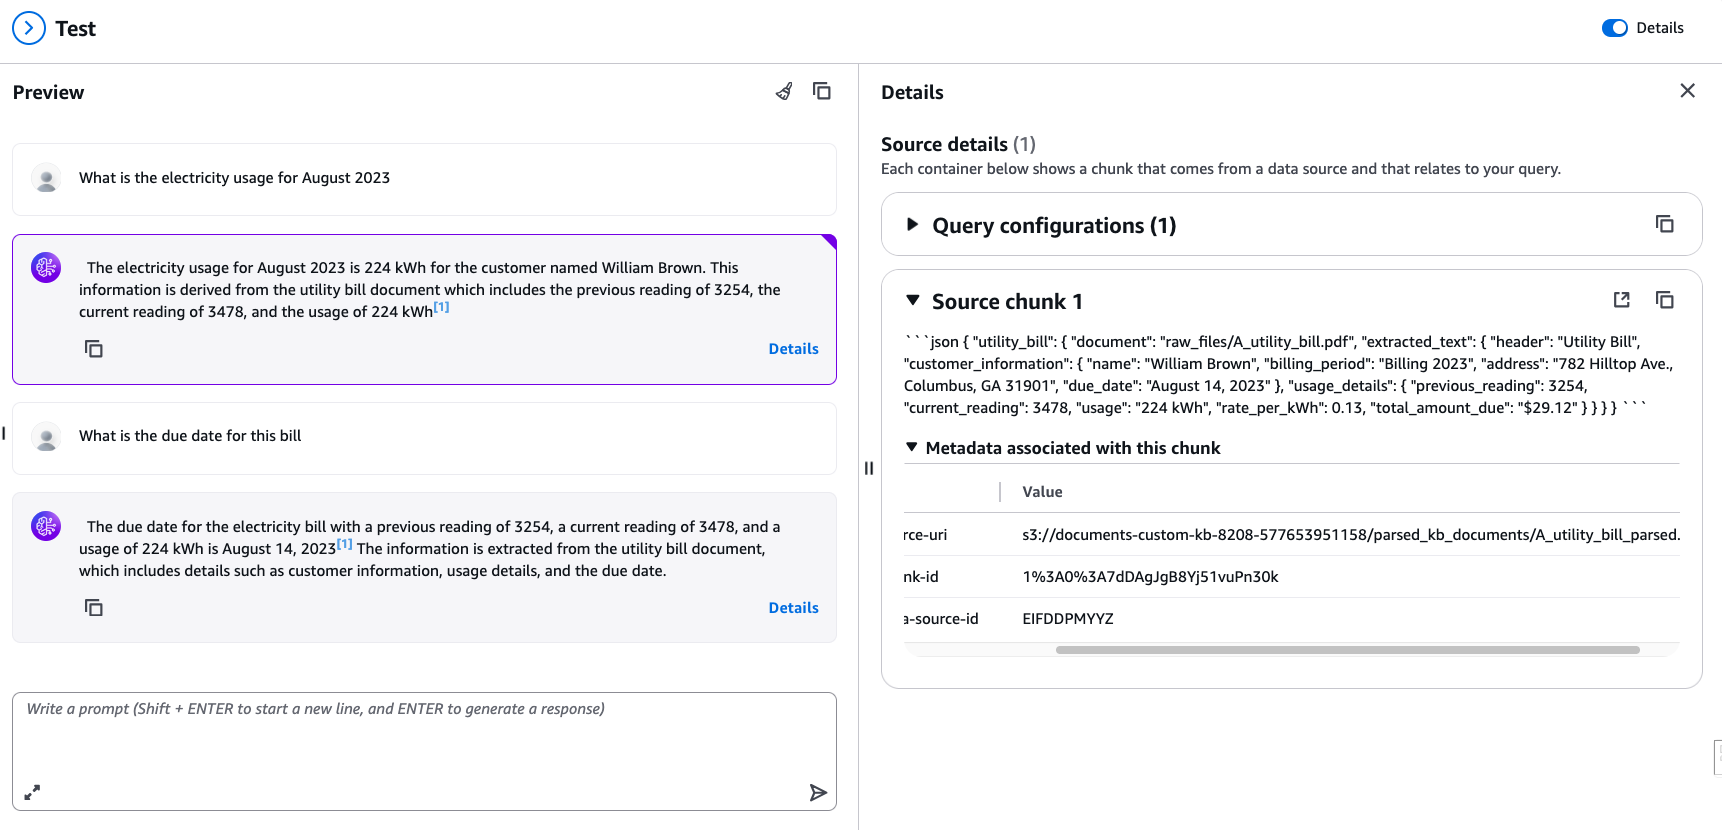
AWS 說明如何結合 Amazon Textract 的高準確度文字擷取能力,為大型且複雜的 PDF 與影像自訂 Amazon Bedrock knowledge base。此流程會先預處理並擷取文件,再大規模查詢水電帳單,以提升客戶互動的準確度。
AWS Machine Learning Blog · 15 天前
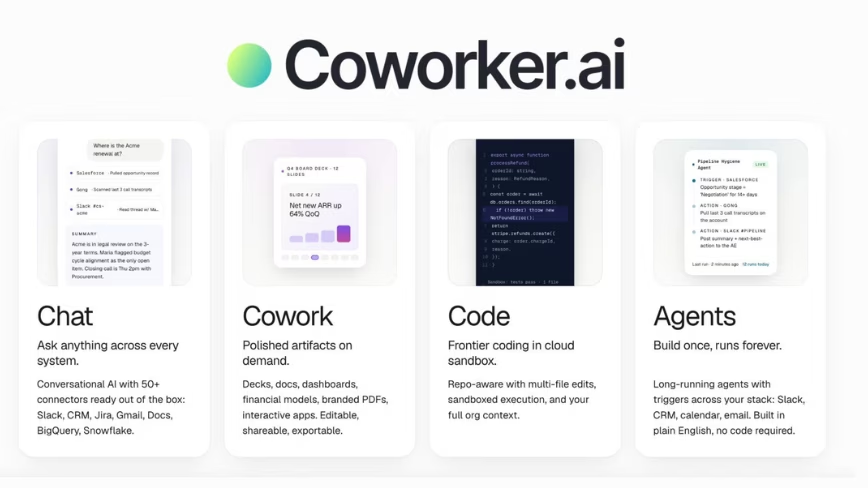
Coworker.ai 推出 OM2,這是一層組織記憶架構,旨在讓企業 AI Agent 持續存取相關公司知識。該產品希望減少重複載入上下文,並宣稱可將企業 AI 的 Token 消耗降低最多 9 倍。
The Next Web (TNW) · 16 天前
John Deere 推出 JD AI 助理,讓農民以自然語言詢問自家農機與田地資料。此次發布也包含十點式自願「農民資料承諾」,而歐盟使用者則受到 Data Act 多項相關義務保障。
The Next Web (TNW) · 17 天前
aimake 是一套面向 AI 與 ML 管線的增量建置系統,透過內容而非時間戳記追蹤相依性並建立輸入指紋。當提示或設定變更時,它會重用未變動的資料集、嵌入與索引,只重新建置過時的步驟。
Reddit r/MachineLearning · 18 天前
Weaviate 介紹一種晚期互動多向量檢索方法,用於理解 PDF 中圖表與表格的內容。此方法可根據頁面外觀搜尋文件,避開傳統 OCR、分塊與文字擷取流程。
Weaviate Blog · 18 天前
Qdrant 與 LangChain 強調適用於 LLM 應用的生產級 RAG 效能。此次更新聚焦於非同步支援、資源使用效率,以及可擴展的向量搜尋。
LangChain Blog · 24 天前
LangChain 推出靈活的檢索方法,協助開發者打造針對使用者資料的 AI 應用。開發者可使用語意或混合式 retriever,建立個人化的 ChatGPT 類體驗。
LangChain Blog · 24 天前
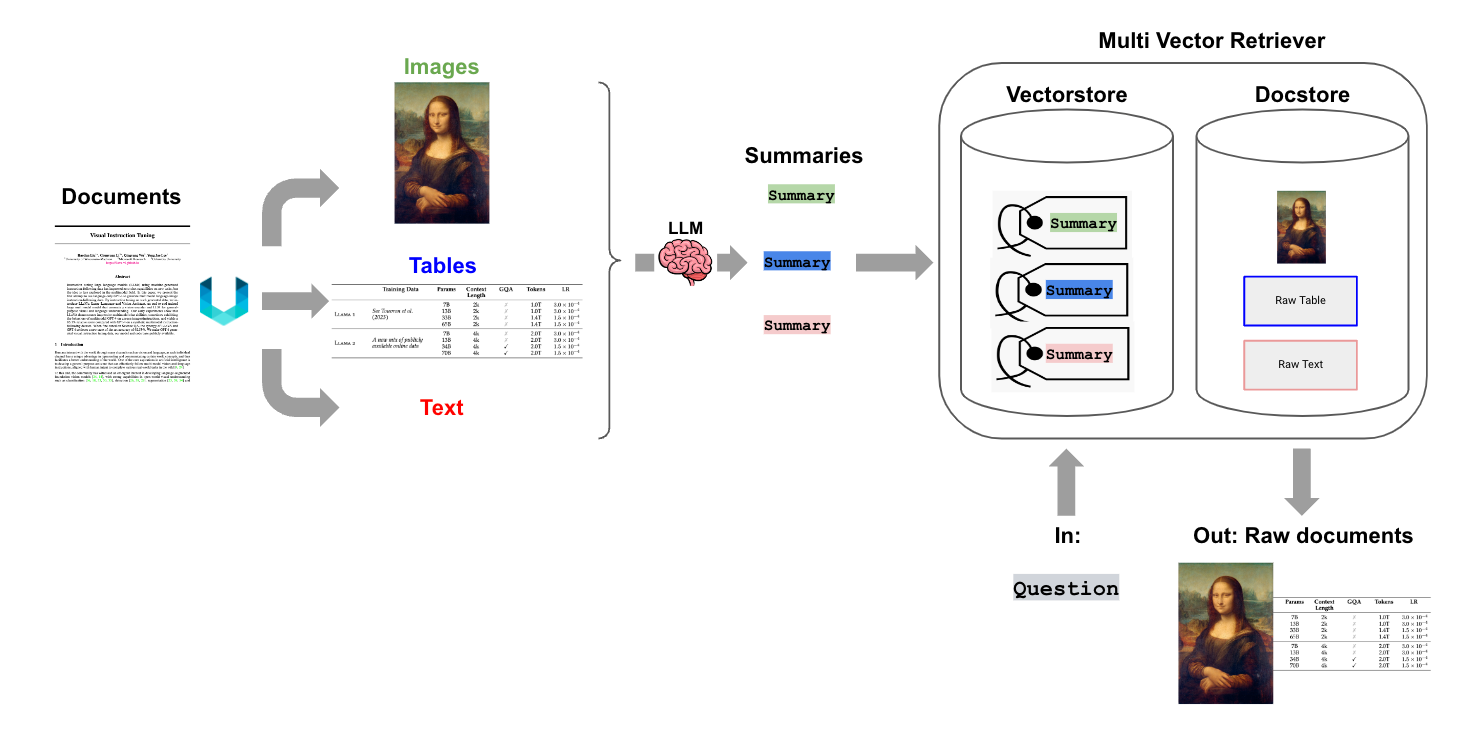
LangChain 提供使用 Multi-Vector Retriever 建立 RAG 系統的實作指南,支援表格、文字與圖片。相關 cookbook 涵蓋半結構化資料與多模態資料的檢索。
LangChain Blog · 25 天前
據報導,Amazon DynamoDB 開始原生支援 AI 搜尋,可能在部分架構中降低對獨立向量資料庫的需求。此更新可讓 AI 應用程式將搜尋能力更緊密地整合至主要資料庫,簡化資料技術堆疊。
InfoQ中国 · 27 天前
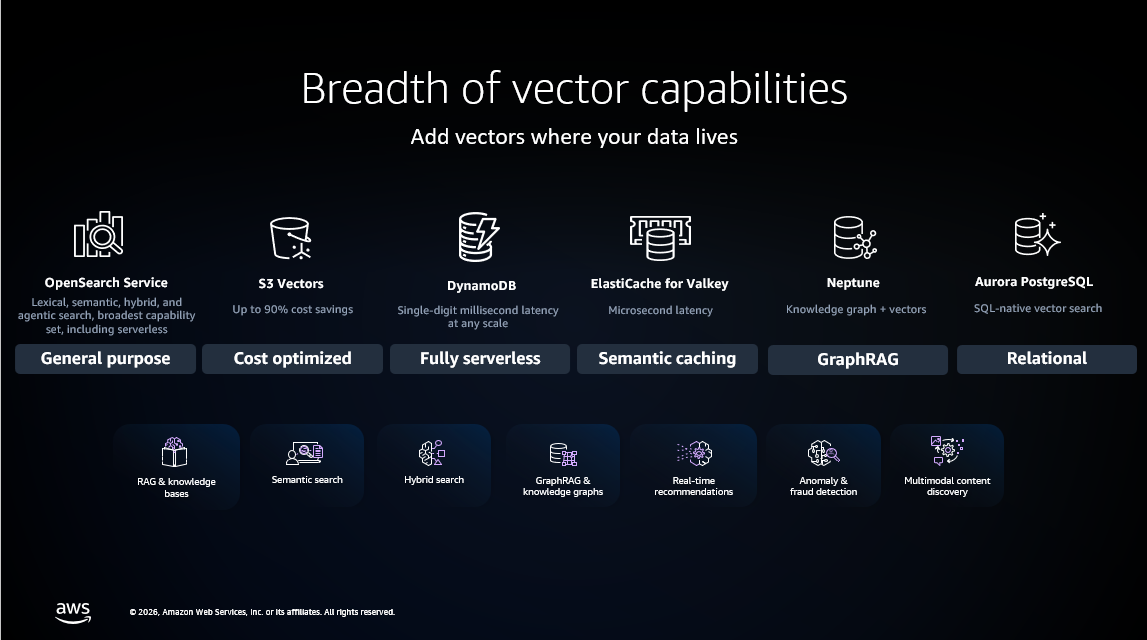
AWS 介紹整合於現有資料庫與儲存服務中的向量搜尋能力,無需額外部署獨立向量資料庫或遷移資料。文章比較六項專用服務,並提供選擇合適向量引擎的決策框架。
AWS Machine Learning Blog · 30 天前

Hugging Face Blog 介紹如何使用 Sentence Transformers 實作多向量(或晚期互動)嵌入模型。這種方法以多個向量而非單一嵌入表示輸入,能進行更細緻的相似度匹配。
Hugging Face Blog · 32 天前
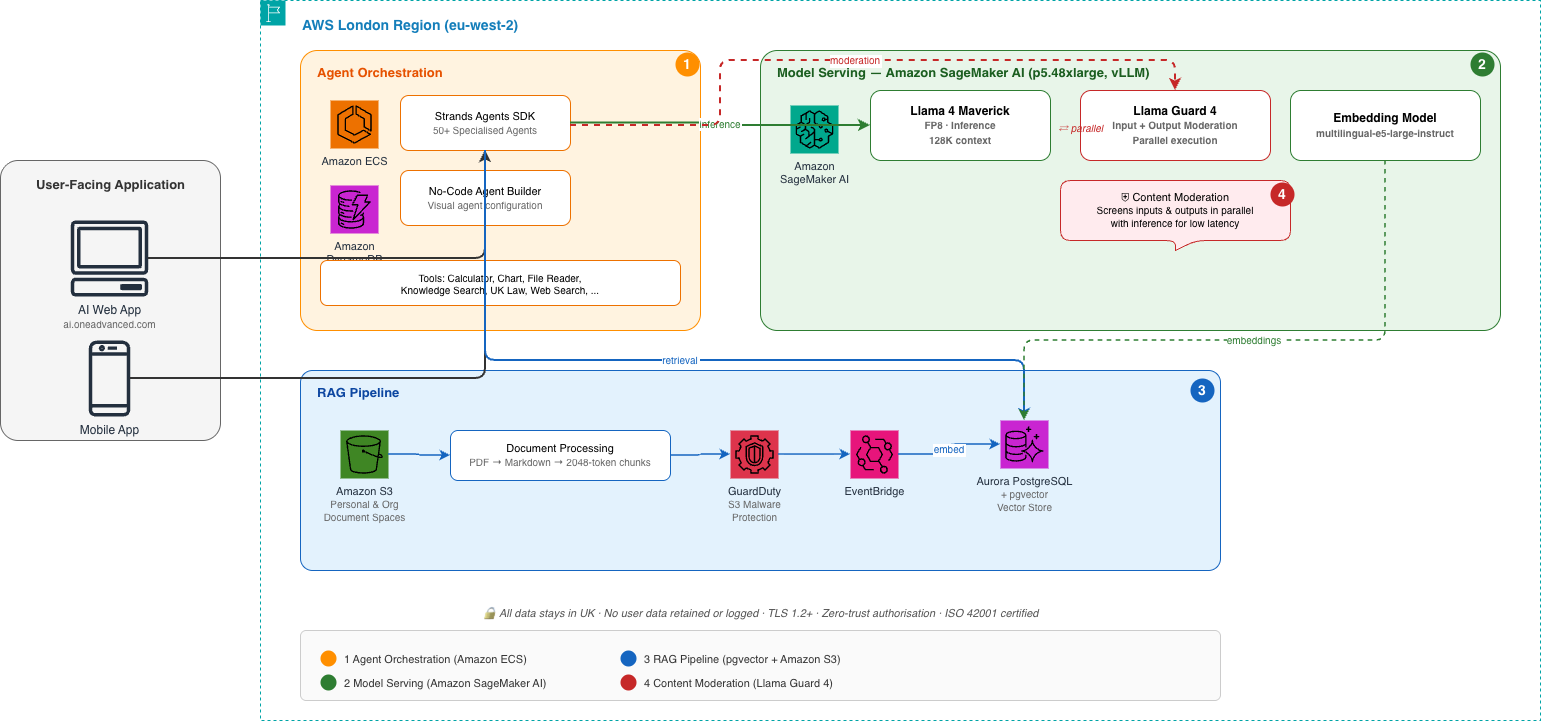
OneAdvanced 透過在 Amazon SageMaker AI 上自行託管 Llama 4 Maverick 與 Llama Guard 4,打造英國主權 AI 平台。其 RAG 管線採用 pgvector,並使用 Strands Agents SDK 在 Amazon ECS 上執行超過 50 個 AI 代理。
AWS Machine Learning Blog · 38 天前
作者提出了一種「本地優先」架構,由本地程序擔任閘道,在將請求發送至雲端模型前對敏感數據進行去識別化。此方法將雲端模型視為不可信的勞動力,旨在防止 LLM 在推理過程中洩漏私人記憶數據。
Reddit r/MachineLearning · 61 天前
本文探討目前的 AI 記憶體系統是否因過度專注於靜態事實檢索而受到限制,而非動態的模式推論。文章建議未來的架構應進化為能模擬使用者的推理風格與解釋框架。
Reddit r/MachineLearning · 65 天前

本文探討人類記憶結構如何啟發 AI 架構,特別是挑戰了關於記憶儲存與檢索的既有觀念。研究指出,記憶可以作為一個獨立的層級存在,而非僅僅深度整合於模型權重之中。
量子位 · 65 天前
作者分享了構建增量索引管道的經驗教訓,強調了在處理文檔刪除和部分更新時的關鍵失敗。文章指出,保持源數據與向量存儲之間的一致性是一項複雜的分佈式系統挑戰。
Reddit r/MachineLearning · 66 天前
VectorizationLLM 是一款基於 Google 開放權重 LLM 的專用模型,旨在協助工程系學生處理複雜的數學與計算分析。該模型採用 RAG 架構,能提供概念解釋與範例,但不會直接給出作業答案。
ArXiv AI · 71 天前
SoftBank 成功為 1.9 萬名員工部署了企業級 RAG 平台,在使用者便利性與企業安全性之間取得平衡。該專案大幅提升了營運效率,據估算節省了數萬小時的工時。
ITmedia AI+ (日本) · 71 天前
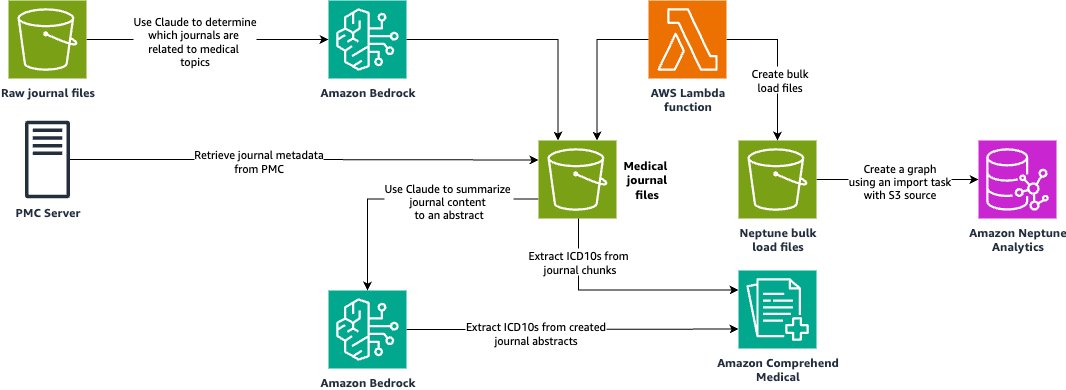
本文探討了將基於圖的檢索增強生成 (GraphRAG) 與知識圖譜相結合,以強化藥物研發。展示了結構化數據與生成式 AI 的結合如何提升研發速度與科學準確性。
AWS Machine Learning Blog · 73 天前

TripAdvisor 的 AI 生成評論摘要將不安全的飯店錯誤標記為「乾淨」與「友善」。這引發了人們對大型語言模型摘要技術在關鍵消費者決策中可靠性的擔憂。
Digital Trends · 79 天前