模型
Google AI Overviews 誤將同人小說內容視為事實
據報導,Google 的 AI Overviews 將 SCP Foundation(一個協作式同人小說項目)的條目呈現為真實記錄。這凸顯了 AI 在幻覺問題與來源驗證方面面臨的持續挑戰。
The Next Web (TNW) · 92 天前
RAG 是企業把大模型用到自有數據上的主流路徑。這裡追蹤相關技術、工具與落地經驗。
142 篇文章
據報導,Google 的 AI Overviews 將 SCP Foundation(一個協作式同人小說項目)的條目呈現為真實記錄。這凸顯了 AI 在幻覺問題與來源驗證方面面臨的持續挑戰。
The Next Web (TNW) · 92 天前

ACIE 是一個地端 Agentic RAG 管線,專為處理臨床環境中複雜的病患背景與跨文件依賴關係而設計。該系統在 7,326 次提取中獲得了 96.5% 的醫師認可率,證明了 Agentic 推理在醫療數據分類中的有效性。
ArXiv AI · 92 天前
CaVe-VLM-CoT 是一個新型代理式 RAG 框架,旨在透過五階段閉環驗證流程減少視覺語言模型的幻覺。該研究引入了 CaVeScore,這是一套用於評估檢索品質、引用忠實度及跨模態基礎性的綜合指標。
ArXiv AI · 93 天前
MemTrace 是一個新的基準測試,透過關注「知識點」而非單一問題來評估 LLM 的長期記憶。研究顯示,記憶失敗的主要原因在於對證據的利用不佳,而非檢索能力不足。
ArXiv AI · 94 天前
DivInit 是一種無需訓練的干預技術,透過多樣化初始查詢來提升 Agentic Search 的效能。藉由從單次模型呼叫中選取多樣化的種子查詢,該方法能減少檢索冗餘,並顯著提升多跳問答(multi-hop QA)的表現。
ArXiv AI · 94 天前

Meta 正在 Facebook 上推出「AI Mode」,讓用戶能直接向 Meta AI 提問。該功能會整合 Meta 生態系統中的公開內容,提供類似搜尋引擎的回答。
Digital Trends · 95 天前
Dr-DCI 是一個透過動態將相關文件提取至本地工作區來增強代理搜尋的新框架。此方法結合了基於檢索系統的可擴展性與直接語料庫互動的精確度,效能優於傳統搜尋方法。
ArXiv AI · 95 天前
一個使用 Django 和 React 建構的全端管線,透過從文本中建立知識圖譜來解決多跳推理問題。它結合了混合檢索、社群偵測與重排序技術以提升準確度。
Reddit r/MachineLearning · 96 天前
PixelRAG 是一項基於研究的新系統,它將網頁視為截圖而非解析為純文字。這種方法保留了視覺上下文與排版,相較於傳統基於文字的 RAG 流程,顯著降低了檢索錯誤。
VentureBeat · 99 天前
MediaLink 為姬路市急診醫院成功導入 AI 聊天機器人,並在兩週內達到 90% 的準確率。該專案強調了「知識循環」框架對於有效部署 AI 的重要性。
ITmedia AI+ (日本) · 103 天前

OpenAI 正在為 ChatGPT 部署一套重建的記憶系統,該系統會在背景中整合聊天記錄。此功能允許模型隨時間保留用戶背景資訊,目前已開放給美國的 Plus 與 Pro 用戶使用。
Digital Trends · 106 天前
CHARM 框架引入了一種系統性方法,用於檢測並減輕多步驟 Agentic RAG 流程中的連鎖幻覺。透過監控事實驗證與跨階段一致性,該框架能在無需更動架構的情況下顯著降低錯誤傳播。
ArXiv AI · 106 天前

Deep-Tech 的趙傑輝指出,企業 AI 技術棧正在發生轉變。那些僅用於修補模型短板的技術方案正被邊緣化,企業知識層與智能體層將成為新的核心。
钛媒体 · 109 天前
Grokers 引入了一種針對知識圖譜的由下而上架構,將智慧運算從查詢時轉移至寫入時。透過歸納式組合結構化屬性,它能為未來的互動實現零成本的語言模型查詢。
ArXiv AI · 109 天前
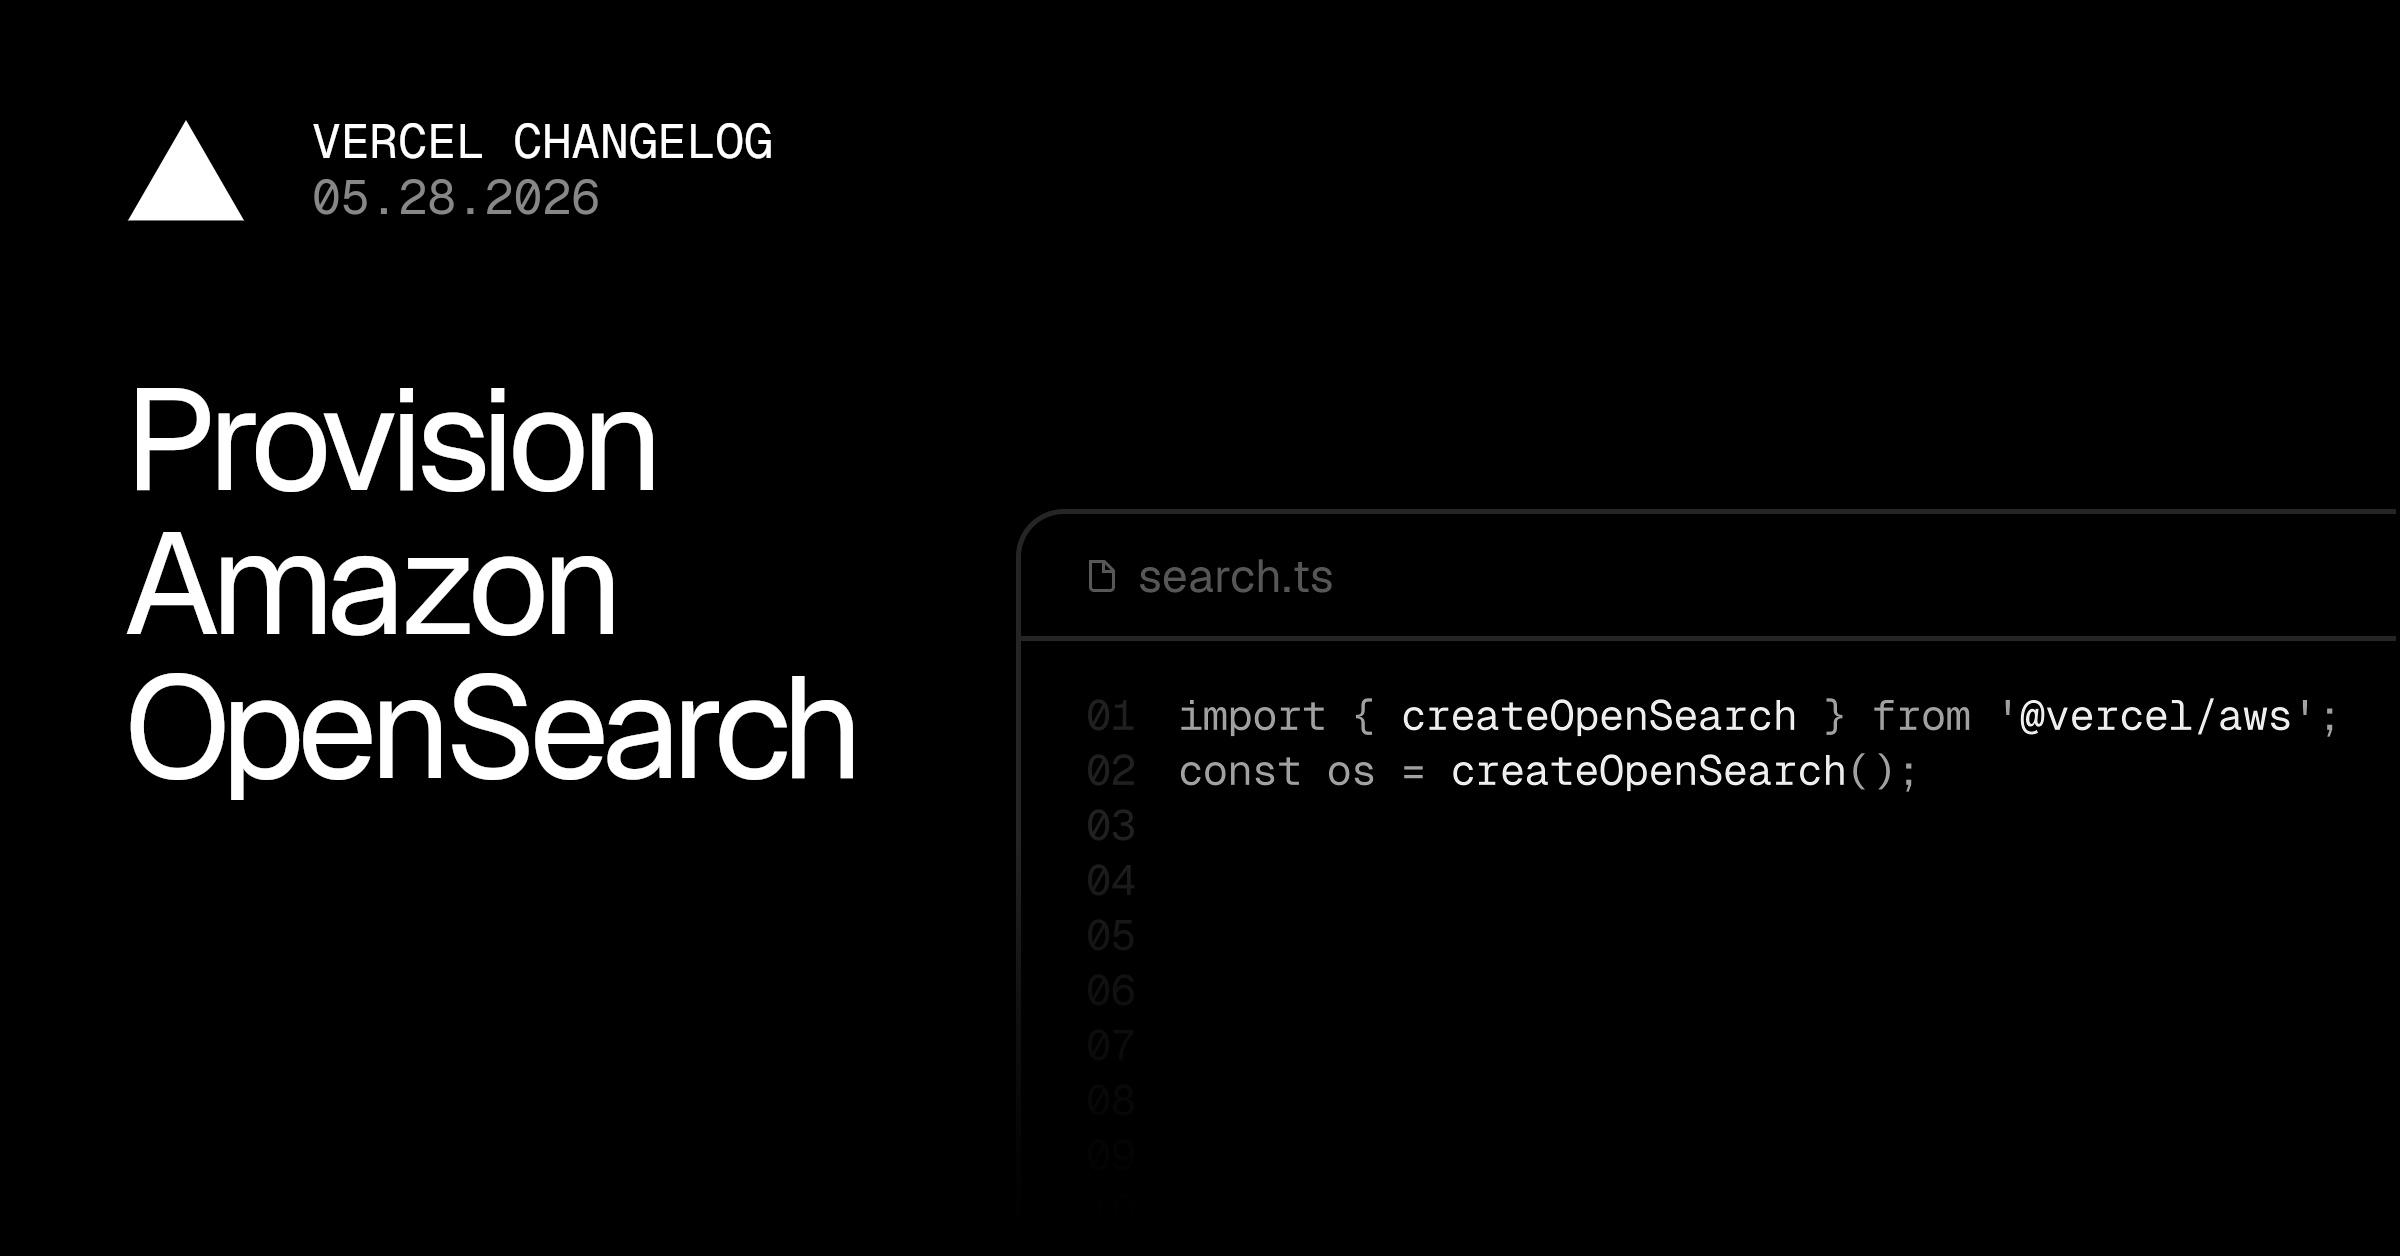
Vercel 將 Amazon OpenSearch Serverless 整合至其市集,為開發者提供簡化的搜尋基礎設施管理流程。此整合具備自動化專案配置、統一資源管理,並針對代理式 (agentic) 與向量搜尋工作負載進行了優化。
Vercel News · 114 天前
本研究介紹了 DeepTS 與 DeepScribe 兩種代理 AI 框架,旨在自動化科學數據整理與複雜講座分析。透過混合式「本地主體/遠端大腦」架構,這些系統提升了高能物理與時間序列研究的推理能力。
ArXiv AI · 115 天前

Firecrawl 現已登陸 Vercel Marketplace,讓開發者能將結構化網頁數據抓取功能直接整合至 AI 工作流中。此整合支援將網站內容轉換為 LLM 可用的格式,且無需自行維護抓取基礎設施。
Vercel News · 116 天前
EVE-Agent 引入了一種自我演化搜尋代理框架,確保訓練數據具備可驗證的證據基礎。透過根據來源證據帶來的邊際準確率提升來獎勵模型,該系統無需人工標註即可建立可審計且值得信賴的訓練循環。
ArXiv AI · 117 天前
研究人員開發了一套用於調查工作流程的五階段 LLM 框架,並推出了 A-TLM 模型,在災難相關數據集中表現優於傳統填補方法。研究證明,將 LLM 與因果知識圖譜結合可顯著降低偏差並提升數據品質。
ArXiv AI · 121 天前
RAG 架構僅能檢索資訊,卻缺乏決策背景,導致企業 AI Agent 在複雜任務中頻繁出錯。Rippletide 提出的決策上下文圖(Decision Context Graph)透過結構化記憶與時間感知推理,解決了 Agent 遺忘與決策邏輯缺失的問題。
VentureBeat · 122 天前

Google DeepMind 已敲定協議,將從 Contextual AI 引進超過 20 名研究人員並授權其技術。此交易包含 1 億美元的支付,且 Contextual AI 執行長 Douwe Kiela 將加入 DeepMind 團隊。
cnBeta (Full RSS) · 122 天前

騰訊發布了一款專為解決大型語言模型記憶問題而設計的開源插件。該工具旨在增強 AI 模型的上下文保留能力。
钛媒体 · 123 天前
MetaKGEnrich 是一個自動化管線,透過識別稀疏圖譜區域並檢索外部證據,使 LLM 能夠進行自我導向的知識修復。該系統結合了拓撲診斷與 GraphRAG,顯著提升了多項基準測試中的回答準確度。
ArXiv AI · 123 天前
這項研究引入了「合約綁定證據激活」(CBEA) 與「字典序承諾驗證」(LCV),以防止語言模型做出不可靠的承諾。透過限制證據範圍並驗證結構化輸出,該系統顯著降低了長文本與記憶密集型應用中的失敗率。
ArXiv AI · 123 天前
本文探討了企業環境中標準向量 RAG 的局限性,並提出了混合式「Graph RAG」架構。它強調在資料攝取過程中維護數據拓撲結構與關聯性,以提升 LLM 推理的準確性。
VentureBeat · 125 天前

IBM 發布了以 Apache 2.0 授權開源的 Granite Embedding Multilingual R2 模型。該模型在 1 億參數以下的規模中提供頂尖的檢索品質,並支援 32K 的上下文視窗。
Hugging Face Blog · 127 天前

用戶回報 Google AI 正在洩漏私人聯絡資訊,導致他們收到大量陌生來電。目前尚無簡單的機制能防止個人資料被這些模型曝光。
MIT Technology Review · 129 天前
分享使用 Tree-sitter 解析 AST 衍生類型圖形,用於程式碼庫 RAG,透過節點上的 BM25 檢索將上下文從 100K 降至 5K 令牌。圖形邊緣自動拉取依賴關係。
Reddit r/MachineLearning · 141 天前
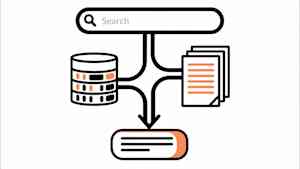
Databricks 研究顯示,多步代理在 STaRK 和 KARLBench 等基準測試中超越單輪 RAG 20%以上,適用於橫跨資料庫與文件任務。Supervisor Agent 拆解查詢、路由至結構化/非結構化來源並整合結果,解決 RAG 在混合資料的架構限制。
VentureBeat · 158 天前
turboquant-pro 推出 autotune CLI,從 PostgreSQL/pgvector 取樣嵌入向量,測試 12 種壓縮配置,在約 10 秒內依最小召回率推薦最佳方案。在 194K 生產嵌入上達 20.9 倍壓縮、96% 召回率,將 758MB 縮至 36MB。
Reddit r/MachineLearning · 163 天前