SetupAI研究
研究
HiDream 發布 HiDream-O1-Embodied 具身世界模型
HiDream.ai 宣布推出 HiDream-O1-Embodied 具身世界模型。此次發布代表公司正致力於完成原生全模態技術戰略閉環。
量子位 · 12 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
HiDream.ai 宣布推出 HiDream-O1-Embodied 具身世界模型。此次發布代表公司正致力於完成原生全模態技術戰略閉環。
量子位 · 12 天前
少數派報導了多項 AI 產品更新,包括 Google 發布 Gemini 3.8 Flash、World Labs 發布多模態世界模型 Atlas,以及 Alibaba 推出 Qwen3.8-Max-0902。文章同時提及理想新一代 MEGA 等其他產品動態。
少数派 · 16 天前
Google 低調推出 Gemini 3.8 Flash,這款模型基於 Gemini 3.7 Flash 升級,面向軟體工程、智能體任務與複雜知識工作流。它鎖定開發者與企業的大規模生產部署,兼顧品質、成本與延遲。
极客公园 · 16 天前
Google 推出 Gemini 3.8 Flash,專注於代理任務、軟體開發與多步驟推理,並同步發布用於漏洞發現與修補的 Flash Cyber。這些模型已透過 Gemini Enterprise 及多項開發者工具提供,輸入價格從每百萬 token 0.75 美元起。
VentureBeat · 16 天前

據報導,李飛飛團隊發布了 Atlas,並將其描述為全球首個多模態世界模型。Atlas 不只理解文字,也旨在透過少量照片理解空間環境,可能取代數百個拍攝機位。
Ifanr (爱范儿) · 17 天前
Vercel 已透過 AI Gateway 提供 Google 的 Gemini 3.8 Flash,支援 100 萬 token 上下文視窗及多模態輸入。該模型在 12 月 31 日前享有五折優惠,並以與前代相同的速度和成本提升軟體工程、代理工作流程及多步驟推理能力。
Vercel News · 17 天前

智譜開源了原生多模態模型 GLM-5.3-Flash,開發者可關注其在文字與視覺任務中的應用潛力。該消息收錄於少數派的科技新聞彙整,文中同時提及 Perplexity Portable Computer 與 BenQ Creative Pro PV50 系列顯示器。
少数派 · 22 天前

Tencent 的 WeChat Vision 團隊開源了 WeMM-Embedding,這是一系列可用於匹配文字、圖片、影片及其他內容類型的模型。這些模型已部署於多項 WeChat 服務,開源版本包含 2B、4B 與 9B 等規模。
TechNode · 23 天前
中國 Z.ai 以 MIT 授權釋出 GLM-5.3-Flash。這款多模態模型先前以「Ox Alpha」匿名接受驗證,宣稱可在中國製 AI 晶片叢集上,以更低成本提供接近 Claude Opus 4.8 的效能。
ITmedia AI+ (日本) · 23 天前

Alibaba 的 Qwen 團隊計畫於 8 月 26 日開源 Qwen3.8-Flash-Next 及其 FP8 版本。這款多模態混合專家模型採用下一代 Qwen4 架構,讓開發者能在完整 Qwen4 發布前提前了解其能力。
TechNode · 24 天前
Vercel 已將 Z.ai 的 GLM 5.3 Flash 加入 AI Gateway,讓開發者可透過統一 API 存取這款多模態模型。該模型支援文字與視覺輸入、函式呼叫、結構化輸出、串流,以及 100 萬 token 的上下文視窗。
Vercel News · 24 天前
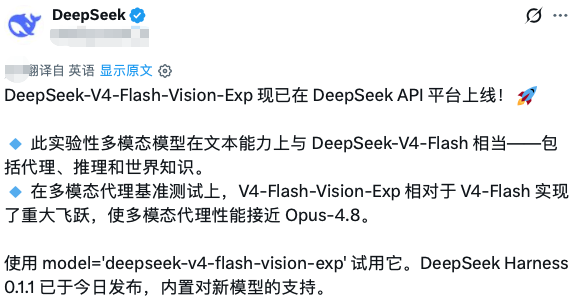
DeepSeek 透過實驗版 Vision-Exp 為 V4 Flash 加入原生圖片輸入,支援影像理解、視覺 Agent 與依照截圖進行程式開發。測試顯示它在場景描述與基本網頁重建方面表現不錯,但人物辨識不穩定、Token 消耗高,可靠性仍具實驗性。
虎嗅 · 25 天前

HiDream.ai 發布基於原生全模態 UiT 架構的互動式世界模型 HiDream-O1-World。模型支援文字、圖像與互動操控輸入,面向具身 AI 仿真、互動娛樂及 3D 場景生成等應用。
雷峰网 · 26 天前
BOCOM International 的分析認為,Moonshot AI 的 Kimi K3 位於成本與能力的 Pareto 前沿。其超大型上下文視窗與原生多模態設計,據稱能以大幅更低的單任務成本,提供接近頂尖閉源模型的效能。
Pandaily · 26 天前
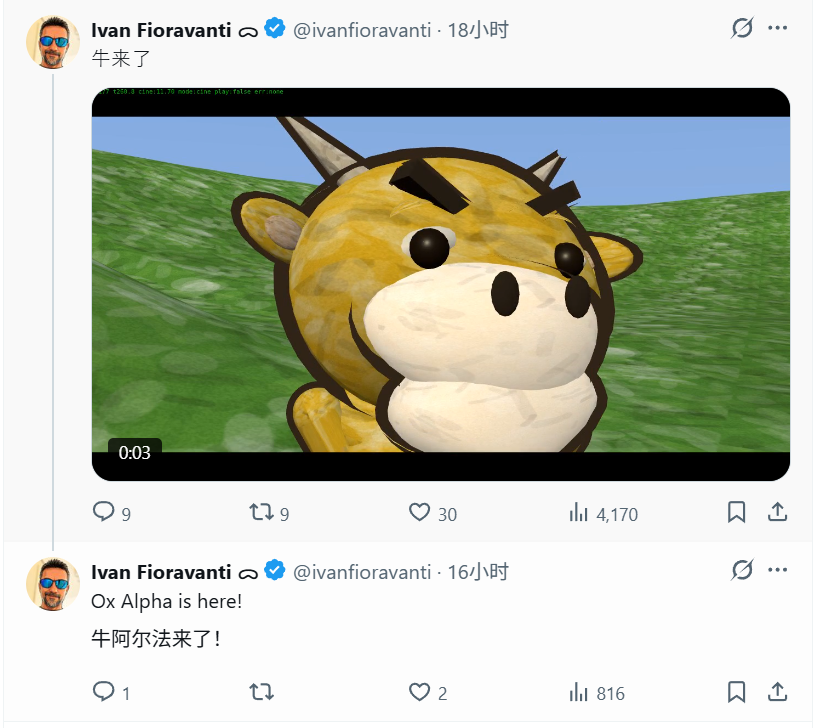
Ox Alpha 是一款透過 OpenRouter 與 OpenCode 提供的匿名模型,具備 100 萬 token 上下文、圖片與影片輸入、工具呼叫及免費使用等能力。早期測試顯示其推理與程式設計表現強勁,但開發者、參數量、訓練資料與正式基準排名仍未獲確認。
虎嗅 · 28 天前
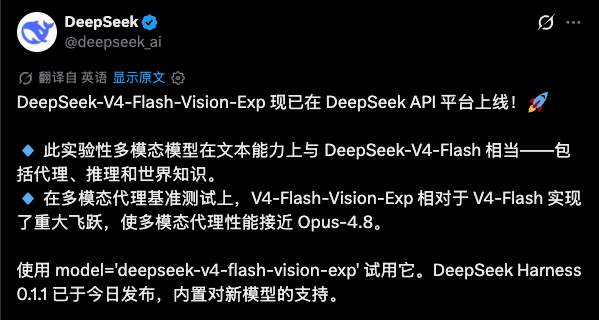
DeepSeek 發布了最新模型 DeepSeek-V4-Flash-Vision-Exp,核心聚焦於視覺能力。這項發布代表該公司在長時間醞釀後,終於推出多模態模型更新。
cnBeta (Full RSS) · 28 天前
DeepSeek 已在 API 平台推出 V4-Flash-Vision-Exp 模型,支援在文字之外輸入圖片,執行視覺分析等任務。該公司表示,其多模態 Agent 能力大幅提升,在視覺 Agent 基準測試中的表現已接近 Opus-4.8。
极客公园 · 28 天前
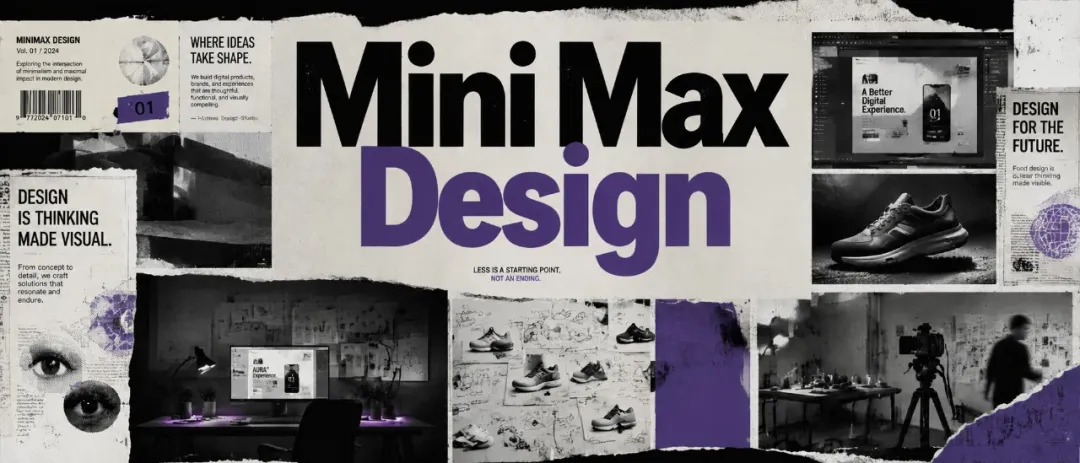
MiniMax H3 提供高品質的影片生成與編輯能力,支援最高 2K 輸出,價格約為每秒人民幣 0.8 元。H3 發布後不久,MiniMax 推出 MiniMax Design 內測,這是一個以 Agent 為核心的工作空間,可拆解創意任務並協調多個 AI Agent 完成端到端影片製作。
极客公园 · 29 天前
Xiaohongshu 發布 dots3-note preview,這是一個總參數 280B、啟用參數 16B 的開放權重 MoE 模型。該模型支援 512K 上下文,以及文字、視覺與語音理解,並以 Apache 2.0 授權釋出。
Pandaily · 29 天前

SenseTime 已開源 SenseNova U1.5 Lite,這是一款結合視覺理解、影像生成與編輯功能的 80 億參數多模態模型。模型支援原生 4K 影像輸出,並針對主體、數量、空間關係、文字、版面與視覺風格等要求進行設計。
TechNode · 29 天前

Mistral AI 發布 Shieldstral,這是一款 30 億參數、可適應規則的多模態安全分類器,支援文字、圖片與圖文混合輸入。它將審核轉化為自然語言規則匹配,據報在多項安全基準上接近甚至超越更大型模型。
雷峰网 · 33 天前

智象未來推出 HiDream-O1-World,這是一款支援文字、圖像與互動輸入,可用於生成、漫遊與編輯世界的原生全模態互動世界模型。該模型搭載升級版 UiT 架構,在 WBench 的 Navi 榜單以 80.9 平均分排名第一。
雷峰网 · 33 天前

據報導,一款新的世界模型可即時生成 24FPS 畫面與 48kHz 立體聲音訊。該專案預計即將完全開源。
量子位 · 33 天前

Microsoft 推出 MAI-Code-1.1-Flash,這款面向 GitHub Copilot 的升級程式設計模型具備更佳的基準測試表現,Token 生成速度提升 25%,完成相同任務所需的 Token 數量降低 25%。其價格降至初代模型的四分之一,並新增原生影像理解能力。
IT之家 · 38 天前

來自 xAI 的 Grok 4.6 現已透過 Vercel AI Gateway 提供,支援 500K token 上下文視窗,以及文字和圖片輸入。開發者可選擇 low、medium、high 或 xhigh 推理等級,預設為 high,也能透過 AI SDK 或 coding agents 使用該模型。
Vercel News · 38 天前
MiniMax H3 現已開放模型權重,並在單一工作流程中結合文字、圖片、影片與音訊作為上下文。模型可原生輸出最長 15 秒、2K 規格的立體聲音訊,而 768p Base 模型據社群基準測試可在消費級 GPU 上於數分鐘內運行。
Pandaily · 40 天前

Meta 推出 Muse Glimmer,一套設計為可在本機執行的開源 AI 系統。該產品具備代理能力與多模態特性,表示其可跨多種輸入與輸出模態執行自主任務。
Hugging Face Blog · 40 天前

ByteDance 發布 SeedRealtime 音視頻全雙工大模型,旨在提供更自然的即時互動體驗。同篇報導亦提到 JD.com 開源 JoyAI-Video-Edit 模型,支援即時互動式影片編輯。
钛媒体 · 44 天前
ByteDance 推出全雙工 AI 模型 SeedRealtime,專為持續性對話而設計。該模型整合音訊、影片與文字,並支援主動回應及更自然的對話節奏。
TestingCatalog · 45 天前

阿里正式推出 Qwen-Image-3.0,這是其圖像生成基礎模型的第三代產品。該模型具備更強的性能,包括支援 4.5k token 輸入、10px 小字精準渲染以及 12 種語言的原生渲染能力。
36氪 · 60 天前