模型
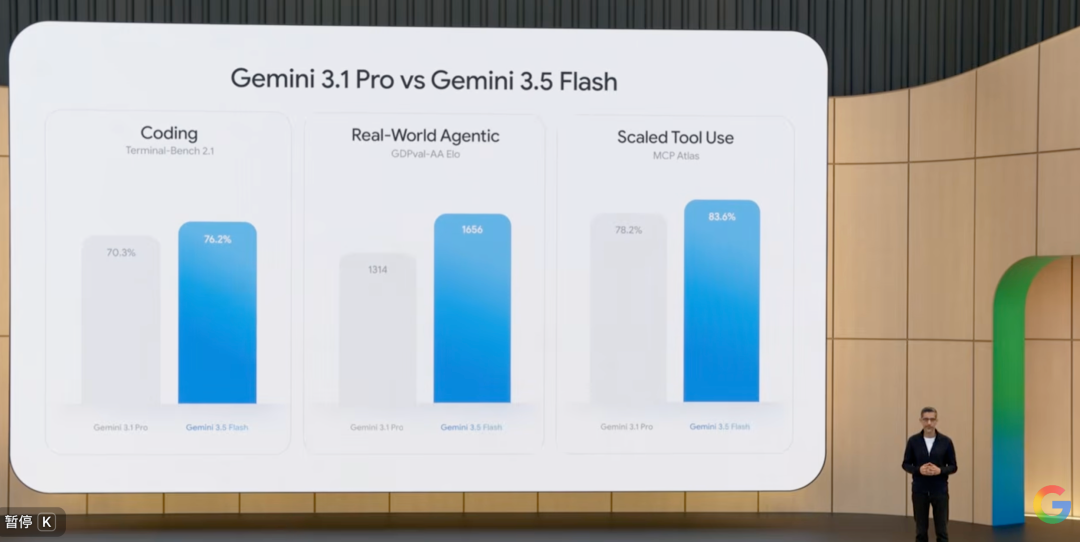
Google 發佈 Gemini 3.5 Flash 與 AI 智能體生態
Google 在 I/O 2026 大會上發佈了 Gemini 3.5 Flash、原生多模態模型 Omni 以及 AI 助手 Spark。Google 正積極將這些工具整合至全線產品,旨在主導 AI 智能體市場。
虎嗅 · 121 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
Google 在 I/O 2026 大會上發佈了 Gemini 3.5 Flash、原生多模態模型 Omni 以及 AI 助手 Spark。Google 正積極將這些工具整合至全線產品,旨在主導 AI 智能體市場。
虎嗅 · 121 天前

Google I/O 大會聚焦於將 AI 整合至全產品線,推出了 Gemini Omni 世界模型與高性價比的 Gemini 3.5 Flash,旨在推動企業與消費端的廣泛應用。
虎嗅 · 122 天前

Google 正式推出 Gemini Omni,這是一款專為即時、低延遲互動而設計的多模態模型。該模型透過提供無縫的跨模態處理,增強了 Gemini 生態系統的功能。
DeepMind Blog · 124 天前

據報 OpenAI 以 3 億美元收購智慧型手機相機公司 Glass Imaging。Glass Imaging 由曾參與開發 Apple Portrait Mode 的前 Apple 工程師創辦。
TechCrunch AI · 4 天前

Z.ai 發布 GLM-5.3-Flash,這是 GLM-5 系列首款原生多模態模型,也是首個採用 glm5_next 架構的開放權重版本。這款 3,200 億參數的 MoE 模型每次啟用 180 億參數,主打以十分之一的價格達到超越 GLM-5.2 的效能,並在程式設計與代理基準測試中展現強勁表現。
Reddit r/LocalLLaMA · 24 天前

西湖大學與阿里達摩院共同開發了「歸元」AI 模型,旨在預測幹細胞命運。透過分析數百萬種分子組合,該模型能精準調控細胞重編程,大幅加速生物學研究進程。
IT之家 · 67 天前

商湯科技發布 SenseNova-Vision,這是一款將目標檢測、分割、3D 重建等任務整合的統一視覺基礎模型。該模型已全面開源,並同步釋出 5000 萬條視覺指令語料庫。
IT之家 · 68 天前

Infinity-Parser2 是一款全新的多模態模型,具備 500 萬樣本的合成語料庫與多任務強化學習框架。該模型在文件解析基準測試中達到頂尖水準,超越了 DeepSeek-OCR-2 等模型。
ArXiv AI · 71 天前
Meta 發布了「Muse Spark 1.1」,這是一款增強了工具操作與複雜程式編寫能力的代理型多模態推理模型。該模型透過新設立的「Meta Model API」提供,定價低於競爭對手。
ITmedia AI+ (日本) · 71 天前

Meta 推出了 Muse Spark 1.1,這是一款專為進階程式編寫任務設計的升級版 AI 模型。它具備改進的錯誤偵測、支援多代理工作流程以及原生多模態感知能力。
The Verge · 72 天前
騰訊延攬前 OpenAI 研究員田永龍加入大語言模型部門,後續將投入視覺語言模型(VLM)的研發工作。
36氪 · 73 天前

生數科技正式發布 Vidu S1,這是一款具備即時交互能力的新一代影片生成模型,支援語音控制與高畫質輸出。
36氪 · 78 天前

杭州的一個團隊成功將流式多模態模型部署到端側,標誌著 CVPR 2026 趨勢的一個重要里程碑。
量子位 · 84 天前

佛羅里達國際大學的研究人員發現,圖像中不可見的像素級修改可以迫使 AI 聊天機器人繞過其安全防護機制,並生成受限內容。
Digital Trends · 88 天前
Google DeepMind 發布了 Gemma 4 12B,這是一款全新的無編碼器多模態模型。此次發布擴展了 Gemma 系列,增強了處理多樣化數據類型的能力。
DeepMind Blog · 102 天前
Google 發布了 Gemma 4 12B 多模態模型,旨在於消費級硬體上本地運行。該模型在僅需 16GB 記憶體的條件下,提供了媲美 26B 版本的效能。
cnBeta (Full RSS) · 107 天前
Google 發布了專為高效能設計的開放多模態模型「Gemma 4 12B」。該模型採用無編碼器架構,可在具備 16GB 記憶體的筆記型電腦上運行。
ITmedia AI+ (日本) · 108 天前
頂尖 AI 實驗室發布了全球首個全模態 API,即日起無限期免費開放。該 API 支援文字、圖像與影片數據的無縫處理。
量子位 · 110 天前

Google 發布了 Gemini 3.5 Flash 與 Omni 模型,同時產業迎來重大變革,包括 Anthropic 延攬 Andrej Karpathy 以及 AMD 擴展本土 AI 算力基礎設施。AI 競爭正從參數比拼轉向生態構建與行業滲透。
钛媒体 · 122 天前

Google 正式發布了 Gemini 3.5 模型,並同步推出全新的 AI Agent 功能與先進的影片生成模型。此次發布標誌著 Google 的產品策略正顯著轉向自主 AI Agent。
Ifanr (爱范儿) · 122 天前

Intern-S2-Preview 是一款全新的 35B 科學基礎模型,透過擴展任務難度與多樣性來提升效能。該模型具備增強的代理能力,並利用思維鏈(CoT)壓縮技術實現高效的強化學習。
Reddit r/LocalLLaMA · 127 天前

AIDC-AI 推出了 Ovis2.6-80B-A3B,這是一款採用專家混合(MoE)架構的多模態大型語言模型。它具備「圖像思考」(Think with Image)能力,允許模型在推理過程中主動操作視覺輸入。
Reddit r/LocalLLaMA · 129 天前

NVIDIA 推出 Nemotron 3 Nano Omni,這是一款緊湊的長上下文多模態模型,用於建構處理文件、音頻和視頻的智能代理。該模型託管於 Hugging Face,推進高效多模態 AI 能力。
Hugging Face Blog · 144 天前
商湯科技正式發布並開源日日新SenseNova U1系列原生理解生成統一模型。基於今年三月自主研發的NEO-unify架構,在單一模型架構上統一多模態理解、推理與生成。
36氪 · 144 天前
小米推出開源 MiMo-V2.5 和 V2.5-Pro 模型,採用 MIT 授權,可於 Hugging Face 下載用於商業應用。它們在如 OpenClaw 的代理「爪」任務中領先,Pro 版達 63.8% 成功率僅用 ~70K 令牌,比 Claude 或 GPT 少 40-60%。
VentureBeat · 144 天前
全新無審查 Qwen3.6-27B Aggressive 模型發布,附優化 K_P GGUF 量化版本。實現 0 拒絕率,無能力損失,支持多模態輸入。
Reddit r/LocalLLaMA · 149 天前
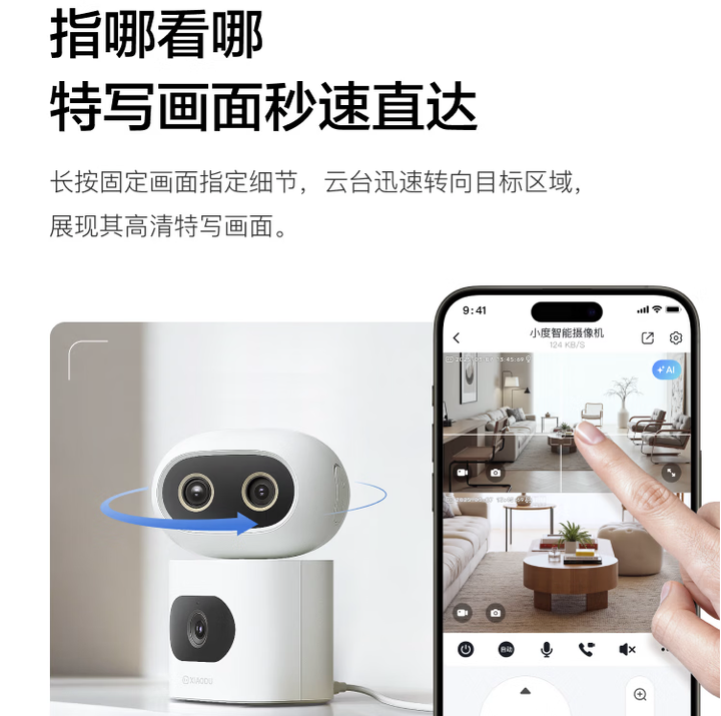
中國科技公司正將 AI Agent 連接至相機、麥克風、螢幕、感測器及家庭裝置。Baidu 的百度搭子與小度產品、Tencent 的 WorkBuddy 生態,以及 Google Gemini for Home 和 Amazon Alexa+,都展現 Agent 走向能感知並作用於實體環境的趨勢。
极客公园 · 9 天前

DeepSeek 已開始限時測試 V4.1 Flash,這是一款採用新架構並原生支援多模態能力的過渡模型。公司表示該模型具備更強的效能、更快的生成速度與更低的成本,開發者可透過現有 API 存取。
TechNode · 10 天前
DeepSeek 發布新的 V4 模型版本,同時將尖峰時段 API 價格最高提高 12 倍,以收回硬體成本。公司據報完成約 510 億元人民幣的 A 輪融資,並透過特殊架構降低短期投資人壓力、維持研究自主性。
虎嗅 · 11 天前
HiDream.ai 宣布推出 HiDream-O1-Embodied 具身世界模型。此次發布代表公司正致力於完成原生全模態技術戰略閉環。
量子位 · 12 天前