
影片
ByteDance 發布 SeedRealtime 全雙工模型
ByteDance 發布 SeedRealtime 音視頻全雙工大模型,旨在提供更自然的即時互動體驗。同篇報導亦提到 JD.com 開源 JoyAI-Video-Edit 模型,支援即時互動式影片編輯。
钛媒体 · 44 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
ByteDance 發布 SeedRealtime 音視頻全雙工大模型,旨在提供更自然的即時互動體驗。同篇報導亦提到 JD.com 開源 JoyAI-Video-Edit 模型,支援即時互動式影片編輯。
钛媒体 · 44 天前
ByteDance 推出全雙工 AI 模型 SeedRealtime,專為持續性對話而設計。該模型整合音訊、影片與文字,並支援主動回應及更自然的對話節奏。
TestingCatalog · 45 天前

阿里正式推出 Qwen-Image-3.0,這是其圖像生成基礎模型的第三代產品。該模型具備更強的性能,包括支援 4.5k token 輸入、10px 小字精準渲染以及 12 種語言的原生渲染能力。
36氪 · 60 天前

Thinking Machines Lab 推出了 Inkling,這是一個擁有 9750 億參數的開源模型。該模型專門用於處理並理解影片與音訊數據。
Wired AI · 66 天前

阿里巴巴發布了全新的即時語音大模型 Qwen-Audio-3.0-Realtime。此次更新針對速度與智慧化能力進行了四項關鍵功能升級。
量子位 · 66 天前

SenseTime 發布了 SenseNova-Vision,這是一個能處理物件偵測、3D 重建等多項視覺任務的統一基礎模型。它將多種功能整合至單一系統,取代了以往需依賴多個專用模型的做法。
TechNode · 67 天前

MedRealMM 是一個基於真實中文臨床諮詢的大規模多模態基準測試。它評估了大型語言模型處理圖文醫療數據的能力,並突顯了模型在安全性與推理能力上與人類醫師的差距。
ArXiv AI · 68 天前
Meta 推出了 Muse Spark 1.1,並為開發者提供公開 API 預覽。此更新增強了 AI 代理能力,並簡化了多模態工作流程。
TestingCatalog · 72 天前

ByteDance 推出了 Seedream 5.0 Pro,這是一款多模態圖像生成模型。它具備增強的推理能力、精確的編輯工具以及多語言支援。
TestingCatalog · 72 天前
據報導,Meta 正在開發配備「超級感知」AI 的智慧眼鏡,能持續監控使用者的周遭環境。該系統旨在將即時數據傳送給 AI 代理,以提供主動式協助。
Digital Trends · 73 天前
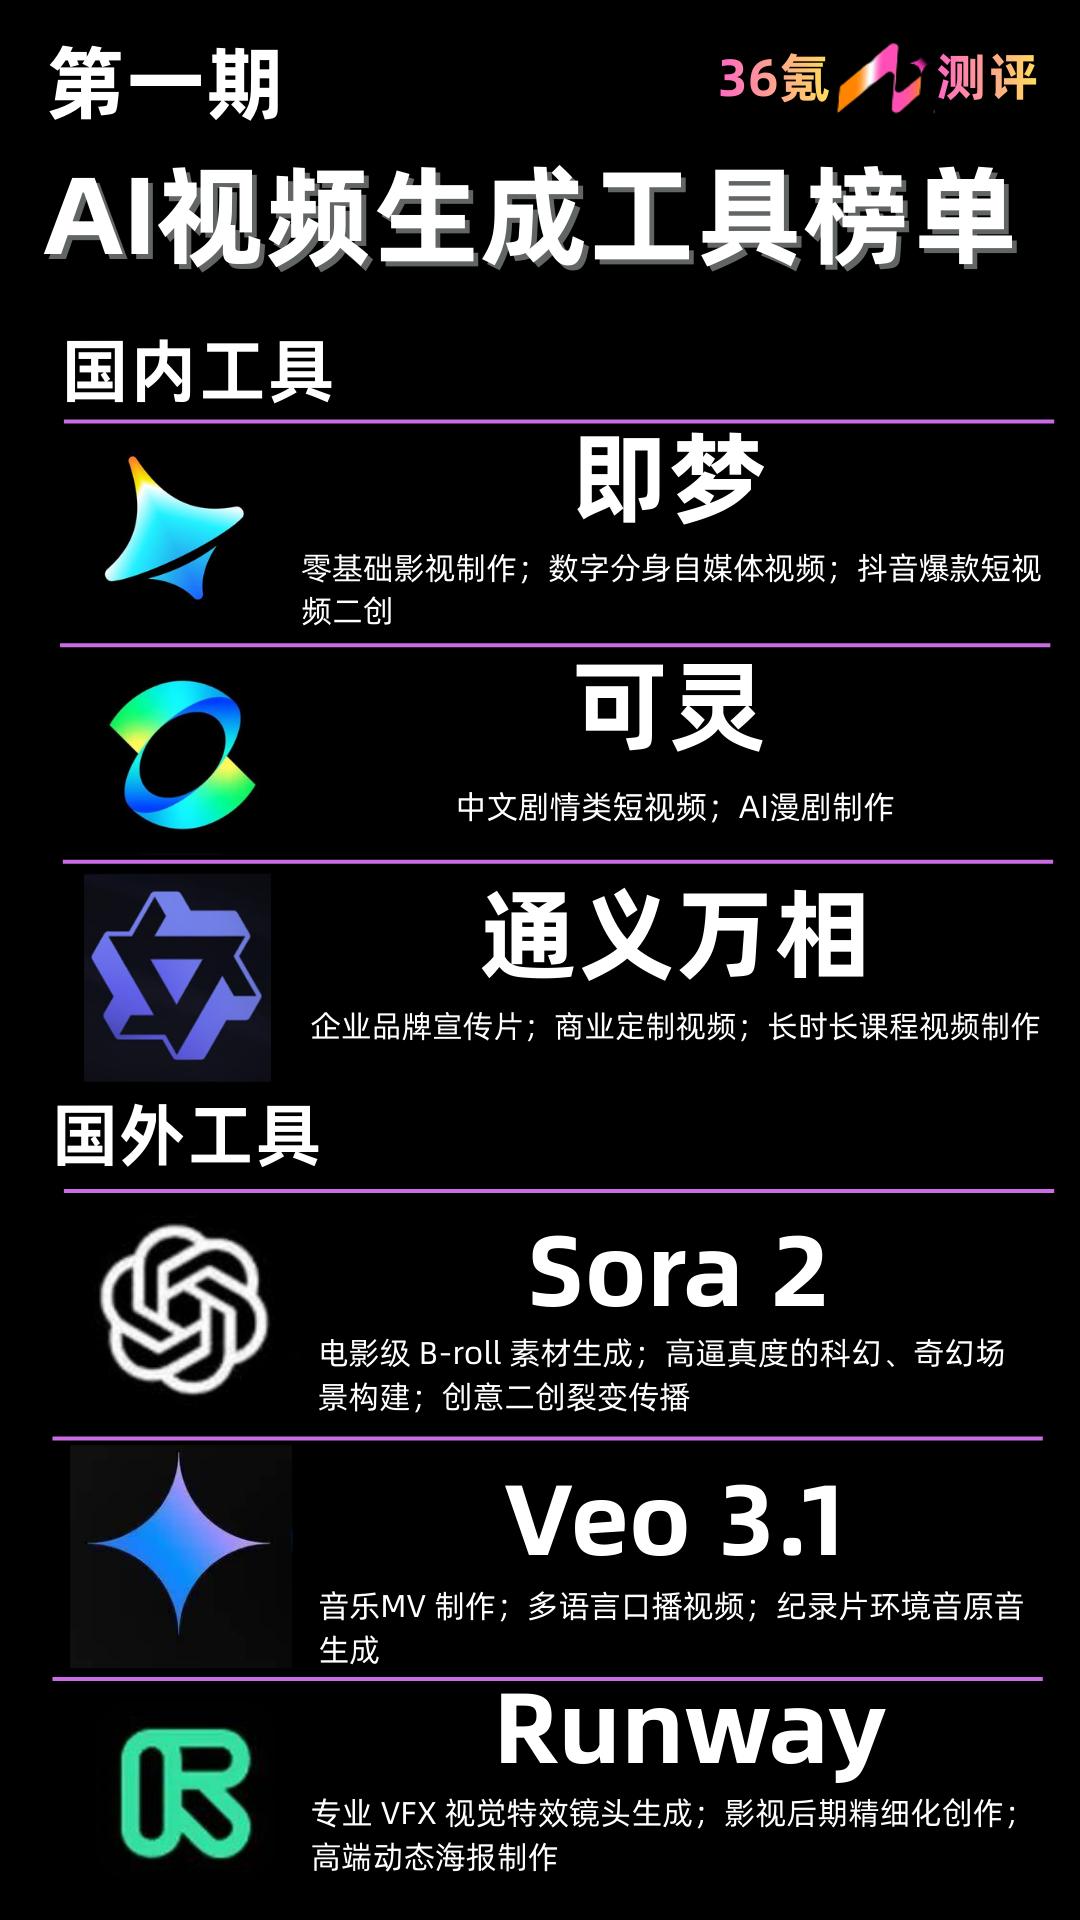
本文針對包括 Seedance 2.0、Kling 3.0 與 Sora 2.0 在內的六款頂尖 AI 視頻生成模型進行了全面評測,分析了它們在個人創作與企業應用場景中的核心優勢與局限性。
36氪 · 73 天前

Meta 推出了全新的 Muse Image 模型,這是其 Superintelligence Labs 部門的首個發布成果。該模型為 Meta 生態系統(包括 Instagram、WhatsApp 和 Meta AI 應用程式)提供圖像生成功能,並計畫擴展至 Facebook 和 Messenger。
The Verge · 73 天前

Google DeepMind 推出了 Nano Banana 2 Lite 與 Gemini Omni Flash 的新功能。這些工具旨在協助開發者構建更高效且具備即時響應能力的 AI 應用程式。
DeepMind Blog · 81 天前
MKG-RAG-Bench 是一個全新的跨領域基準測試,旨在評估多模態知識圖譜增強生成(MKG-RAG)中的檢索效能。它透過提供經過策劃的數據集來測試檢索與下游生成品質,解決了異質數據對齊這一關鍵瓶頸。
ArXiv AI · 84 天前
這篇研究論文分析了當前多模態 LLM 基準測試的局限性,這些測試往往無法評估跨模態整合能力。研究強調了在時空一致性和物理世界理解等領域建立更好評估指標的必要性。
ArXiv AI · 85 天前
NaviGen 引入了一種新穎的框架,將使用者互動歷史轉化為圖像與影片生成的執行指令。透過雙識別碼表示法與兩階段 SFT+RL 流程,它成功彌合了模糊的使用者意圖與高保真多模態輸出之間的鴻溝。
ArXiv AI · 86 天前
ReMMD 是一個旨在處理複雜、多語言和多圖像錯誤資訊的新框架。它利用具有持久記憶的代理方法來分解貼文,並比現有方法更有效地驗證真實性。
ArXiv AI · 87 天前
CaVe-VLM-CoT 是一個新型代理式 RAG 框架,旨在透過五階段閉環驗證流程減少視覺語言模型的幻覺。該研究引入了 CaVeScore,這是一套用於評估檢索品質、引用忠實度及跨模態基礎性的綜合指標。
ArXiv AI · 93 天前
Mel AI 發布了一款視訊原生 AI 角色的演示,具備即時語音、臉部表情與環境感知能力。該系統能對使用者的鏡頭環境做出反應,標誌著從純文字聊天轉向沉浸式視訊互動的趨勢。
Reddit r/MachineLearning · 94 天前

據報導,Apple 正在開發內建相機的 AirPods,旨在為 Siri 等 AI 功能提供「視覺情境」。這些裝置預計於 2027 年推出,目前正配合 iOS 28 進行測試。
The Verge · 95 天前
Apple 正在開發具備內建相機的新款 AirPods,預計於 2027 年發布。該產品旨在成為 Apple 更廣泛 AI 硬體策略中的關鍵裝置。
Bloomberg Technology · 95 天前
Google DeepMind 的 Gemma 4 模型系列現已於 Amazon Bedrock 上架。此次發布包含三種經過指令微調的變體,涵蓋密集架構與混合專家模型 (MoE),並具備多模態處理能力。
AWS Machine Learning Blog · 95 天前
Orchestra-o1 是一個專為多代理系統設計的新框架,旨在處理文字、圖像、音訊和影片等異質模態。它改進了任務分解與協作能力,並在 OmniGAIA 基準測試中達到了頂尖效能。
ArXiv AI · 96 天前

Meta 的智慧眼鏡正被重新應用,為盲人退伍軍人提供視覺輔助。此應用展示了穿戴式 AI 技術在無障礙領域的正面應用案例。
Digital Trends · 99 天前

包括 Meta、Google、Samsung、Apple 和 Amazon 在內的主要科技公司正競相將多模態 AI 與攝影機整合至智慧眼鏡中。此趨勢象徵著全天候 AI 互動的轉變,但也面臨大眾對隱私的擔憂。
Computerworld · 99 天前

本文針對 Claude 最新模型 Fable 5 進行實測。報導指出該模型在視覺推理能力上有顯著提升,特別是能準確識別圖像中的手指數量。
Ifanr (爱范儿) · 101 天前

NVIDIA 推出了 Nemotron 3.5 Content Safety,這是一款專為企業級 AI 應用提供可自定義多模態安全防護的新工具。它使企業能夠在文字與視覺輸入中執行特定的安全策略,以確保 AI 部署的可靠性。
Hugging Face Blog · 107 天前
VAMPS 是一個包含 1,168 個問題的多模態基準測試,旨在評估大型語言模型是否能有效利用視覺化工具解決複雜的代數與微積分問題。研究顯示,目前的模型在整合工具生成的圖表時表現不佳,直接進行分析推理的效果往往更好。
ArXiv AI · 107 天前
網易有道旗下的 LobsterAI 整合了一系列先進生成式模型,包括 Seedream、Seedance、HappyHorse 及 MiniMax-Hailuo。此更新大幅擴展了平台在圖片與影片合成方面的能力。
36氪 · 110 天前
Vercel 已將具備 100 萬 token 上下文窗口與原生多模態能力的 MiniMax M3 模型整合至 AI Gateway。開發者現在可以透過統一的 API 使用其強大的代理(agentic)功能與多模態輸入。
Vercel News · 111 天前