
研究
PRISM:填補具身AI感知缺口
PRISM 提出一個框架,透過動態問答管道緊密結合 VLM 感知與 LLM 決策。LLM 會批判 VLM 描述、提出目標導向問題,並合成任務導向的場景理解。
ArXiv AI · 134 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
PRISM 提出一個框架,透過動態問答管道緊密結合 VLM 感知與 LLM 決策。LLM 會批判 VLM 描述、提出目標導向問題,並合成任務導向的場景理解。
ArXiv AI · 134 天前

拉請求 #22493 在 llama.cpp 中新增 Xiaomi 的 Mimo v2.5 稀疏 MoE 模型支援。此模型總參數 310B,啟動 15B 參數,支援 1M 權重上下文,並處理文字、圖像、影片、音訊模態。
Reddit r/LocalLLaMA · 135 天前

字節跳動升級 Doubao-Seed-2.0-lite,為豆包家族首款全模態模型,原生統一理解影片、圖像、音訊與文字。在視覺/音訊基準達 SOTA,超越 Gemini-3.1-Pro,Agent、Coding 與 GUI 能力同步強化。
IT之家 · 136 天前

Apple 推出 SFI-Bench,一個基於影片的基準測試,包含超過 1700 個來自多樣自我中心室內影片掃描的問題。它評估多模態 LLM 的高階空間-功能智能,超越 VSI-Bench 等基本幾何感知。
Apple Machine Learning · 136 天前

CVPR 2026 多模態論文重定義視覺智能:VideoAuto-R1 實現按需推理,LIVR 在潛在空間無語言視覺推理,ARC 重新定位為視覺任務。趨勢強調高效隱式推理而非恆定鏈式。
雷峰网 · 142 天前
中國 AI 新創 DeepSeek 為其旗艦聊天機器人新增多模態功能,能處理圖像與影片,結合文字。該首次功能限特定用戶測試,繼 V4 模型推出與大幅降價後。
SCMP Technology · 143 天前
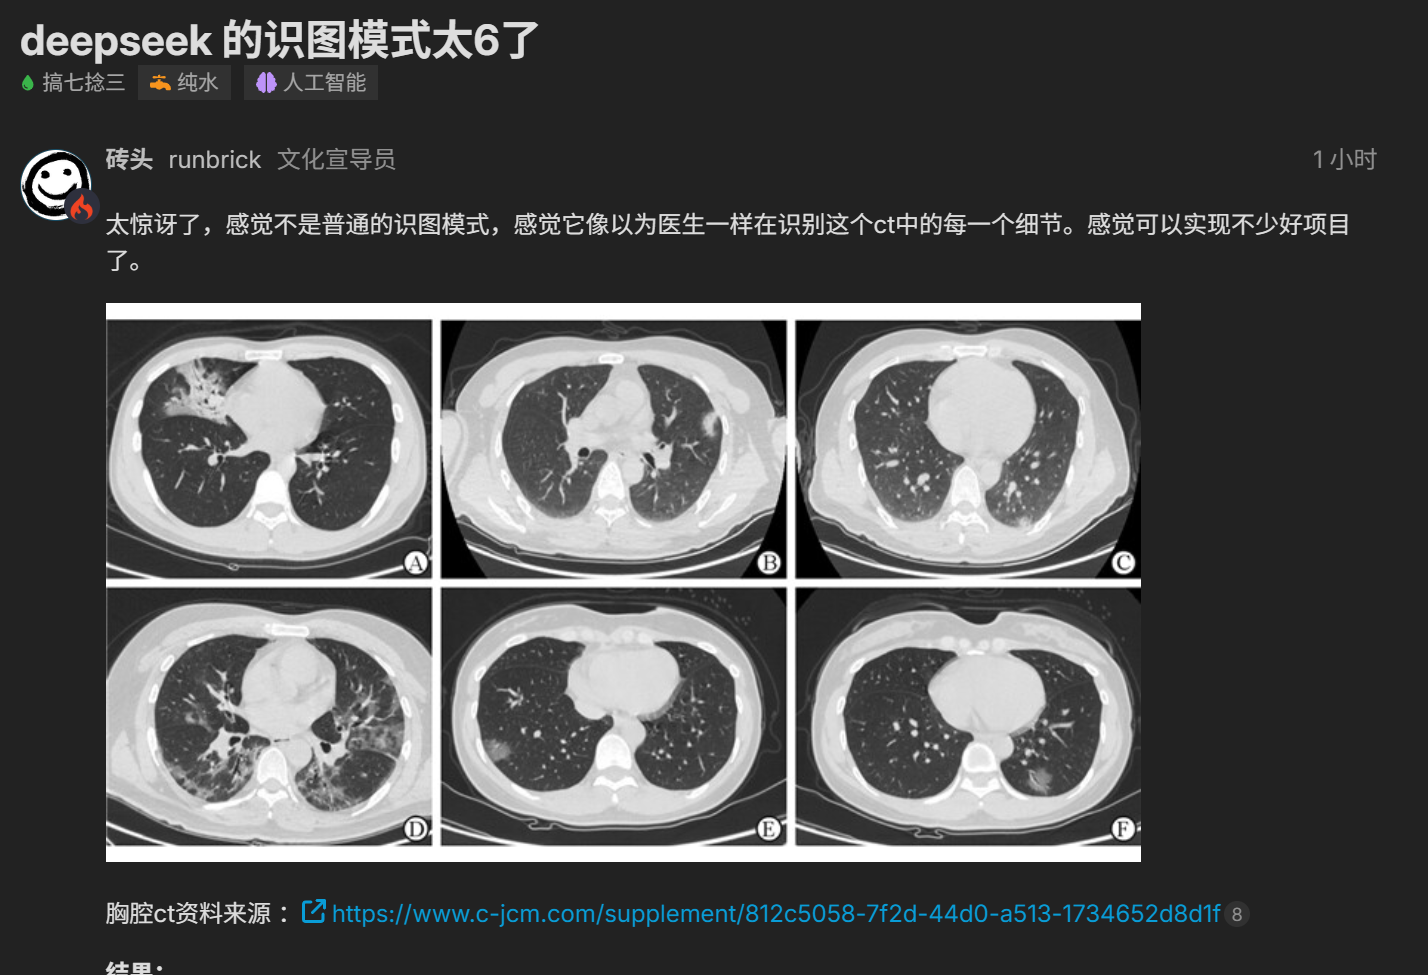
DeepSeek V4 發布僅5天,網頁端已進入灰度測試識圖模式,能理解圖像資訊。使用者可直接上傳截圖,讓DeepSeek分析,比自行描述問題更簡單。
cnBeta (Full RSS) · 143 天前
商湯科技推出並開源 SenseNova U1,這是一款統一多模態模型。基於 NEO-unify 架構,它將理解與生成合併至單一框架。
Pandaily · 143 天前

一款新型開源模型採用低參數捲積架構,將圖像理解與生成任務統一。已全網開源,即刻可用。
量子位 · 143 天前
面壁智能發布MiniCPM-o 4.5技術報告,強調其在消費級顯卡上快速上手運行。該模型下載量已突破25萬,顯示高度人氣。
量子位 · 144 天前
Apple 推出 StereoFoley,一個從影片生成語義對齊、時間同步且空間精準的 48 kHz 立體音頻框架。它克服先前模型的單聲道限制及立體資料集不足。
Apple Machine Learning · 144 天前

Kimi K2.6 在 3D 設計任務基準中名列第一。被形容為最佳模型評估基準之一。
Reddit r/LocalLLaMA · 149 天前
X Square Robot 推出 WALL-B,這是一款下一代具身 AI 模型,專為現實世界家用部署設計。它具備多模態學習與物理推理功能,用於家居互動。
Pandaily · 149 天前

OpenAI 已於 ChatGPT、Codex 及其 API 推出 Images 2.0。它引入兩種模式、先進文字支援,以及 4K 輸出解析度。
TestingCatalog · 149 天前

Koharu 是 Rust 撰寫的本地漫畫/圖像翻譯器,已更新更可靠且易用。整合 llama.cpp 支援 Gemma/Qwen 模型、物件偵測、OCR 與修補。
Reddit r/LocalLLaMA · 150 天前
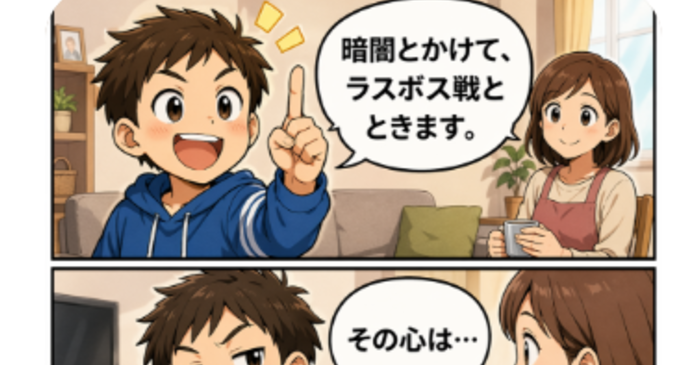
OpenAI 宣布推出 ChatGPT Images 2.0,這是一款先進的圖像生成模型,AI 會逐步推理後再產生視覺內容。它比前版大幅提升日文文字渲染的準確度。
ITmedia AI+ (日本) · 150 天前
Zibian Robotics 推出 WALL-B,這是一款下一代具身 AI 模型,專為家庭部署設計。它整合多模態學習與物理推理,適用於現實世界互動。
Pandaily · 150 天前

OpenAI 推出 ChatGPT Images 2.0 全球免費開放,推動多模態 AI 實用化。Meta 投資 10 億美元建資料中心;Nvidia 發布 DLSS 4.5 SDK 及 Jetson 記憶體優化;Intel 提出智能體 PC 概念。
钛媒体 · 150 天前

OpenAI 推出 ChatGPT Images 2.0,可從單一提示透過網路搜尋生成精細圖像。由 GPT Image 2 提供思考能力,提升指令遵循、細節保留與文字生成。
The Verge · 151 天前
OpenAI 的 ChatGPT Images 2.0 是最新圖像生成模型。該模型意外擅長生成文字,突顯近年 AI 能力快速演進。
TechCrunch AI · 151 天前
Daimon Infinit 是全球最大規模含觸覺的全模態物理世界數據集,已聯合發布。吸引谷歌及眾多高校參與。
量子位 · 152 天前
GIST 將消費級行動點雲轉換為具語義註解的導航拓撲,透過 2D 佔用圖、拓撲佈局及輕量語義疊加層。支援意圖驅動語義搜尋、一-shot 定位(1.04m 誤差)、區域分類及視覺 grounding 指令生成等任務。
ArXiv AI · 152 天前
團隊微調與部署 Gemma-4 的經驗揭露關鍵問題:PEFT 與自訂層不相容、SFTTrainer 因 KV 共享靜默失敗、DeepSpeed 儲存空適配器,以及伺服工具缺乏即時 LoRA 支援。修復包括解包層、更新 transformers、避免 DeepSpeed,以及手動合併權重。
Reddit r/MachineLearning · 153 天前
Canva 與 Anthropic 推出 Claude Design,這是 Anthropic Labs 產品,由 Claude Opus 4.7 與 Canva 的 Design Engine 驅動。可從文字描述生成完全可編輯、符合品牌的視覺內容。
The Next Web (TNW) · 155 天前

使用者指示 Qwen3.6-35B 使用 MCP 截圖建構塔防遊戲,它成功實作並測試升級功能。模型自行偵測並修復畫布渲染與波次完成錯誤。
Reddit r/LocalLLaMA · 155 天前

OpenAI 更新其 AI 程式代理 Codex 的 Mac 版,新增桌面應用操控、圖像生成與記憶功能。Codex 現在可透過自身游標查看螢幕、點擊與輸入,執行自動化任務。
cnBeta (Full RSS) · 156 天前

Anthropic 推出最強一般可用模型 Claude Opus 4.7。它在進階軟體工程、複雜編碼、影像分析、指令遵循及創意文件生成表現優異。
The Verge · 156 天前

Cloudflare 將 AI Gateway 發展為 AI 代理的統一推理層。開發者現在可呼叫 14+ 提供者的模型。
Cloudflare Blog · 156 天前
LLM-HYPER 將大型語言模型視為超網路,透過少樣本思維鏈提示生成冷啟動廣告的無訓練 CTR 模型參數,利用多模態內容。使用 CLIP 嵌入擷取相似活動作為示範。
ArXiv AI · 156 天前

Cloudflare Agents SDK 的實驗語音管線支援 WebSockets 即時語音互動。提供連續 STT 和 TTS。
Cloudflare Blog · 157 天前