來源cnBeta (Full RSS)•較早收集於 9m
新版DeepSeek識圖功能還能讀懂CT圖
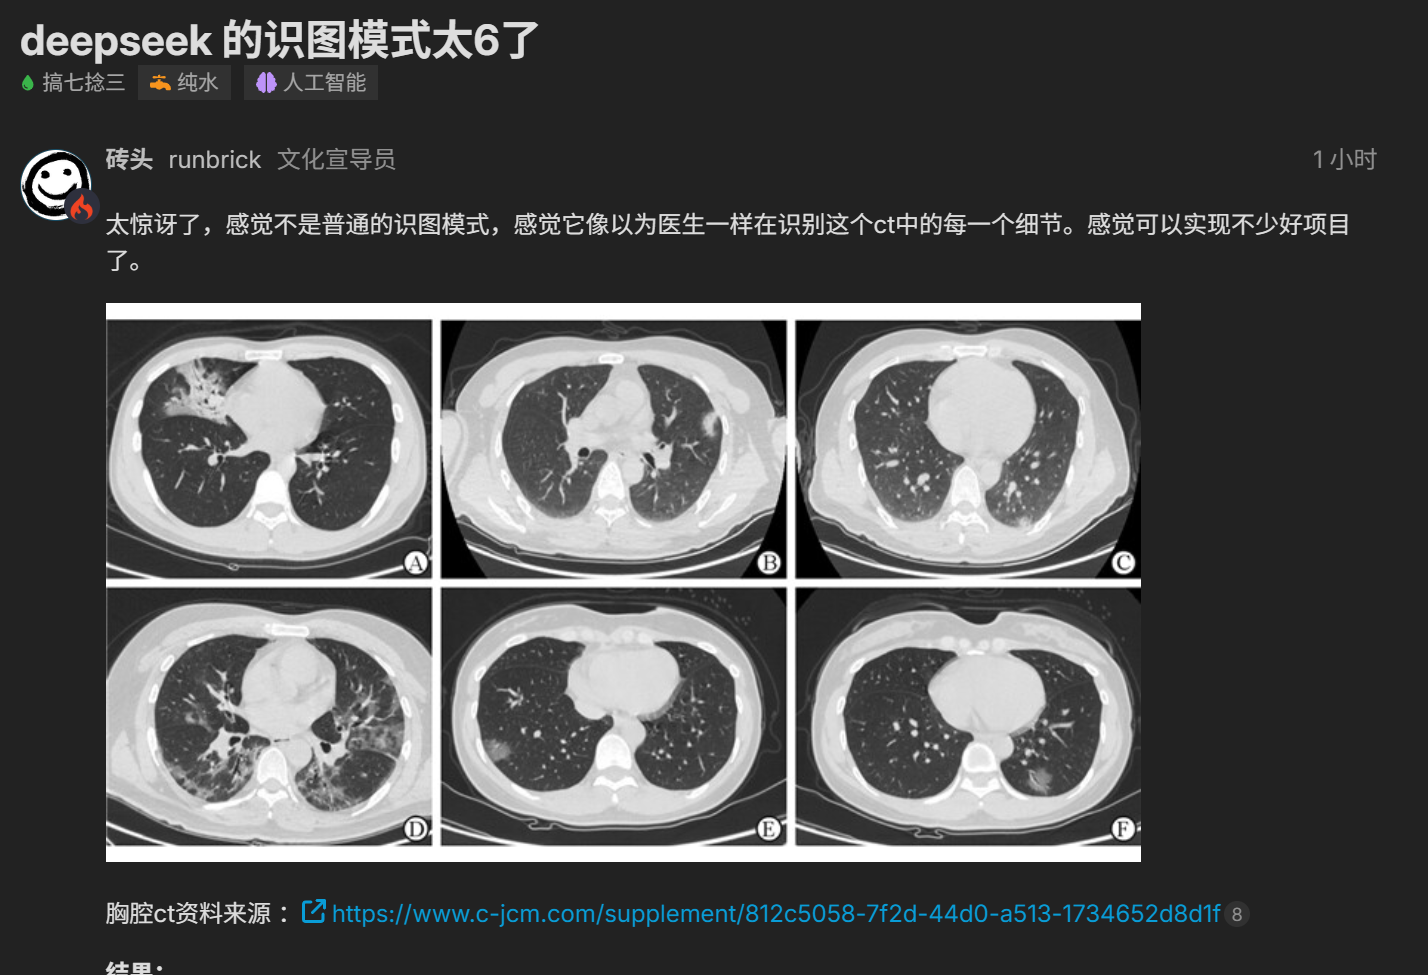
DeepSeek V4視覺首發:截圖分析+CT讀取–開發者多模態助力(32字元)
30 秒速覽
有什麼變化
DeepSeek網頁端新增識圖模式,進入灰度測試
為什麼重要
此多模態功能讓DeepSeek更全面,與具視覺LLM競爭,擴大診斷與視覺除錯應用。
下一步行動
上傳程式碼錯誤或圖表截圖至DeepSeek網頁,獲即時分析。
誰應關注:Developers & AI Engineers
關鍵要點
- •DeepSeek網頁端新增識圖模式,進入灰度測試
- •支援截圖上傳,讓AI直接分析視覺問題
- •能解讀醫學影像如CT圖
- •提升使用便利性,未直接改善推理性能
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •DeepSeek V4 採用了原生多模態架構(Native Multimodal Architecture),而非傳統的「視覺編碼器+大語言模型」拼接方案,這使其在處理複雜醫學影像時能保持更高的語義一致性。
- •該識圖功能在醫學影像分析中引入了專門的醫療領域微調(Domain-specific Fine-tuning),特別針對 DICOM 格式的預處理與特徵提取進行了優化,以降低誤診率。
- •DeepSeek 官方強調該功能目前僅限於輔助研究與資訊參考,並未獲得醫療器械認證(如 FDA 或 NMPA),明確禁止將其作為臨床診斷的唯一依據。
競品分析
視覺理解能力
- DeepSeek V4
- 原生多模態
- GPT-4o
- 原生多模態
- Claude 3.5 Sonnet
- 原生多模態
醫療影像分析
- DeepSeek V4
- 支援(實驗性)
- GPT-4o
- 支援(受限)
- Claude 3.5 Sonnet
- 支援(受限)
價格策略
- DeepSeek V4
- 高性價比/開源傾向
- GPT-4o
- 訂閱制/API計費
- Claude 3.5 Sonnet
- 訂閱制/API計費
基準測試 (MMMU)
- DeepSeek V4
- 領先水平
- GPT-4o
- 頂尖水平
- Claude 3.5 Sonnet
- 頂尖水平
| 特性/模型 | DeepSeek V4 | GPT-4o | Claude 3.5 Sonnet |
|---|---|---|---|
| 視覺理解能力 | 原生多模態 | 原生多模態 | 原生多模態 |
| 醫療影像分析 | 支援(實驗性) | 支援(受限) | 支援(受限) |
| 價格策略 | 高性價比/開源傾向 | 訂閱制/API計費 | 訂閱制/API計費 |
| 基準測試 (MMMU) | 領先水平 | 頂尖水平 | 頂尖水平 |
技術深入
- 採用混合專家模型(MoE)架構,視覺處理模組與語言模型權重深度融合。
- 視覺編碼器支援動態解析度輸入,能有效捕捉 CT 影像中的細微病灶特徵。
- 訓練數據集包含大規模的醫學影像-文本對(Image-Text Pairs),並經過專業放射科醫師的標註與校對。
- 推理過程中引入了視覺注意力機制(Visual Attention Mechanism)的優化,減少了對非關鍵區域的計算資源消耗。
前景展望基於引用來源的 AI 分析
DeepSeek 將推出專用的醫療垂直領域模型(DeepSeek-Med)。
現有通用模型在處理醫學影像時的合規性與專業度限制,推動了其向更專業、受監管的垂直領域發展。
多模態推理能力將成為 DeepSeek 商業化 API 的核心競爭力。
相較於純文字模型,具備視覺分析能力的 API 能顯著提升在工業檢測、醫療輔助等高價值場景的採用率。
時間線
2024-01
DeepSeek 發布首個開源大語言模型系列。
2025-05
DeepSeek 宣布啟動多模態視覺模型研發計畫。
2026-04
DeepSeek V4 正式發布,並於 5 天後開啟識圖功能灰度測試。
- 2024-01DeepSeek 發布首個開源大語言模型系列。
- 2025-05DeepSeek 宣布啟動多模態視覺模型研發計畫。
- 2026-04DeepSeek V4 正式發布,並於 5 天後開啟識圖功能灰度測試。
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: cnBeta (Full RSS) ↗
每週電子報
每週一封,可隨時退訂。