研究
Floatboat Harness 在五項基準測試擊敗 Claude Opus 4.8
AOE Tech Labs 表示,其 Floatboat Harness 讓 DeepSeek-V4-Flash 在五項測試基準中全部擊敗 Claude Opus 4.8。這項單一變因實驗只更換執行 Harness,並使用相同的 0.14 美元模型,成本低至 57.1 分之一。
Pandaily · 38 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
AOE Tech Labs 表示,其 Floatboat Harness 讓 DeepSeek-V4-Flash 在五項測試基準中全部擊敗 Claude Opus 4.8。這項單一變因實驗只更換執行 Harness,並使用相同的 0.14 美元模型,成本低至 57.1 分之一。
Pandaily · 38 天前

Xiaomi 已開源具身 AI 基礎模型 Xiaomi-Robotics-1。此次發布涵蓋從真實機器人後訓練到模型部署的完整流程,並提供相關基準測試的程式碼。
TechNode · 44 天前
全新的「Schema」評測工具透過優化模型與遊戲環境之間的互動流程,提升了在 ARC-AGI-3 基準測試上的表現。它利用 Claude Opus 4.8 和 Fable 5,在不修改模型權重的情況下達到了 99% 的準確率。
Reddit r/MachineLearning · 64 天前
透過 63 道複雜提示詞測試,GPT-5.6 Sol Ultra 在生成細節豐富且具互動性的 3D 網頁環境方面,顯著優於其他模型。
虎嗅 · 68 天前
目前的安全性評測基準已無法準確衡量前沿 AI 模型不斷演進的駭客能力。這導致安全團隊與監管機構缺乏可靠的工具來評估先進系統所帶來的風險。
The Next Web (TNW) · 72 天前
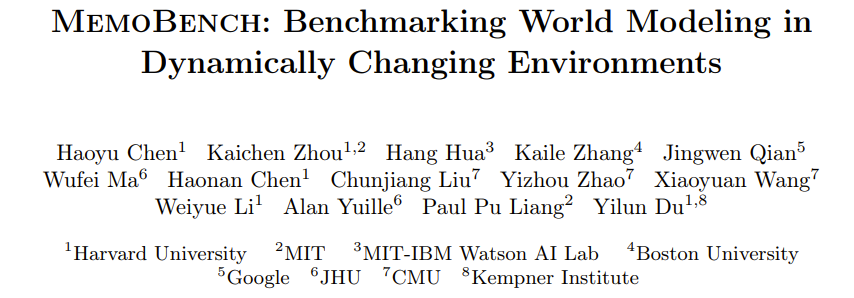
MemoBench 是一個全新的診斷基準,旨在測試世界模型在動態環境中維持物體恆存與狀態演化的能力。研究顯示,目前的影片生成模型在物體被遮擋期間,難以準確追蹤並更新其狀態。
虎嗅 · 74 天前
北京新創公司 Zhipu AI 發布了 GLM-5.2,該模型在網路安全漏洞檢測任務中展現出與 Anthropic 的 Claude Opus 4.8 相當的競爭力。此進展凸顯了中國 AI 模型與美國頂尖模型之間的差距正在縮小。
SCMP Technology · 81 天前
First Proof計畫針對四個AI系統進行了原創且未公開的研究級數學題測試,結果顯示儘管AI表現亮眼,但在整體研究能力上仍落後於頂尖人類數學家。
虎嗅 · 87 天前
Sina Weibo 的研究人員推出了 VibeThinker-3B,這是一款 30 億參數的模型,據稱其推理能力可媲美甚至超越大型旗艦模型。此發布在 AI 社群中引發了關於當前基準測試有效性的激烈爭論。
VentureBeat · 94 天前
加州大學柏克萊分校研究人員推出了「Agents’ Last Exam」(ALE),這是一項嚴格的基準測試,旨在評估 AI 代理在真實、長週期專業工作流程中的表現。GPT-5.5 獲得最高分,擊敗了 Anthropic 的 Claude Fable 5,該測試強調實際勞動力影響而非靜態編碼難題。
VentureBeat · 100 天前
中國新創公司 Spirit AI 在 RoboArena 排行榜上超越了 Nvidia 的機器人模型。其 Spirit v1.6 模型獲得 1,924 分,擊敗了 Nvidia 的 Cosmos3-Nano-Policy。
The Next Web (TNW) · 105 天前
Datacurve 推出了 DeepSWE 程式碼評測基準,揭示了頂尖模型間的顯著效能差距,並將 GPT-5.5 評為領先者。該報告同時指出現有的 SWE-Bench Pro 評估存在 32% 的錯誤率,質疑了當前產業標準的可靠性。
VentureBeat · 115 天前

AI 先驅李飛飛推出了一項旨在評估具身空間智能的新基準。該計畫旨在為下一代機器人和空間智能系統提供標準化的數據集與評估框架。
量子位 · 119 天前

BenchJack 是一個自動化紅隊測試系統,旨在識別 AI 代理基準測試中的獎勵駭客行為。透過將其應用於 10 個主要基準測試,研究人員發現了 219 個缺陷,證明許多當前的評估指標在未實際完成任務的情況下即可輕易被操弄。
ArXiv AI · 127 天前
HarvestBench 是一項可重現的基準測試,用來衡量 LLM 代理在模擬玉米收割過程中,是否願意消耗資源來避免殺死動物。九個模型的碾殺率介於 0.4% 到 98.8% 之間,而道德提示大幅降低了有害行為。
ArXiv AI · 11 天前
據報導,OpenAI 在 GPT-6 Astra 取得 99.9% 分數後宣告 AGI 時代到來,但同一模型透過該基準測試的官方軟體執行時,分數僅為 62.7%。ARC Prize 公布了這兩個數字,引發外界對評測方法與 AGI 宣稱可重現性的質疑。
The Next Web (TNW) · 12 天前
DS-Lighting 是一套開源代理 harness 工具,將資料科學代理背後的基礎架構明確化並提升可重用性。它整理資料、工作流程、執行與評估四個層次,並標準化基準測試任務,以進行受控比較。
ArXiv AI · 17 天前

Terminal Bench 4.0 顯示,將誤差範圍納入考量後,GLM-5.3 的表現大致與 Fable 5 持平。討論也強調該基準測試快速迭代的重要性,以及大規模評估程式設計代理的高昂成本。
Reddit r/LocalLLaMA · 20 天前
Together AI 在 900 次 DeepSWE rollout 中評估 GLM-5.3 與 GLM-5.3 Flash。GLM-5.3 Flash 的 pass@1 少 5.6 個百分點,但成本低 17 倍;在 pass@4 下差距縮小至 2.6 個百分點。
Together AI Blog · 22 天前

Agent Seer 提出直接從工具規格合成工具型 AI 代理評估情境的方法。透過函式名稱、自然語言描述與具型別的參數結構,它旨在減少人工整理,並讓基準測試與持續演進的 API 保持一致。
Apple Machine Learning · 22 天前
HarnessOpt-Bench 評估 LLM 是否能在無法存取保留測試、憑證或預算的情況下,改進另一個代理的程式設計 harness。在 111 次測試中,模型選擇對效能的影響大於 harness 選擇,而 Claude Opus 5 搭配 OpenCode 在四項任務中贏得三項。
Reddit r/MachineLearning · 22 天前
Nvidia 在 Hot Chips 2026 展示了 Groq 3 LPX 機架的架構。公司也發布首份第三方推論基準測試,並表示採用 LP30 的機架已投入生產。
Tom's Hardware · 23 天前
ESQ-Bench 是一項以 Oracle 為核心的新基準,用於測試 NL2SQL 在真實企業結構中的方言泛化能力與隱性語意偏差。在三個複雜度層級中,即使通過執行測試的查詢也經常產生錯誤結果;Claude Sonnet 4.6 整體大幅優於 GPT-4o 與本地端 Llama 3.2。
ArXiv AI · 23 天前
OpenAI 表示,其全新的 Jalapeno 晶片在測試中勝過 Nvidia 目前的產品線。據稱,這些晶片在單位功耗可處理的 AI 工作量與回應速度兩項指標上領先。
Bloomberg Technology · 24 天前

據報導,OpenAI 的 Jalapeño 晶片可在大規模部署下提供強大的推論效能。在 Semianalysis 的 InferenceX 基準測試中,其每位使用者的產生 token 數,以及每千瓦吞吐量,均高於目前可用的最先進系統。
TechCrunch AI · 24 天前

Unbounded Labs 發布 Bart,這是一個從零開始訓練、使用 1931 年前出版的 201 億個英文 token 的 28.2 億參數語言模型。團隊也開源了整理後的資料集、Vintage CORE 基準測試、訓練程式碼、評估工具與研究訓練紀錄。
Reddit r/MachineLearning · 25 天前
全新的 CSE 基準測試顯示,LLM 能合理處理個別指令,但在必須同時滿足多項約束時便會陷入困境。研究涵蓋 15 個模型與 369,753 次檢查,結果顯示同時處理約 5 至 6 項以上要求時,全部約束皆通過的成功率會迅速崩落。
ArXiv AI · 35 天前
SAPO 是一種分段式自動提示詞優化方法,能分別改善提示詞中的角色、背景、任務與輸出格式。其在五項基準測試及 GPT-3.5-Turbo 與 GPT-4o-mini 上,平均表現優於 zero-shot prompting 與多種強大的 APO 基線方法。
ArXiv AI · 36 天前
SAI Review 嘗試重現 ICML 2026 的 105 篇 Oral 論文,發現只有 8 篇重現了超過 80% 的可驗證主張。審查揭露程式碼無法執行、檔案缺失、結果不一致、模型下線,以及極高的重現成本等問題。
虎嗅 · 40 天前
PPIO 正式發布 Fusion 模型,宣稱其智慧能力可超越頂級模型,而價格僅為其十分之一。這項發布將 Fusion 定位為生產環境 AI 工作負載中更具成本效益的選擇。
量子位 · 43 天前