
模型
PPIO 發布 Fusion,價格僅頂級模型十分之一
PPIO 正式發布 Fusion 模型,宣稱其智慧能力可超越頂級模型,而價格僅為其十分之一。這項發布將 Fusion 定位為生產環境 AI 工作負載中更具成本效益的選擇。
量子位 · 42 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
PPIO 正式發布 Fusion 模型,宣稱其智慧能力可超越頂級模型,而價格僅為其十分之一。這項發布將 Fusion 定位為生產環境 AI 工作負載中更具成本效益的選擇。
量子位 · 42 天前

Apple Machine Learning 推出 DeepAmbigQA,用於評估具備搜尋功能的 LLM 是否能完整回答含歧義的多跳問題。其 DEEPAMBIGQAGEN 管線會自動產生需要釐清標題歧義、跨多個實體蒐集證據並整合結果的問題。
Apple Machine Learning · 44 天前

本研究提出了一套嚴謹的基準測試協議,利用多模型 LLM 同儕審查來評估自主 AI 研究系統。研究針對四種框架與商業基準進行評測,揭示了顯著的效能差距,並驗證了自動化評估的可靠性。
ArXiv AI · 46 天前

Kimi K3 模型在 ArtificialAnalysis 排行榜上取得第三名的佳績。在這次基準測試評估中,它顯著超越了 Claude Opus 4.8 模型。
Reddit r/LocalLLaMA · 64 天前

Moonshot AI 的全新 Kimi K3 模型已出現在基準測試平台,展示了足以媲美 Fable 5 的影片生成能力。社群媒體上的早期測試顯示,該模型在動畫流暢度與視覺細節方面有顯著提升。
Pandaily · 64 天前

Papers with Code 推出了專屬的機器人技術專區,用於追蹤主要基準測試、熱門論文和開源項目。目前涵蓋了 LIBERO 和 SimplerEnv 等基準測試中的 110 多個項目。
Reddit r/MachineLearning · 65 天前
研究人員發布了 ALEM 基準測試,旨在評估 LLM 代理在複雜、開放式環境中的協作能力。測試結果顯示,儘管大多數模型表現不佳,但 Gemini 3.1 Pro 在高難度任務中展現了與專業訓練模型相當的潛力。
Reddit r/MachineLearning · 66 天前
Long-Horizon-Terminal-Bench 引入了一套新的 AI 代理評估框架,包含 46 項需要長期規劃與迭代除錯的複雜多步驟任務。該基準測試透過提供密集的中間獎勵,能比傳統僅評估最終結果的方法更精確地衡量代理在開放式工作流程中的進展。
ArXiv AI · 67 天前

Vercel 的 AI Gateway 排行榜現在提供可分享的圖表以及對生產流量數據的開放存取。使用者可以透過可下載的 CSV 或程式化匯出端點來分析模型、實驗室、應用程式與供應商的效能。
Vercel News · 68 天前
本研究綜述透過將臨床能力等級與計算推理模式進行對應,評估了大型語言模型在醫療領域的應用。文中引入了一個涵蓋五個推理層級的基準測試,並比較了 18 種先進模型,以識別臨床實踐中的效能差距。
ArXiv AI · 70 天前
研究人員提出了一種結合 LLM 推理與 SageMath 可驗證計算的 ReAct 風格代理框架。研究顯示,該架構在多種模型上均顯著提升了效能,有效縮小了開源權重模型與閉源模型之間的差距。
ArXiv AI · 71 天前
這項研究提出了一種評估超越人類能力 AI 模型的新範式,透過相對衡量而非靜態基準來進行評估。該框架利用模型生成的挑戰,建立了一套能隨代理能力同步擴展的對抗性心理測量評分系統。
ArXiv AI · 71 天前
AgentLens 是一個全新的開源基準測試,旨在根據編碼代理的完整互動軌跡進行評估,而非僅僅依賴二元通過/失敗的結果。它結合了形式驗證與 LLM 生成的評論,為代理的行為與效能提供具體的分析見解。
ArXiv AI · 71 天前
RoboDojo 作為具身智能的全新高難度評測基準正式發布,揭示了人類與當前 AI 模型在物理任務執行上的巨大差距。測試顯示,即使是最先進的模型在處理具身任務時,距離人類水平仍有顯著落差。
量子位 · 72 天前
OpenAI 發布了一項分析,強調 SWE-Bench Pro 評測基準中的重大缺陷。該報告質疑目前用於評估 AI 程式編寫能力的評測方法之準確性與可靠性。
OpenAI News · 72 天前

開發者實驗顯示,本地 LLM 若無 RAG 支援,在回答技術問題時表現不佳,但結合知識庫後效果顯著。該研究測試了包括 Apple Intelligence 和 Qwen 在內的多種模型,證實了上下文注入的有效性。
Reddit r/LocalLLaMA · 72 天前
MedCalc-Pro 是一個包含 2,268 個臨床案例與 77 種醫療計算器的全新基準測試,旨在解決現有 LLM 醫療評估的侷限性。該研究同時提出了一種專用代理框架,能處理多工具選擇與嵌套計算,並有效抑制參數誤差傳播。
ArXiv AI · 73 天前
對中國國產GPU廠商(礪算、摩爾線程)與行業領導者Nvidia進行實機性能對比。測試評估了國產晶片處理如《Cyberpunk 2077》等高負載任務的能力。
虎嗅 · 78 天前
REAP 是一個全新的框架,透過從互動式生產環境的使用數據中提取資訊,自動化建構編碼代理(Coding Agent)的基準測試。此研究旨在縮小合成基準測試與真實軟體工程任務之間的差距。
Reddit r/MachineLearning · 79 天前
OpenAI 推出了 GeneBench-Pro,這是一項專門的基準測試,旨在評估 AI 模型在基因組學、生物學和科學研究方面的表現。它利用複雜的真實世界數據集來衡量在這些高風險領域的能力。
OpenAI News · 81 天前
這個最初源自 UC Berkeley 研究計畫的群眾外包 AI 排行榜,在推出首款商業產品僅八個月後,年化營收已達到 1 億美元。
The Next Web (TNW) · 81 天前
NormAct 是一項新的基準測試,旨在評估多模態大型語言模型 (MLLM) 在具身規劃中如何處理隱性社會規範。研究顯示,儘管模型能很好地達成明確目標,但在沒有特定干預的情況下,難以將隱性社會約束落地並應用。
ArXiv AI · 81 天前
OpenFinGym 是一個全新的統一環境,旨在評估跨多階段量化金融工作流程的 AI 代理。它提供了一個容器化且可驗證的平台,支援從預測到即時交易等多種任務。
ArXiv AI · 83 天前
MKG-RAG-Bench 是一個全新的跨領域基準測試,旨在評估多模態知識圖譜增強生成(MKG-RAG)中的檢索效能。它透過提供經過策劃的數據集來測試檢索與下游生成品質,解決了異質數據對齊這一關鍵瓶頸。
ArXiv AI · 83 天前
這篇研究論文分析了當前多模態 LLM 基準測試的局限性,這些測試往往無法評估跨模態整合能力。研究強調了在時空一致性和物理世界理解等領域建立更好評估指標的必要性。
ArXiv AI · 84 天前
這項研究提出了一種針對 AI Agent 的多維度評估框架,認為準確度飽和並不代表基準測試失去價值。研究引入了 CORE-Bench v1.1 及 OOD 套件,用於衡量效率、可靠性及人機協作表現。
ArXiv AI · 84 天前
Papers with Code 推出 OCR 集中化平台,收錄 Chandra OCR 2 與 Mistral OCR v4 等頂尖模型。該平台提供關鍵基準測試與程式碼連結,協助開發者在快速發展的文件數位化工具領域中進行選擇。
Reddit r/MachineLearning · 86 天前

DeepSWE 是一個全新的開源基準測試,旨在評估前沿 AI 模型在真實軟體工程任務中的表現。它強調無污染的任務設計、高度的儲存庫多樣性以及基於軟體行為的驗證機制。
Reddit r/MachineLearning · 86 天前
這項研究指出,目前針對 LLM Agent 的總分排行榜無法準確預測實際部署的效能。作者提出了一種基於預測效度與分佈外測試的新評估框架,以更精確地衡量 Agent 的能力。
ArXiv AI · 90 天前
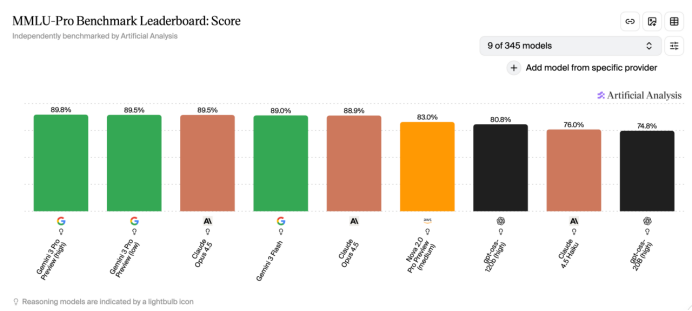
本文介紹了一位華人研究員在開發測試 AI 智慧的評估框架中所扮演的角色。強調了在當前 AI 發展環境中,嚴謹基準測試的重要性。
钛媒体 · 91 天前