來源虎嗅•較早收集於 23m
開源商業化破解AI知識公地悲劇
開源商業模式如何防AI公地資料濫用與模型鎖定(28字)
30 秒速覽
有什麼變化
AI知識涵蓋模型、權重、資料與算力基礎設施,具有高模組化易於重組。
為什麼重要
將獲利動機轉化為公地維護,實現永續AI生態,降低壟斷與偏見,提升創新普惠。
下一步行動
檢視Hugging Face上的Apache 2.0授權AI模型,用於下個專案以利用社群改進。
誰應關注:Founders & Product Leaders
關鍵要點
- •AI知識涵蓋模型、權重、資料與算力基礎設施,具有高模組化易於重組。
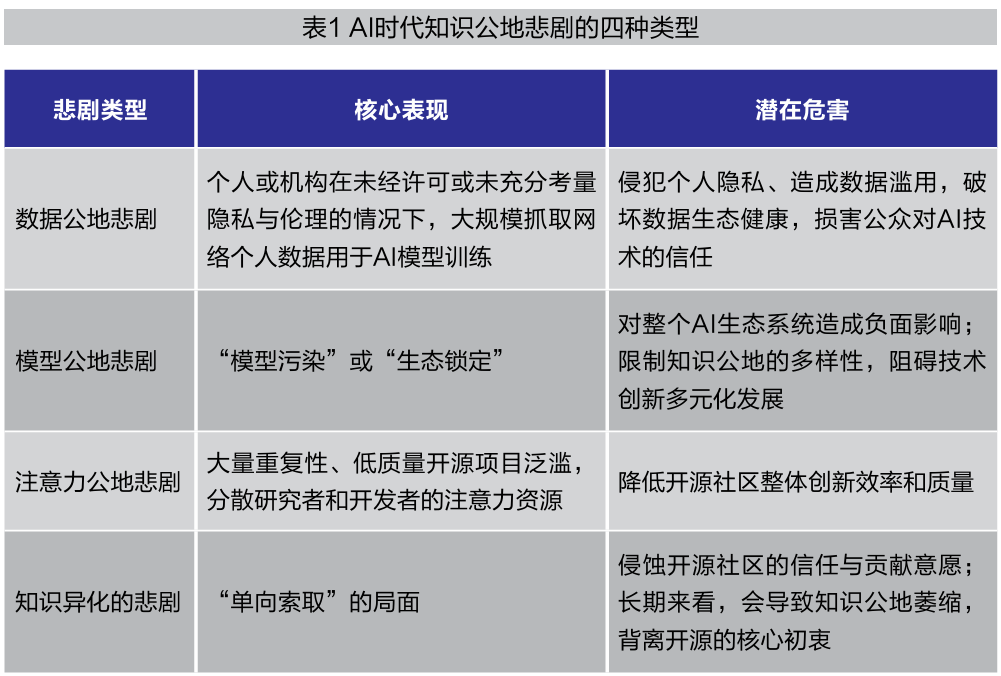
- •新悲劇:抓取資料侵犯隱私、模型偏見擴散、低品質專案導致的注意力悲劇。
- •MIT與Apache 2.0等開源許可證釐清權利,激勵商業貢獻維護公地。
- •AI動態演化需適應性治理處理偏見、黑箱問題與基礎設施差距。
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •AI知識公地正面臨『模型崩潰』(Model Collapse)的技術風險,即模型在訓練過程中過度使用AI生成的合成數據,導致輸出品質下降與多樣性喪失,這已成為開源生態治理的新挑戰。
- •歐盟《人工智慧法案》(EU AI Act)的實施,強制要求開源模型提供者需揭露訓練數據摘要,這改變了傳統開源許可證僅關注版權的模式,轉向合規性與透明度的治理框架。
- •去中心化運算網絡(如分散式GPU算力池)正成為解決算力壟斷與知識公地悲劇的技術路徑,透過代幣經濟學激勵個人貢獻算力,以降低對大型雲端供應商的依賴。
前景展望基於引用來源的 AI 分析
開源許可證將演變為包含『數據溯源』條款的混合型協議。
為了應對版權訴訟與合規壓力,未來的開源協議將強制要求模型發布者提供訓練數據集的元數據與來源證明。
合成數據過濾技術將成為開源模型發布的標準配置。
為防止模型崩潰,開源社群將強制導入自動化的數據品質檢測與去噪工具,以確保公地數據的純淨度。
時間線
2023-07
Meta發布Llama 2,標誌著開源大模型進入商業化與生態建設的新階段。
2024-03
Mistral AI發布開源模型,推動了歐洲開源AI生態與商業模式的結合。
2024-08
歐盟《人工智慧法案》正式生效,對開源AI模型的透明度義務做出明確規範。
2025-05
開源社群開始大規模採用『數據標記』技術,以應對AI生成內容污染訓練集的問題。
- 2023-07Meta發布Llama 2,標誌著開源大模型進入商業化與生態建設的新階段。
- 2024-03Mistral AI發布開源模型,推動了歐洲開源AI生態與商業模式的結合。
- 2024-08歐盟《人工智慧法案》正式生效,對開源AI模型的透明度義務做出明確規範。
- 2025-05開源社群開始大規模採用『數據標記』技術,以應對AI生成內容污染訓練集的問題。
AI 週報
閱讀本週精選 AI 大事摘要 →
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: 虎嗅 ↗
每週電子報
每週一封,可隨時退訂。