來源Ifanr (爱范儿)•較早收集於 23m
記憶體正在毀掉一切

洞察記憶體危機如何威脅 AI 基礎設施擴展性(24字)
30 秒速覽
有什麼變化
記憶體被描繪為科技界的破壞力量
為什麼重要
記憶體限制可能加劇 AI 硬體成本,並限制大型模型的擴展。
下一步行動
在 TrendForce 等網站追蹤 DRAM 價格趨勢,用於 AI 伺服器預算。
誰應關注:Enterprise & Security Teams
關鍵要點
- •記憶體被描繪為科技界的破壞力量
- •預示一個關鍵行業的終結
- •推廣訂閱愛範兒微信公眾號
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •記憶體瓶頸(Memory Wall)已成為當前 AI 模型推論與訓練的主要效能限制,導致運算單元(GPU/NPU)因等待數據傳輸而閒置。
- •隨著大語言模型參數規模呈指數級增長,傳統馮·紐曼架構中處理器與記憶體分離的設計,導致了嚴重的能源損耗與延遲問題。
- •業界正轉向存內運算(Computing-in-Memory, CIM)與高頻寬記憶體(HBM3e/HBM4)技術,試圖從硬體架構層面解決記憶體頻寬不足的根本性矛盾。
前景展望基於引用來源的 AI 分析
存內運算技術將成為未來 AI 晶片的主流架構。
為了消除數據搬移帶來的延遲與功耗,將運算單元直接整合進記憶體陣列是解決記憶體牆問題的唯一路徑。
記憶體頻寬將取代原始運算能力(FLOPS)成為衡量 AI 晶片效能的核心指標。
在當前模型規模下,數據傳輸速度已成為系統效能的決定性瓶頸,而非單純的算力堆疊。
時間線
2023-03
NVIDIA 發布 H100 GPU,首次將 HBM3 記憶體頻寬提升至 TB/s 等級以應對 AI 需求。
2024-02
JEDEC 正式發布 HBM3E 標準,進一步推動記憶體頻寬以支援更大規模的參數模型。
2025-09
業界開始大規模測試 HBM4 堆疊技術,旨在解決 3D 封裝下的散熱與傳輸瓶頸。
- 2023-03NVIDIA 發布 H100 GPU,首次將 HBM3 記憶體頻寬提升至 TB/s 等級以應對 AI 需求。
- 2024-02JEDEC 正式發布 HBM3E 標準,進一步推動記憶體頻寬以支援更大規模的參數模型。
- 2025-09業界開始大規模測試 HBM4 堆疊技術,旨在解決 3D 封裝下的散熱與傳輸瓶頸。
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態
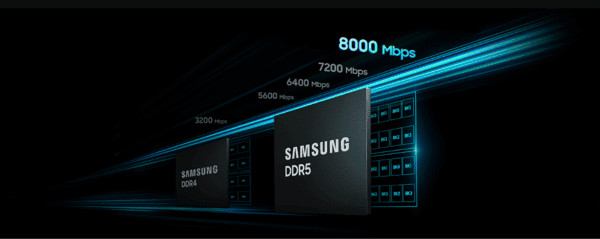
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: Ifanr (爱范儿) ↗
每週電子報
每週一封,可隨時退訂。