來源Pandaily•較早收集於 75m
華為開源 920 億參數 openPangu-2.0-Flash 模型
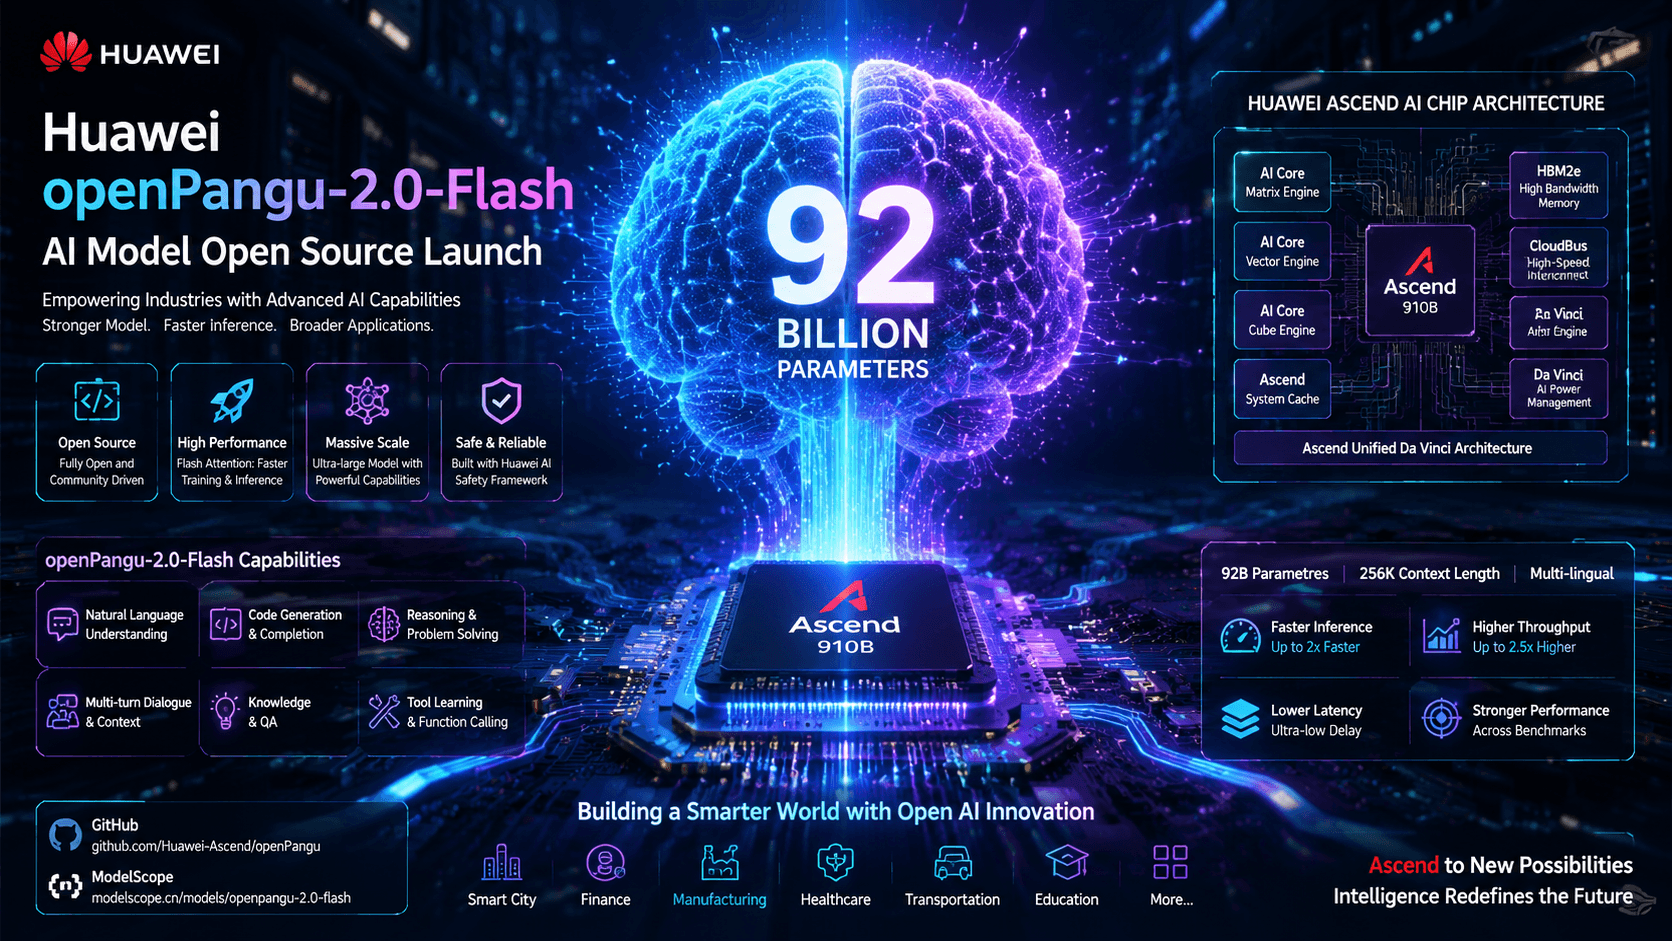
華為推出 92B 開源模型,為大規模企業 AI 部署提供了重要的全新選擇。
30 秒速覽
有什麼變化
模型規模達到 920 億參數
為什麼重要
華為提供的 92B 參數模型為企業級應用提供了強大的替代方案,可能對現有的開源權重模型構成挑戰。
下一步行動
下載 openPangu-2.0-Flash 權重,並針對您的特定企業用例與 Llama 3 或 Qwen 模型進行基準測試。
誰應關注:Developers & AI Engineers
關鍵要點
- •模型規模達到 920 億參數
- •華為 AI 生態系統的策略性擴張
- •作為開源資源提供給開發者使用
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •openPangu-2.0-Flash 採用了華為自研的昇騰(Ascend)AI 處理器架構進行訓練與優化,強調在國產硬體上的推理效率。
- •該模型特別針對長文本處理與複雜邏輯推理進行了架構調整,旨在降低企業級應用中的延遲與運算成本。
- •華為透過 MindSpore 開源框架發布此模型,進一步鞏固其軟硬體垂直整合的生態戰略。
- •模型採用了混合專家模型(MoE)架構的變體,以在保持 920 億參數規模的同時,實現更快的推理速度與更低的記憶體佔用。
- •此開源舉措包含完整的模型權重、訓練腳本及推理部署指南,旨在吸引學術界與工業界開發者參與昇騰生態的建設。
競品分析
參數規模
- openPangu-2.0-Flash
- 920B
- Llama 3.1 (70B/405B)
- 70B / 405B
- Qwen2.5-72B
- 72B
硬體優化
- openPangu-2.0-Flash
- 昇騰 (Ascend)
- Llama 3.1 (70B/405B)
- NVIDIA GPU
- Qwen2.5-72B
- 通用 GPU
開源授權
- openPangu-2.0-Flash
- 華為開源協議
- Llama 3.1 (70B/405B)
- Llama 3 協議
- Qwen2.5-72B
- Apache 2.0
核心優勢
- openPangu-2.0-Flash
- 國產算力生態整合
- Llama 3.1 (70B/405B)
- 全球生態與工具鏈
- Qwen2.5-72B
- 多語言與編碼能力
| 特性 | openPangu-2.0-Flash | Llama 3.1 (70B/405B) | Qwen2.5-72B |
|---|---|---|---|
| 參數規模 | 920B | 70B / 405B | 72B |
| 硬體優化 | 昇騰 (Ascend) | NVIDIA GPU | 通用 GPU |
| 開源授權 | 華為開源協議 | Llama 3 協議 | Apache 2.0 |
| 核心優勢 | 國產算力生態整合 | 全球生態與工具鏈 | 多語言與編碼能力 |
技術深入
- 架構類型:基於 MoE (Mixture of Experts) 的高效能 Transformer 變體。
- 訓練框架:完全基於 MindSpore 框架開發,支援昇騰 910 系列晶片的分散式訓練。
- 推理優化:整合了昇騰算子庫 (ACL) 與深度模型壓縮技術,支援 FP8 與 INT8 量化部署。
- 序列長度:支援超長上下文視窗,針對工業級文件分析進行了注意力機制優化。
- 部署要求:針對昇騰環境進行了記憶體池化與算子融合,顯著提升了在單卡與多卡環境下的吞吐量。
前景展望基於引用來源的 AI 分析
華為將加速國產 AI 算力在金融與政務領域的滲透率。
透過開源高效能模型,華為能降低企業導入國產 AI 基礎設施的技術門檻與遷移成本。
MindSpore 生態將在開源社群中獲得顯著的開發者貢獻增長。
提供具備競爭力的開源模型權重是吸引開發者從 PyTorch/TensorFlow 轉向 MindSpore 的關鍵驅動力。
時間線
2021-04
華為正式發布盤古(Pangu)大模型系列。
2023-07
華為發布盤古大模型 3.0,強調面向行業場景的應用。
2024-09
華為持續更新盤古系列,並強化昇騰算力與模型的軟硬體協同。
2026-06
華為正式開源 openPangu-2.0-Flash 模型。
- 2021-04華為正式發布盤古(Pangu)大模型系列。
- 2023-07華為發布盤古大模型 3.0,強調面向行業場景的應用。
- 2024-09華為持續更新盤古系列,並強化昇騰算力與模型的軟硬體協同。
- 2026-06華為正式開源 openPangu-2.0-Flash 模型。
事件追蹤
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: Pandaily ↗
每週電子報
每週一封,可隨時退訂。