來源PyTorch Blog•較早收集於 33m
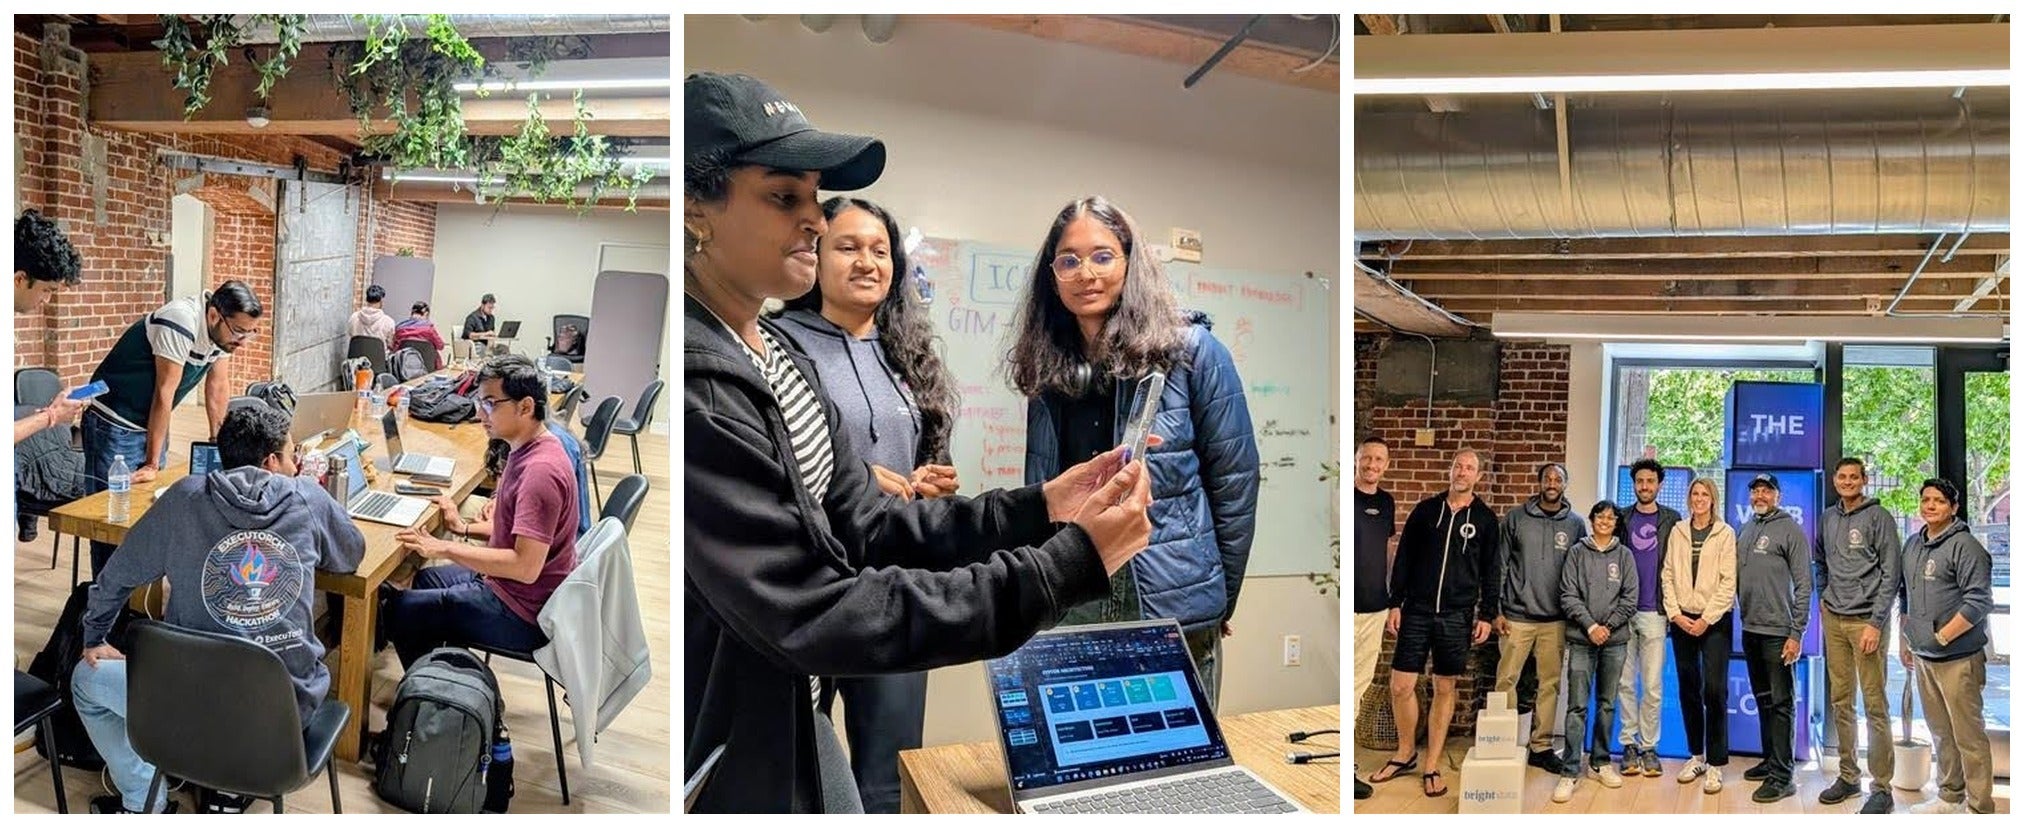
ExecuTorch 黑客松聚焦裝置端 AI 的未來
#on-device-ai#edge-computing#mobile-devexecutorchpytorchexecutorch
了解開發者如何利用 ExecuTorch 將 PyTorch 模型優化並部署於行動與邊緣裝置。
30 秒速覽
有什麼變化
匯集行動開發者與 AI 從業人員共同打造裝置端解決方案
為什麼重要
此活動顯示產業正強烈推動本地化、具隱私保護的 AI 執行方案。它鼓勵開發者超越雲端推論,轉而針對硬體限制優化模型。
下一步行動
探索 ExecuTorch 文件,開始將您現有的 PyTorch 模型移植到行動裝置上進行部署。
誰應關注:Developers & AI Engineers
關鍵要點
- •匯集行動開發者與 AI 從業人員共同打造裝置端解決方案
- •專注於邊緣 AI 部署的實務挑戰
- •展示了 ExecuTorch 框架在行動環境中的功能與潛力
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •ExecuTorch 是 PyTorch Edge 的核心執行環境,旨在解決從訓練到邊緣裝置部署的碎片化問題,提供統一的編譯與執行路徑。
- •該框架特別針對記憶體受限的環境進行了優化,透過靜態記憶體規劃(Static Memory Planning)顯著降低了執行時的記憶體開銷。
- •ExecuTorch 支援多種硬體後端,包括 ARM CPU、DSP 以及各類 NPU,並透過模組化的抽象層簡化了跨硬體平台的移植工作。
- •黑客松期間展示了將大型語言模型(LLM)與視覺模型量化後在行動裝置上實現即時推論的技術,驗證了其在低功耗場景下的效能。
- •該專案強調與 PyTorch 2.x 生態系統的深度整合,開發者可直接利用 PyTorch 的編譯器堆疊(如 AOTInductor)進行模型優化。
競品分析
主要優勢
- ExecuTorch
- PyTorch 原生整合
- TensorFlow Lite
- 成熟的生態與硬體支援
- ONNX Runtime
- 跨框架通用性
部署目標
- ExecuTorch
- 邊緣裝置/行動端
- TensorFlow Lite
- 行動端/IoT
- ONNX Runtime
- 跨平台/伺服器/邊緣
效能優化
- ExecuTorch
- 靜態記憶體規劃
- TensorFlow Lite
- 量化工具鏈豐富
- ONNX Runtime
- 圖優化與執行加速
| 特性 | ExecuTorch | TensorFlow Lite | ONNX Runtime |
|---|---|---|---|
| 主要優勢 | PyTorch 原生整合 | 成熟的生態與硬體支援 | 跨框架通用性 |
| 部署目標 | 邊緣裝置/行動端 | 行動端/IoT | 跨平台/伺服器/邊緣 |
| 效能優化 | 靜態記憶體規劃 | 量化工具鏈豐富 | 圖優化與執行加速 |
技術深入
- 採用 AOTInductor 作為編譯核心,將 PyTorch 模型轉換為高效的 C++ 程式碼。
- 支援多種量化技術,包括權重僅量化(Weight-only quantization)與動態量化,以適應邊緣裝置的算力限制。
- 提供輕量級的執行時函式庫(Runtime Library),核心二進位檔案大小極小,適合嵌入式系統。
- 透過 Delegate 機制,允許將模型的部分運算圖(Subgraphs)卸載至專用硬體加速器(如 NPU)。
前景展望基於引用來源的 AI 分析
裝置端 AI 將成為主流應用開發標準
隨著 ExecuTorch 等框架降低部署門檻,開發者將更傾向於在本地端處理敏感數據以提升隱私與響應速度。
硬體抽象層將加速邊緣 AI 晶片普及
統一的軟體框架減少了針對特定晶片進行底層優化的成本,將推動更多硬體廠商投入邊緣 AI 晶片市場。
時間線
2023-10
PyTorch 官方正式發布 ExecuTorch 預覽版,旨在取代舊有的 PyTorch Mobile。
2024-05
ExecuTorch 進入 Beta 階段,強化了對行動端 LLM 推論的支援與效能優化。
2025-02
ExecuTorch 正式發布穩定版本,並擴大對多種邊緣硬體加速器的原生支援。
- 2023-10PyTorch 官方正式發布 ExecuTorch 預覽版,旨在取代舊有的 PyTorch Mobile。
- 2024-05ExecuTorch 進入 Beta 階段,強化了對行動端 LLM 推論的支援與效能優化。
- 2025-02ExecuTorch 正式發布穩定版本,並擴大對多種邊緣硬體加速器的原生支援。
AI 週報
閱讀本週精選 AI 大事摘要 →
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: PyTorch Blog ↗
每週電子報
每週一封,可隨時退訂。