來源The Next Web (TNW)•較早收集於 31m
DeepMind 押注能自我改進的機器
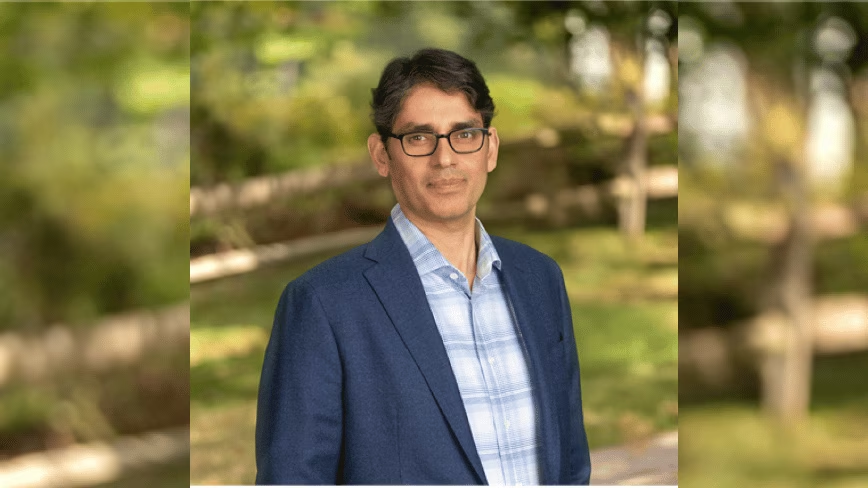
#ai-strategy#ai-safetygoogle-deepmind-recursive-self-improvement-researchgoogle-deepmindjasjeet-sekhon
DeepMind 策略主管解釋,AI 投資為何可能瞄準能自我提升能力的系統。
30 秒速覽
有什麼變化
Google DeepMind 將數兆美元的 AI 投資與能自我改進的機器連結起來。
為什麼重要
如果遞迴式自我改進成為可行技術,AI 開發可能透過能改進模型、工具或訓練流程的系統而加速。同時,這也會帶來評估、控制、安全性,以及判斷能力提升是否可靠等重大挑戰。
下一步行動
在允許任何內部代理修改提示詞、程式碼或訓練流程前,加入自動化回歸測試、能力評估與回復檢查點。
誰應關注:Researchers & Academics
關鍵要點
- •Google DeepMind 將數兆美元的 AI 投資與能自我改進的機器連結起來。
- •討論核心是遞迴式自我改進(RSI)。
- •Jasjeet Sekhon 在 UC Berkeley 舉辦的峰會上提出這項觀點。
- •摘要將 RSI 描述為策略方向,而非已推出的產品。
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •遞迴式自我改進(RSI)的概念源於人工智慧安全領域,旨在透過 AI 系統自動優化其自身的演算法與架構,以實現智慧爆炸(Intelligence Explosion)。
- •DeepMind 的策略轉向反映了業界對於『擴展定律』(Scaling Laws)邊際效益遞減的擔憂,促使研究重心從單純增加算力轉向提升模型推理與自我學習效率。
- •Jasjeet Sekhon 強調此類系統的安全性與對齊(Alignment)是開發過程中的首要挑戰,因為自我改進可能導致系統行為變得不可預測。
- •學術界與產業對於 RSI 的可行性存在爭議,部分專家認為目前的深度學習架構在缺乏外部監督的情況下,難以實現實質性的自我演化。
- •Google DeepMind 正在探索將強化學習(Reinforcement Learning)與自動化機器學習(AutoML)技術結合,作為實現遞迴式自我改進的基礎技術路徑。
競品分析
OpenAI
- 核心策略
- 專注於推理模型(o1 系列)與系統2思維
- 自我改進技術路徑
- 透過強化學習進行過程監督(Process Supervision)
- 備註
- 側重於提升推理能力而非架構自我重寫
Anthropic
- 核心策略
- 強調憲法 AI(Constitutional AI)與安全性
- 自我改進技術路徑
- 透過 AI 監督 AI 進行對齊與自我修正
- 備註
- 專注於安全性與價值對齊
Meta (FAIR)
- 核心策略
- 開源生態與基礎模型研究
- 自我改進技術路徑
- 探索自我監督學習(Self-Supervised Learning)
- 備註
- 較少公開提及遞迴式自我改進目標
| 競爭對手 | 核心策略 | 自我改進技術路徑 | 備註 |
|---|---|---|---|
| OpenAI | 專注於推理模型(o1 系列)與系統2思維 | 透過強化學習進行過程監督(Process Supervision) | 側重於提升推理能力而非架構自我重寫 |
| Anthropic | 強調憲法 AI(Constitutional AI)與安全性 | 透過 AI 監督 AI 進行對齊與自我修正 | 專注於安全性與價值對齊 |
| Meta (FAIR) | 開源生態與基礎模型研究 | 探索自我監督學習(Self-Supervised Learning) | 較少公開提及遞迴式自我改進目標 |
技術深入
- 遞迴式自我改進的核心機制涉及模型對自身權重、超參數或架構定義進行修改,並透過環境回饋進行驗證。
- 實作上可能利用元學習(Meta-Learning)演算法,讓模型學習如何學習,進而優化其學習過程。
- 涉及自動化架構搜尋(NAS)技術的演進,使模型能夠在訓練過程中動態調整神經網路層數與連接方式。
- 依賴於高精度的模擬環境或形式化驗證(Formal Verification)工具,以確保自我改進後的模型不會產生災難性遺忘或對齊失效。
前景展望基於引用來源的 AI 分析
AI 研發成本將從算力支出轉向演算法自動化研發
若自我改進技術成熟,模型開發將減少對人類工程師手動調整的依賴,大幅降低長期維運成本。
AI 安全監管將面臨定義與執法困境
具備自我改進能力的系統其行為具有動態變化特性,現行的靜態模型審查機制將無法有效評估其風險。
時間線
2014-01
Google 收購 DeepMind,開始佈局通用人工智慧(AGI)研究。
2016-03
AlphaGo 擊敗李世乭,展示了強化學習在複雜決策中的強大潛力。
2023-04
Google Brain 與 DeepMind 合併為 Google DeepMind,整合資源加速 AGI 開發。
2024-12
DeepMind 發布關於模型自我對弈與推理能力提升的相關研究成果。
2026-05
Jasjeet Sekhon 在 UC Berkeley 峰會上公開討論遞迴式自我改進的長期願景。
- 2014-01Google 收購 DeepMind,開始佈局通用人工智慧(AGI)研究。
- 2016-03AlphaGo 擊敗李世乭,展示了強化學習在複雜決策中的強大潛力。
- 2023-04Google Brain 與 DeepMind 合併為 Google DeepMind,整合資源加速 AGI 開發。
- 2024-12DeepMind 發布關於模型自我對弈與推理能力提升的相關研究成果。
- 2026-05Jasjeet Sekhon 在 UC Berkeley 峰會上公開討論遞迴式自我改進的長期願景。
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: The Next Web (TNW) ↗
每週電子報
每週一封,可隨時退訂。