來源SCMP Technology•最新收集於 9h
中國研究人員繪製自我改進 AI 五階段路線圖
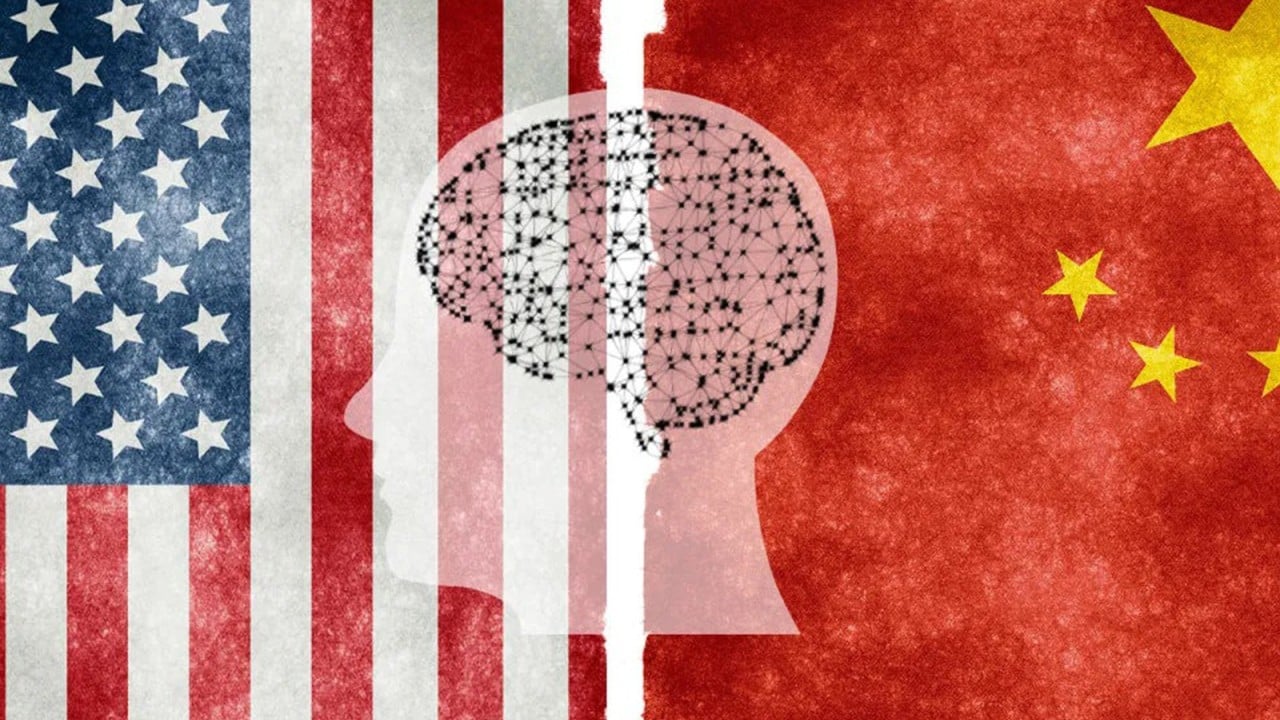
#self-improvement#ai-research#model-optimizationrecursive-self-improvement-roadmapbytedancetsinghua-universityshanghai-ai-lab
五階段路線圖將遞迴自我改進描繪成可執行的研究計畫。
30 秒速覽
有什麼變化
論文提出遞迴自我改進的五個階段。
為什麼重要
這份路線圖可能影響自動化編程、評估與模型設計的研究優先順序。它也帶來驗證、控制,以及如何可靠衡量自我改進主張等重大問題。
下一步行動
對任何允許 AI 代理修改模型程式碼或訓練管線的實驗,加入獨立評估與回滾門檻。
誰應關注:Researchers & Academics
關鍵要點
- •論文提出遞迴自我改進的五個階段。
- •參與者包括 ByteDance、清華大學與上海人工智能實驗室。
- •目標是讓 AI 系統自主改進後繼系統。
深度解析
背景與延伸:來自公開資料,非原文內容。引用 8 個來源。
增強重點摘要
- •該論文標題為《人類構建的最後一個 AI:邁向真正的遞迴自我改進》(arXiv:2609.11873),由來自字節跳動、清華大學、上海人工智慧實驗室及上海交通大學等 33 位研究人員共同發表。
- •論文明確區分了「真正的遞迴自我改進(RSI)」與常規的上下文學習,強調改進成果必須超越單次對話會話並由後續模型世代繼承,且全程無需人類干預。
- •在該論文發布前,中國產業界已有多個自主研發成果,包括智譜 AI 創辦人唐傑宣布 GLM-6 實現全自主生命週期訓練、MiniMax M3 模型自主優化 GPU 核心,以及 DeepSeek 釋出自導多步驟程式編寫的代理框架。
- •美國頂尖實驗室亦在推進類似方向,如 OpenAI 推出具備自主深度學習實驗能力的 GPT-6 Astra,以及 Google DeepMind 發布針對自動化軟體工程與多步推理的 Gemini 3.8 Flash。
- •在美國 AI 領袖呼籲針對 RSI 進行產業自主放緩以防範對齊風險之際,中國研究界與評論反對單方面放緩,認為這將鞏固矽谷既有優勢並限制後進者競爭空間。
競品分析
中國聯合研究團隊 (字節跳動、清華、上海 AI 實驗室等)
- 代表模型或專案
- 五階段 RSI 路線圖理論框架、GLM-6、MiniMax M3
- 自主研究與自我改進能力重點
- 提出從嚴格執行規則到第 5 階段「遞迴元改進」的自主層級體系;在有限架構下具備高度演算法效率
- 算力與技術優勢 / 劣勢
- 演算法調優與效率突出,但受限於高階算力集群取得,進行大規模端到端 RSI 閉環驗證受阻
OpenAI
- 代表模型或專案
- GPT-6 Astra
- 自主研究與自我改進能力重點
- 構建「自動化 AI 研究員」,能獨立執行深度學習實驗,推進研究自動化
- 算力與技術優勢 / 劣勢
- 具備龐大算力集群優勢,但在確保「對齊且完全受控的 RSI」安全邊界上仍處於摸索階段
Google DeepMind
- 代表模型或專案
- Gemini 3.8 Flash
- 自主研究與自我改進能力重點
- 著重複雜多步驟推理與自動化軟體工程,作為自我改進的核心技術躍升
- 算力與技術優勢 / 劣勢
- 擁有領先的算力基礎設施與全端工程研發鏈,推進自主訓練管線實踐
Anthropic
- 代表模型或專案
- Claude 系列模型
- 自主研究與自我改進能力重點
- 模型日益參與內部後訓練(post-training)實驗設計與訓練代碼撰寫
- 算力與技術優勢 / 劣勢
- 在 AI 安全性與對齊規範領先,但受制於嚴格的安全評估與放緩倡議
| 機構 / 陣營 | 代表模型或專案 | 自主研究與自我改進能力重點 | 算力與技術優勢 / 劣勢 |
|---|---|---|---|
| 中國聯合研究團隊 (字節跳動、清華、上海 AI 實驗室等) | 五階段 RSI 路線圖理論框架、GLM-6、MiniMax M3 | 提出從嚴格執行規則到第 5 階段「遞迴元改進」的自主層級體系;在有限架構下具備高度演算法效率 | 演算法調優與效率突出,但受限於高階算力集群取得,進行大規模端到端 RSI 閉環驗證受阻 |
| OpenAI | GPT-6 Astra | 構建「自動化 AI 研究員」,能獨立執行深度學習實驗,推進研究自動化 | 具備龐大算力集群優勢,但在確保「對齊且完全受控的 RSI」安全邊界上仍處於摸索階段 |
| Google DeepMind | Gemini 3.8 Flash | 著重複雜多步驟推理與自動化軟體工程,作為自我改進的核心技術躍升 | 擁有領先的算力基礎設施與全端工程研發鏈,推進自主訓練管線實踐 |
| Anthropic | Claude 系列模型 | 模型日益參與內部後訓練(post-training)實驗設計與訓練代碼撰寫 | 在 AI 安全性與對齊規範領先,但受制於嚴格的安全評估與放緩倡議 |
技術深入
- RSI 五階段自治層級架構:
- 第 1 階段:AI 僅嚴格執行由人類工程師預先定義的改進工作流程與腳本。
- 第 2 階段:AI 能在既有可行策略庫中自主選擇「如何」進行升級,而非僅依循固定指令。
- 第 3 至 4 階段:模型在部署後能自主判斷與探索「何種」新數據、經驗或環境以進行調適與自我迭代。
- 第 5 階段(遞迴元改進,Recursive Meta-Improvement):AI 能持續自我修改與優化用於開發和改進 AI 本身的底層元演算法及核心方法。
- 真偽 RSI 判定標準:排除單次推理或會話內的短期上下文修正,技術標準要求系統在無人類介入下,產生的優化成果必須持久固化並傳承至下一代模型權重或架構。
前景展望基於引用來源的 AI 分析
算力基礎設施的差距將迫使中方團隊將焦點放在高效率的演算法創新與架構壓縮上
由於先進算力集群受限,中國研究機構難以直接複製美方超大規模蠻力試錯的 RSI 實驗,因而優先攻克元演算法優化與自適應架構。
中美在 AI 安全自主放緩(Pacing)議題上的地緣政治分歧將加劇技術標準脫鉤
美方機構提倡放緩前沿 RSI 開發以確保對齊,而中方擔憂此舉旨在鞏固技術壁壘,雙方難以在遞迴自我改進的安全規範上達成統一共識。
時間線
2026-08
智譜 AI 宣布 GLM-6 實現全自主生命週期自訓練架構
2026-09
MiniMax 與 DeepSeek 先後展示 GPU 核心自主優化與自導實驗代理技術
2026-09
字節跳動與清華大學等機構聯合發表論文《人類構建的最後一個 AI》,正式提出 RSI 五階段路線圖
- 2026-08智譜 AI 宣布 GLM-6 實現全自主生命週期自訓練架構
- 2026-09MiniMax 與 DeepSeek 先後展示 GPU 核心自主優化與自導實驗代理技術
- 2026-09字節跳動與清華大學等機構聯合發表論文《人類構建的最後一個 AI》,正式提出 RSI 五階段路線圖
來源 (8)
Factual claims are grounded in the sources below. Forward-looking analysis is AI-generated interpretation.
1Chinese Researchers Chart Five Stage Path Toward Last AI Built Humansscmp.com2Watchyoutube.com3Chinese Researchers AI Self Improvement Roadmap 1819681ibtimes.co.uk4US and China Are Racing Build Self Improving AI Heres Whats Stakescmp.com5US and China Are Racing Build Self Improving AI Heres Whats Stakescmp.com6How Chinese Researchers Plan to Buildrecodechinaai.com7US China AI Self Improvement Race Reignites AI Extinction Theorydigitaltoday.co.kr8China Rejects Calls Pacing AI Development Fearing It Would Entrench US Tech Leadscmp.com
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態


AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: SCMP Technology ↗
每週電子報
每週一封,可隨時退訂。