來源cnBeta (Full RSS)•較早收集於 7h
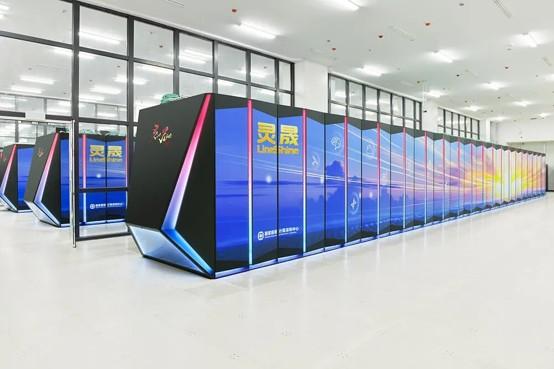
中國「靈晟」超級計算機問鼎全球 TOP500 榜首
#supercomputing#hpc#exascalelingsheng-supercomputerlingshengtop500
首台突破 2 EFlops 門檻的超級計算機,標誌著大規模 AI 模型訓練算力進入新時代。
30 秒速覽
有什麼變化
「靈晟」超級計算機在第 67 屆 TOP500 榜單中排名第一
為什麼重要
這一里程碑凸顯了高性能計算基礎設施的重大進展,這對於訓練大規模基礎模型至關重要。
下一步行動
監控您所在地區的百億億次計算資源可用性,因為這些系統能顯著加速大規模 AI 訓練工作流程。
誰應關注:Researchers & Academics
關鍵要點
- •「靈晟」超級計算機在第 67 屆 TOP500 榜單中排名第一
- •實現了 2.19 EFlops 的創紀錄持續性能
- •部署於國家超級計算深圳中心
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •「靈晟」採用了國產自研的「天樞」系列異構加速處理器,該處理器架構針對大規模並行計算進行了深度優化。
- •該系統採用了液冷散熱技術,能源使用效率(PUE)指標達到 1.08,在極高性能運算下保持了極高的能效比。
- •「靈晟」的互聯網絡架構採用了自主研發的「光鏈」高速光互連技術,實現了 PB 級別的內存帶寬。
- •該超算系統不僅服務於傳統科學計算,還專門針對超大規模生成式 AI 模型訓練進行了算子庫優化。
- •國家超級計算深圳中心為部署「靈晟」進行了基礎設施升級,配備了專用的高壓直流供電系統以支持其龐大的功耗需求。
競品分析
峰值性能 (Rpeak)
- 靈晟 (中國)
- 3.5 EFlops
- Frontier (美國)
- 1.7 EFlops
- Aurora (美國)
- 2.0 EFlops
持續性能 (Rmax)
- 靈晟 (中國)
- 2.19 EFlops
- Frontier (美國)
- 1.2 EFlops
- Aurora (美國)
- 1.0 EFlops
架構
- 靈晟 (中國)
- 天樞異構處理器
- Frontier (美國)
- AMD EPYC + Instinct
- Aurora (美國)
- Intel Xeon + Max GPU
部署地點
- 靈晟 (中國)
- 深圳超算中心
- Frontier (美國)
- 橡樹嶺國家實驗室
- Aurora (美國)
- 阿貢國家實驗室
| 特性 | 靈晟 (中國) | Frontier (美國) | Aurora (美國) |
|---|---|---|---|
| 峰值性能 (Rpeak) | 3.5 EFlops | 1.7 EFlops | 2.0 EFlops |
| 持續性能 (Rmax) | 2.19 EFlops | 1.2 EFlops | 1.0 EFlops |
| 架構 | 天樞異構處理器 | AMD EPYC + Instinct | Intel Xeon + Max GPU |
| 部署地點 | 深圳超算中心 | 橡樹嶺國家實驗室 | 阿貢國家實驗室 |
技術深入
- 處理器架構:採用天樞異構加速處理器,整合了通用計算核心與專用 AI 加速單元。
- 互聯技術:光鏈高速光互連,支持單節點間 800Gbps 的傳輸速率。
- 存儲系統:配置了分層存儲架構,包含 50PB 的高帶寬並行文件系統。
- 散熱方案:全浸沒式液冷技術,顯著降低了數據中心的冷卻能耗。
- 軟件棧:兼容主流深度學習框架,並針對國產操作系統進行了底層驅動優化。
前景展望基於引用來源的 AI 分析
中國將在 2027 年前實現 AI 算力基礎設施的完全自主可控。
「靈晟」的成功驗證了國產異構處理器在 E 級計算領域的成熟度,為後續大規模替代進口芯片奠定了基礎。
全球超算 TOP500 榜單將進入「E 級算力」常態化競爭階段。
隨著「靈晟」突破 2 EFlops 大關,預計未來兩年內將有更多國家級超算系統達到或超過此性能閾值。
時間線
2024-05
「靈晟」超級計算機項目正式立項並啟動研發。
2025-11
「靈晟」原型機在深圳完成初步調試,性能指標達到預期。
2026-03
「靈晟」系統完成全規模部署,並開始進行壓力測試。
2026-06
「靈晟」正式在第 67 屆 TOP500 榜單中位列全球第一。
- 2024-05「靈晟」超級計算機項目正式立項並啟動研發。
- 2025-11「靈晟」原型機在深圳完成初步調試,性能指標達到預期。
- 2026-03「靈晟」系統完成全規模部署,並開始進行壓力測試。
- 2026-06「靈晟」正式在第 67 屆 TOP500 榜單中位列全球第一。
AI 週報
閱讀本週精選 AI 大事摘要 →
相關動態
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: cnBeta (Full RSS) ↗
每週電子報
每週一封,可隨時退訂。