來源钛媒体•較早收集於 23m
前沿模型進入月拋時代?
#model-evaluation#model-selection#inference-cost大型語言模型large-language-models
模型排名正在更快失效,持續評測已成為每個 AI 產品團隊的必需品。
30 秒速覽
有什麼變化
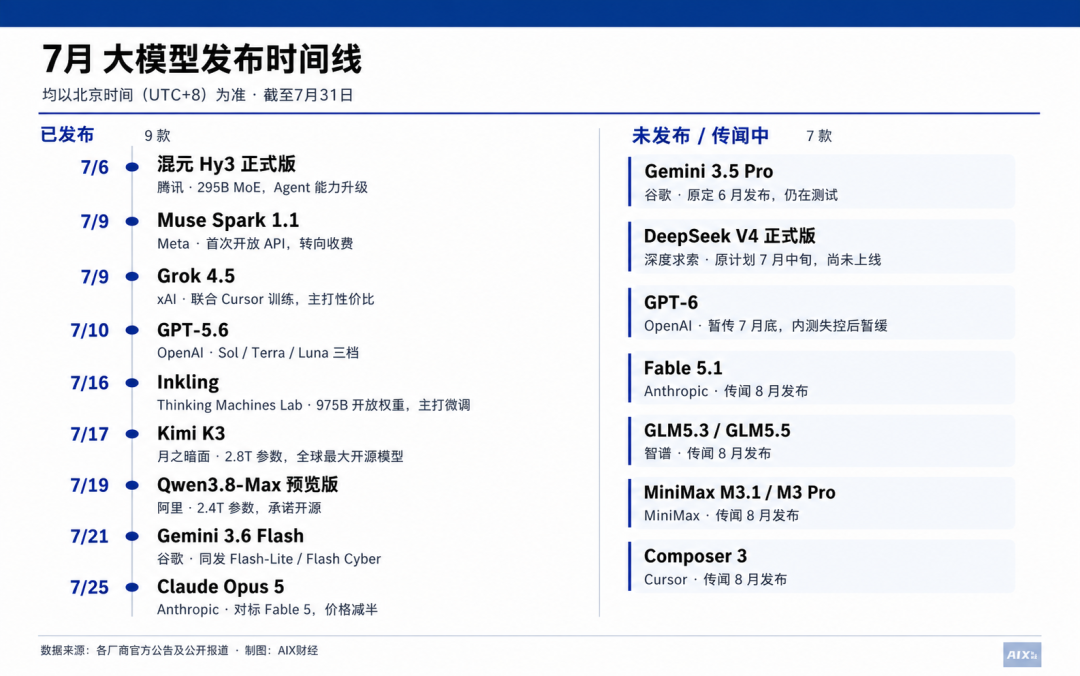
據稱單月內出現了 9 款旗艦級模型。
為什麼重要
模型快速更替會讓團隊更難固定使用單一供應商或基準。AI 開發者需要更完善的抽象層、回歸測試與成本效能監控,以避免昂貴的遷移。
下一步行動
建立每月評測流程,從品質、延遲、Token 成本與失敗率等指標,比較生產環境模型與至少兩個替代方案。
誰應關注:Developers & AI Engineers
關鍵要點
- •據稱單月內出現了 9 款旗艦級模型。
- •最強模型的競爭地位正變得更加短暫。
- •頻繁發布可能提高採用者的評測、遷移與基礎設施成本。
- •模型選型正從一次性的排名比較,轉向持續評測與替換。
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •模型發布頻率的激增主要源於『蒸餾技術』與『合成數據』的普及,使得開發者能以更低成本快速迭代模型版本。
- •企業端出現了『模型不可知論』(Model-Agnostic)架構趨勢,透過中間層 API 路由技術,讓系統能在不更動底層代碼的情況下自動切換至當前效能最佳的模型。
- •開源模型(如 Llama 系列與 Mistral)的快速追趕,迫使閉源模型廠商必須縮短發布週期以維持市場溢價與競爭優勢。
- •AI 基礎設施供應商(如雲端服務商)開始提供『模型即服務』(MaaS)的自動化升級工具,以緩解企業頻繁遷移模型的技術負債。
- •評測基準(Benchmarks)出現了嚴重的『過擬合』現象,導致靜態排行榜已無法準確反映模型在複雜真實場景中的實際表現。
技術深入
- 混合專家模型(MoE)架構成為主流,透過動態激活參數路徑,在保持模型規模的同時顯著降低了推理延遲。
- 提示詞工程(Prompt Engineering)正逐漸被『上下文學習』(In-Context Learning)與『長文本檢索增強生成』(Long-context RAG)技術取代,以適應模型頻繁更迭帶來的行為差異。
- 模型權重量化技術(如 4-bit/8-bit 量化)已成為標準配置,大幅降低了在邊緣設備上部署旗艦級模型的硬體門檻。
- 訓練數據的『去污染』與『去重』流程成為模型效能差異化的關鍵,而非僅僅依賴訓練數據的總量。
前景展望基於引用來源的 AI 分析
企業將全面轉向『模型組合策略』而非單一供應商鎖定。
由於單一模型無法長期保持領先,企業將透過路由層同時調用多個模型以平衡成本與效能。
模型評測產業將從靜態排行榜轉向動態、場景化的自動化測試。
通用基準測試已無法滿足企業對特定業務場景的精確需求,客製化評測集將成為剛需。
時間線
2023-11
OpenAI 發布 GPT-4 Turbo,開啟了模型快速迭代與長上下文窗口的競爭序幕。
2024-07
Llama 3.1 系列發布,標誌著開源模型在旗艦級效能上首次大規模挑戰閉源模型。
2025-03
業界開始大規模採用模型路由(Model Routing)技術,以應對模型發布週期縮短帶來的遷移壓力。
2026-02
多個頂級實驗室在單月內密集發布多款旗艦模型,標誌著『月拋時代』的正式到來。
- 2023-11OpenAI 發布 GPT-4 Turbo,開啟了模型快速迭代與長上下文窗口的競爭序幕。
- 2024-07Llama 3.1 系列發布,標誌著開源模型在旗艦級效能上首次大規模挑戰閉源模型。
- 2025-03業界開始大規模採用模型路由(Model Routing)技術,以應對模型發布週期縮短帶來的遷移壓力。
- 2026-02多個頂級實驗室在單月內密集發布多款旗艦模型,標誌著『月拋時代』的正式到來。
AI 週報
閱讀本週精選 AI 大事摘要 →
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: 钛媒体 ↗
每週電子報
每週一封,可隨時退訂。