
應用
Meta 智慧眼鏡協助盲人退伍軍人進行日常導航
Meta 的智慧眼鏡正被重新應用,為盲人退伍軍人提供視覺輔助。此應用展示了穿戴式 AI 技術在無障礙領域的正面應用案例。
Digital Trends · 99 天前
能看、能聽、能說的模型正在取代純文字系統。覆蓋視覺語言模型、原生音頻與視頻理解進展。
354 篇文章
Meta 的智慧眼鏡正被重新應用,為盲人退伍軍人提供視覺輔助。此應用展示了穿戴式 AI 技術在無障礙領域的正面應用案例。
Digital Trends · 99 天前

包括 Meta、Google、Samsung、Apple 和 Amazon 在內的主要科技公司正競相將多模態 AI 與攝影機整合至智慧眼鏡中。此趨勢象徵著全天候 AI 互動的轉變,但也面臨大眾對隱私的擔憂。
Computerworld · 99 天前

本文針對 Claude 最新模型 Fable 5 進行實測。報導指出該模型在視覺推理能力上有顯著提升,特別是能準確識別圖像中的手指數量。
Ifanr (爱范儿) · 101 天前

NVIDIA 推出了 Nemotron 3.5 Content Safety,這是一款專為企業級 AI 應用提供可自定義多模態安全防護的新工具。它使企業能夠在文字與視覺輸入中執行特定的安全策略,以確保 AI 部署的可靠性。
Hugging Face Blog · 107 天前

VAMPS 是一個包含 1,168 個問題的多模態基準測試,旨在評估大型語言模型是否能有效利用視覺化工具解決複雜的代數與微積分問題。研究顯示,目前的模型在整合工具生成的圖表時表現不佳,直接進行分析推理的效果往往更好。
ArXiv AI · 107 天前

網易有道旗下的 LobsterAI 整合了一系列先進生成式模型,包括 Seedream、Seedance、HappyHorse 及 MiniMax-Hailuo。此更新大幅擴展了平台在圖片與影片合成方面的能力。
36氪 · 110 天前
Vercel 已將具備 100 萬 token 上下文窗口與原生多模態能力的 MiniMax M3 模型整合至 AI Gateway。開發者現在可以透過統一的 API 使用其強大的代理(agentic)功能與多模態輸入。
Vercel News · 111 天前

快手 2026 年第一季財報顯示,可靈 AI 業務成長強勁,單季營收超過 65 億人民幣。其影片生成技術已擴展至全球 42 個國家與地區,商業化進程顯著加速。
IT之家 · 115 天前
ByteDance 發布了全新的開源多模態模型 Lance,專為在具備 40GB VRAM 的硬體上本地運行而設計。該模型在發布後迅速於 Hugging Face 獲得高度關注。
Pandaily · 117 天前
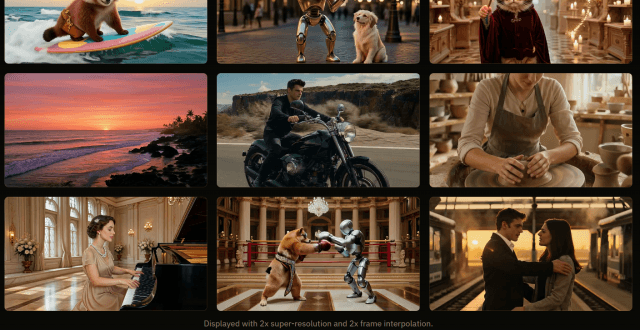
ByteDance 開源了 Lance,這是一款擁有 30 億參數的輕量級多模態 AI 模型。它旨在單一高效架構內處理影像理解、生成和影片任務。
Pandaily · 120 天前

CapCut 宣布與 Google 合作,將其創意編輯工具直接整合至 Gemini 應用程式中。此整合旨在為影像與影片編輯提供更流暢、對話式的創作工作流程。
IT之家 · 121 天前
Qwen-code v0.16.0 針對 CLI 進行了重大改進,包括批次刪除對話與整合 ModelScope。此次更新還提升了子代理(subagent)效能,新增 Qwen3.6-35B-A3B 的多模態支援,並優化了 MCP 的可用性。
Qwen (GitHub Releases: qwen-code) · 121 天前
網易有道宣佈 Ziyue 大模型升級至 4.0 版本,正式邁入全模態時代。官方同步宣佈將核心的多模態模型與 TTS 模型進行開源。
36氪 · 121 天前

智象未來正式發布基於 Unified Transformer (UiT) 架構的 HiDream-O1-Image-Pro,這是一款參數超過 2000 億的原生全模態圖像大模型。該模型通過將圖像、文本與任務條件統一於共享標記空間,在複雜文字渲染與圖像編輯任務中達到了 SOTA 水準。
雷峰网 · 121 天前
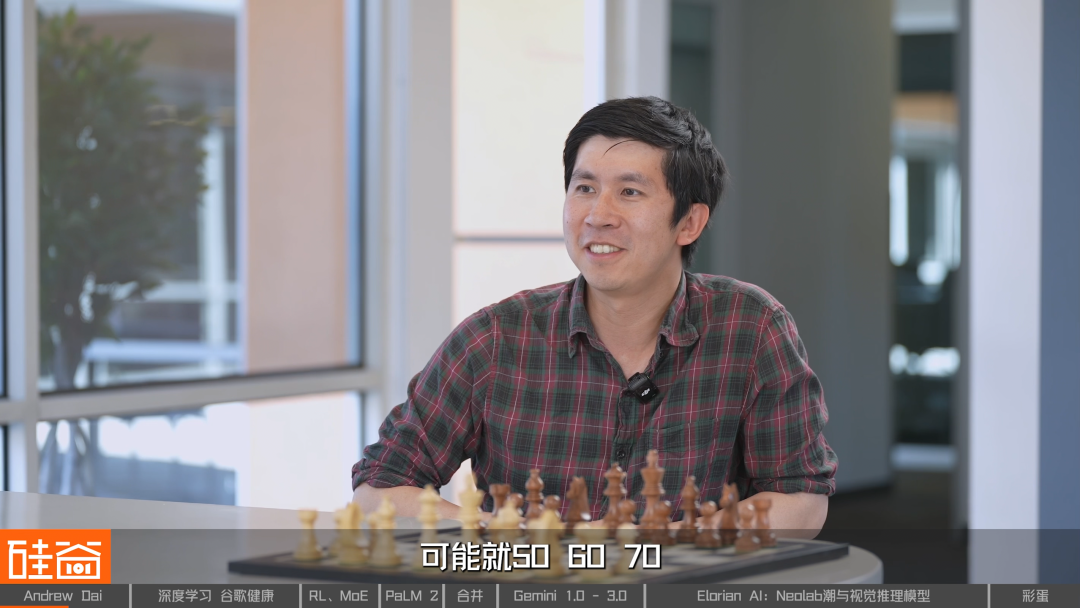
曾參與 Google Gemini 與 PaLM 開發的核心科學家 Andrew Dai 離開 Google 並創立 Elorian AI。該新創公司專注於多模態視覺推理模型,旨在超越純語言模型架構。
虎嗅 · 122 天前
Google 與 Samsung 正與 Warby Parker 和 Gentle Monster 合作,計劃於今年秋季推出 AI 智慧眼鏡。該產品將支援透過語音與 Google 的 Gemini AI 進行互動,並預計於 2027 年推出搭載顯示螢幕的進階型號。
36氪 · 122 天前

Google 的 Gemini 應用程式迎來重大更新,包括電影級影片生成與晨間簡報功能。此外,它還具備一個 24/7 全天候代理,旨在自動處理數位瑣事。
Digital Trends · 122 天前

上海交通大學與 Qwen 團隊推出了 CodePercept,這是一種利用可執行代碼作為「第二語言」來提升 STEM 任務視覺感知的新範式。透過訓練模型生成能重現圖像的代碼,該系統克服了自然語言描述的模糊性。
雷峰网 · 123 天前
TTE-Flash 引入了「潛在思考標記」(latent think tokens)來取代顯式的思維鏈生成,大幅降低了多模態嵌入的計算開銷。該模型在 MMEB-v2 基準測試中表現優異,同時保持了固定的推理成本。
ArXiv AI · 123 天前

阿里巴巴發布了 Qwen 3.7 Max 預覽版,標誌著其模型開發的重要里程碑。該版本在文本和視覺領域均展現了業界領先的性能。
量子位 · 123 天前
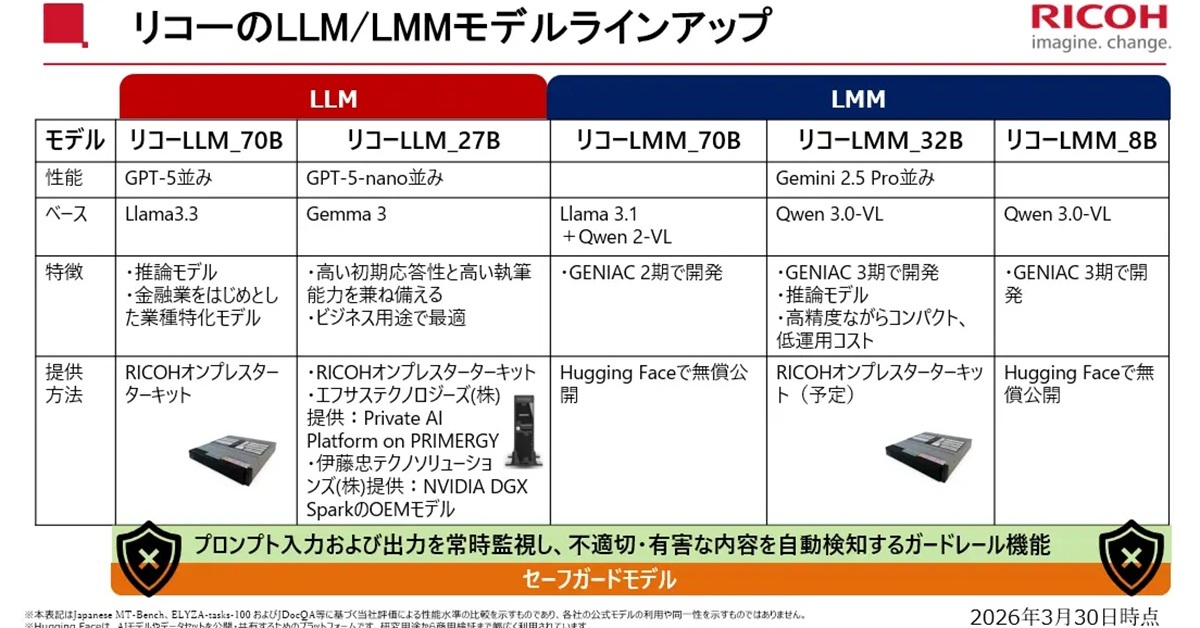
Ricoh 在 GENIAC 專案下開發了一款具備推理能力的多元模態大型語言模型。該輕量化模型現已於 Hugging Face 免費公開。
ITmedia AI+ (日本) · 127 天前

SenseTime 發布了開源模型 SenseNova U1,該模型採用原生統一架構。它將理解與生成整合在單一表徵空間中,終結了傳統的「拼接」模式。
Pandaily · 127 天前
Thinking Machines 由前 OpenAI 領導人 Mira Murati 和 John Schulman 創立,發布「interaction models」的研究預覽,用於近即時多模態語音和視訊對話。這些模型從回合制 AI 轉向全雙工處理,以 200ms 區塊同時處理輸入和輸出。
VentureBeat · 130 天前

前 OpenAI CTO Mira Murati 創辦的 Thinking Machines 宣布開發「互動模型」,實現自然的人機協作。這些模型持續接收音頻、視頻和文字輸入,實時思考、回應和行動。
The Verge · 130 天前
廣州市人工智能產業發展辦公室印發2026年工作要點,加快產業要素強基工程。強化智能算力佈局,規範「城市數據中心+園區算力中心」階梯式發展。
36氪 · 131 天前
研究人員開發心理測驗框架,評估生成式AI認知輪廓與人類標準比較,顯示語言理解和工作記憶表現頂尖,但感知推理幾近失敗。AIQ基準測試追蹤六代兩家族模型,揭示不對稱進展,語言任務遠勝視覺,顯示語言偏誤。
ArXiv AI · 131 天前
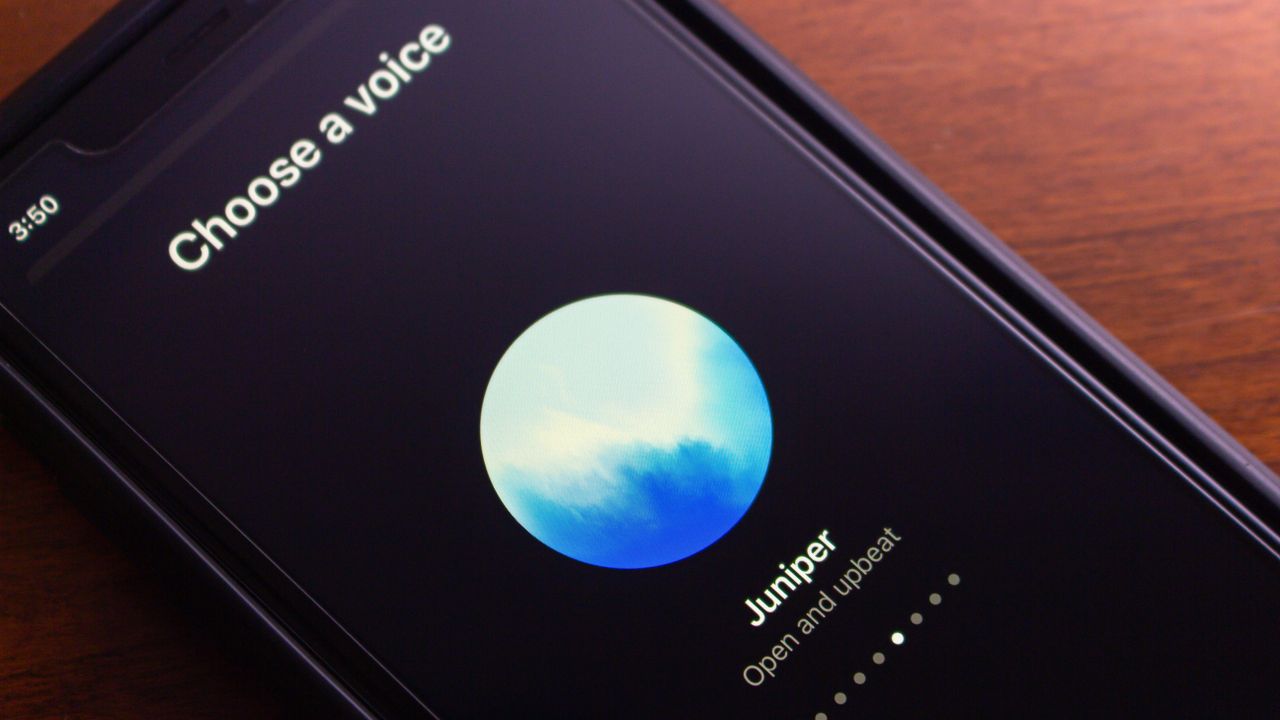
OpenAI 推出三款全新 AI 語音模型,旨在為開發者解鎖全新語音應用類別。這些模型支援深度推理、翻譯和轉錄等進階功能。
TechRadar AI · 134 天前
PRISM 提出一個框架,透過動態問答管道緊密結合 VLM 感知與 LLM 決策。LLM 會批判 VLM 描述、提出目標導向問題,並合成任務導向的場景理解。
ArXiv AI · 134 天前

拉請求 #22493 在 llama.cpp 中新增 Xiaomi 的 Mimo v2.5 稀疏 MoE 模型支援。此模型總參數 310B,啟動 15B 參數,支援 1M 權重上下文,並處理文字、圖像、影片、音訊模態。
Reddit r/LocalLLaMA · 135 天前

字節跳動升級 Doubao-Seed-2.0-lite,為豆包家族首款全模態模型,原生統一理解影片、圖像、音訊與文字。在視覺/音訊基準達 SOTA,超越 Gemini-3.1-Pro,Agent、Coding 與 GUI 能力同步強化。
IT之家 · 136 天前