
研究
MobiFlow:真實世界行動代理基準測試
MobiFlow 是用於任意第三方應用程式任務的行動代理全新評估框架。它採用基於多軌跡融合的圖形建構演算法,有效壓縮狀態空間並支援動態互動。
ArXiv AI · 158 天前
競技場排名、評測爭議,以及基準測試到底測了什麼。看懂每個「SOTA」宣稱背後的細節。
208 篇文章
MobiFlow 是用於任意第三方應用程式任務的行動代理全新評估框架。它採用基於多軌跡融合的圖形建構演算法,有效壓縮狀態空間並支援動態互動。
ArXiv AI · 158 天前
對微調服務進行成本、速度與使用者體驗的基準測試,用於自訂模型。Nebius 在函數呼叫效率上表現出色。
Reddit r/MachineLearning · 172 天前
完整基準測試 AI 代理成本高昂,因需互動執行與工具使用。研究顯示,使用歷史通過率 30-70% 的中難度任務子集,可大幅降低評估任務數 44-70%,同時維持代理排名穩定。
ArXiv AI · 177 天前

Speechos 是一款開源工具,用於並排基準測試本地 STT、TTS、情緒偵測及說話者分離模型。支援 25+ 引擎如 faster-whisper、Piper、Bark 和 Qwen3-TTS,並具備從 CPU 到 GPU 的硬體適應設定。
Reddit r/LocalLLaMA · 203 天前
Pathway 說明如何開發並擴展 Baby Dragon Hatchling (BDH),這是一種在潛在空間中進行推理、而非生成思維鏈 token 的後 Transformer 架構。其 BDH-CQ 變體據稱在 ARC-AGI-1 基準測試上創下新的成本效益紀錄。
AWS Machine Learning Blog · 11 天前
Tom's Hardware 在 RTX 5090 及其他硬體上測試了新推出的 Qwen 3.8 27B。測試顯示,單靠充足的 VRAM,仍無法彌補嚴重的軟體與推論引擎瓶頸。
Tom's Hardware · 11 天前
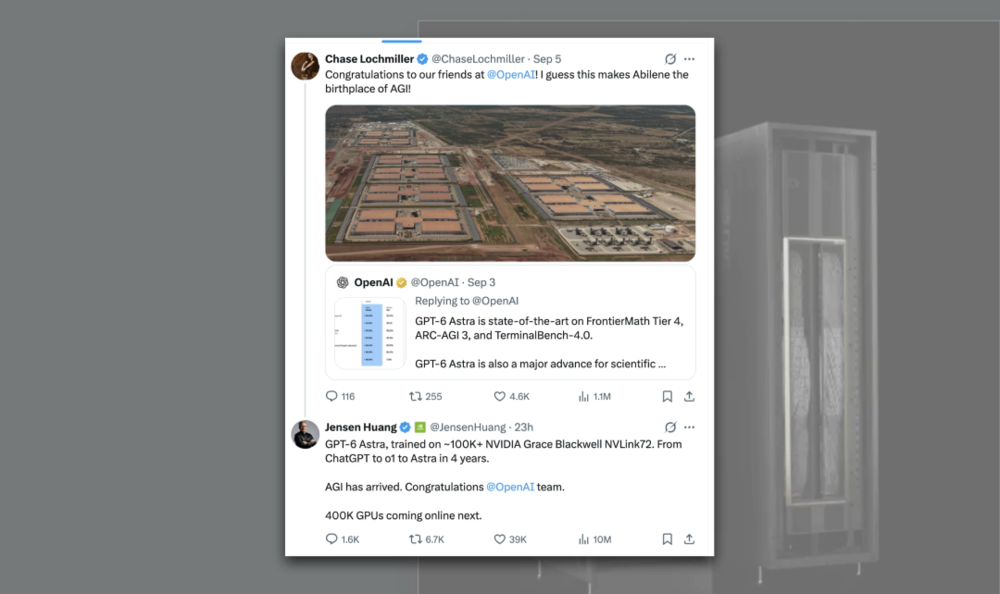
文章檢視 OpenAI GPT-6 Astra 的相關宣稱,包括使用超過 10 萬張 Nvidia GPU 訓練,以及在多項基準測試中的亮眼表現。文章認為,AGI 敘事受到行銷、自建評測環境與基礎設施銷售的強烈影響,而實際生產力提升仍未獲充分證明。
虎嗅 · 11 天前
一項縱向研究分析 49 個模型的 31,352 次重複基準測試觀測值,以測量 API 託管 LLM 的效能漂移。日內分數變異的標準差為 2.80 分,而每日中位數之間為 8.43 分,促使研究者採用版本化設定與重複評估。
Reddit r/MachineLearning · 12 天前

lm-eval-ledger 是一套附帶網頁介面的基準測試工具,讓使用者檢視並比較模型的個別回答,而不只依賴彙總分數。它會將提示詞、生成內容、擷取答案、標準答案、耗時與評估中繼資料儲存在 SQLite 中。
Reddit r/LocalLLaMA · 12 天前
文章指出,Program-Bench、SRE-Bench 與 Code Migration 比傳統程式設計基準更能測試 AI 的深層軟體工程能力。在列出的結果中,GPT-6 Astra 領先,而 Qwen3.8 27B 在二進位重建與程式遷移任務上存在明顯差距。
Reddit r/LocalLLaMA · 13 天前
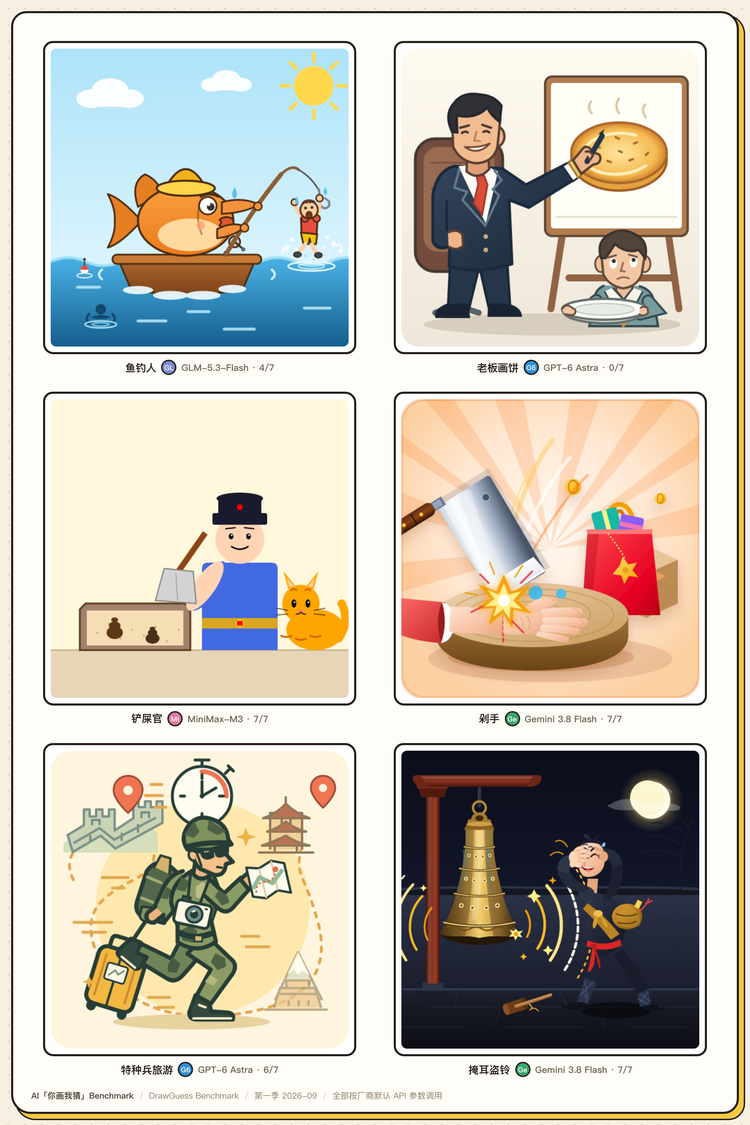
一項新 Benchmark 評估 AI 模型能否透過 SVG 圖像傳達概念,再由其他模型進行辨識。在 1,350 張圖與 11,961 次猜測中,GPT-6 Astra 險勝 Gemini 3.8 Flash 與 Claude Fable 5.1;所有模型面對反常識概念與網路流行語時都明顯失分。
虎嗅 · 14 天前
Booz Allen 讓 18 個先進 AI 模型針對企業實際網路進行測試,結果發現其中一個模型成功完成攻擊。該公司表示,真正重要的不是排名本身,而是理解低成本軟體如何削弱以模型為基礎的威脅評估。
The Next Web (TNW) · 16 天前
Belief-Calibrated Optimization(BCO)透過維護一份描述環境如何回應 scaffold 編輯的持久文件,將代理優化器的假設明確記錄下來。在五項基準測試中,BCO 的訓練與保留集通過率均高於匹配的對照組;即使替換凍結的目標模型,其世界模型仍具實用價值。
ArXiv AI · 16 天前
一項針對六個開源 AI 偵測器的基準測試發現,其中四個無法在人工撰寫文本上可靠維持 0.5% 的誤判率。面對經過 humanizer 改寫的文本時,偵測表現大幅崩潰,且所有測試模型都不成比例地誤標非母語 TOEFL 作文。
Reddit r/MachineLearning · 17 天前

Kaitchup 發布了比較 Qwen3.8 27B 從 Q4 到 Q1 不同量化版本的基準測試結果。可見的摘要結果顯示,UD Q3_K_XL 對擁有 16GB GPU 的使用者特別有效,在 12.8GB 大小下達到據報 100% 準確率。
Reddit r/LocalLLaMA · 18 天前

一篇分析指出,發展逾百年的簡單統計製程管制(SPC),在 TSB-AD 基準測試上可能勝過許多最先進的時間序列異常偵測方法。作者認為該基準包含過於簡單的資料集,可能誇大了這個領域的進展。
Reddit r/MachineLearning · 21 天前
DeepMind 正在試行其所稱全球首創的雙盲 AI 評估。這項計畫旨在提升 AI 系統比較的客觀性與可靠性。
DeepMind Blog · 23 天前
ImageBench 是一套文字生成圖像基準測試,涵蓋文字渲染、空間推理、人物真實感與否定語句等 192 個具挑戰性的提示詞。目前已評估 52 個模型、超過 9,000 張生成圖像,並公開提示詞、結果與圖像以提升可重現性。
Reddit r/MachineLearning · 24 天前
一個從零實作的 HNSW 與 BM25 檢索引擎,在 NFCorpus 和 SciFact 上與 FAISS 進行基準測試。在約 3,600 至 5,200 份文件的規模下,精確暴力搜尋達到與 HNSW 相同的品質,同時延遲更低、索引建置速度也快得多。
Reddit r/MachineLearning · 24 天前
LangChain 推出 WikiBench,用於評估生成式 Wiki 是否能提升程式設計代理的表現。結果顯示,將 Wiki 與原始碼搭配使用,比單獨使用原始碼效果更好,成本也更低。
LangChain Blog · 24 天前

DelveRL 是一款專為訓練遊戲智能體打造的開源無盡回合制 Roguelike。它提供結構化 API、確定性模擬、程序化關卡、部分可觀測性與本機執行環境,內附的 recurrent PPO 基線模型可達到第 18 層的中位數成績。
Reddit r/MachineLearning · 28 天前
Ora 讓 Claude Code、ChatGPT、Gemini、Hermes、OpenClaw 與 Vercel 的 eve Agent framework 執行真實網站工作流程,以衡量它們完成任務的能力。初步比較顯示,eve 所需步驟少 7%、原生完成率達兩倍,並多找到 9% 可實際呼叫的有效端點。
Vercel News · 29 天前

一名獨立開發者以約 250 美元,使用 50 億個去污染化 token 預訓練出 10.2 億參數的 Kimi-K3 複製模型。該模型在 HellaSwag 上達到 33.4%,高於 GPT-2 124M 據報的 28%,且完全未經指令微調。
Reddit r/LocalLLaMA · 30 天前
本文提出 Transition Complexity Profile(TCP),一套可重現的框架,用於衡量特定介面下遊戲世界轉移預測的難度。TCP 評估分支程度、互動導致的不確定性、對手影響,以及時間或空間依賴性,藉此改善遊戲建模與強化學習基準之間的比較。
ArXiv AI · 30 天前
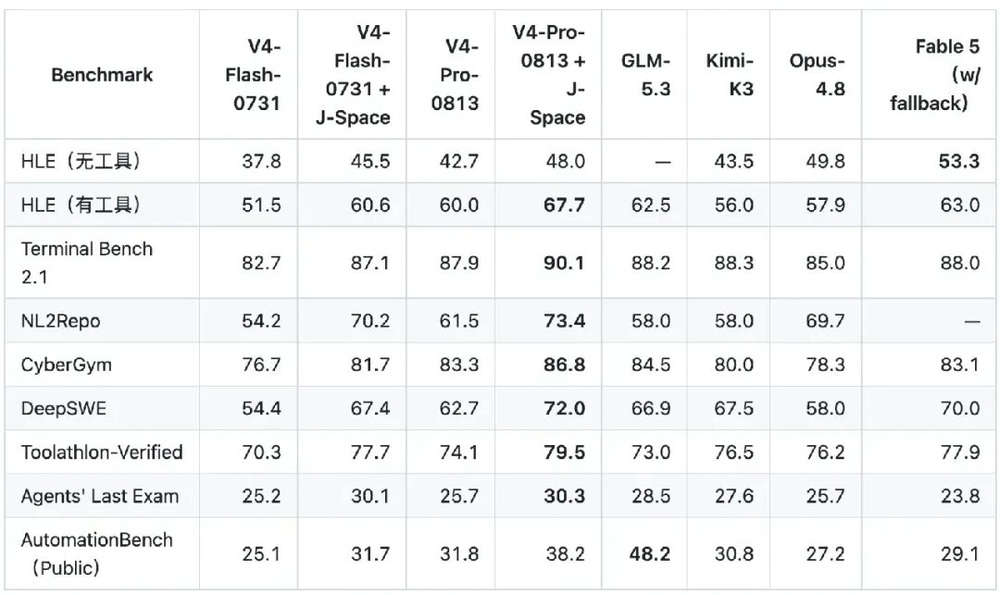
社群專案 J-Space Cognition Suite 宣稱,在不修改模型權重的情況下,透過推理時 Agent Harness 提升 DeepSeek V4-Pro-0813 的表現。其在多項基準測試中的提升尚未獲得獨立團隊重現,且該專案與 Anthropic 的內部 J-space 可解釋性研究無關。
虎嗅 · 31 天前

Unitree 發表名為 Superman 的新型人形機器人,宣稱其最高速度可達每秒 12.66 公尺,並能從站立姿勢跳躍 2 公尺。該公司尚未公布涵蓋負載、地面條件或可重複性的詳細測試規範。
TechNode · 32 天前
RubricForge 從少量具備真實結果標註的代理軌跡中,自動生成可讀的人類評分規範,之後可在不存取環境的情況下套用固定規範。在 tau-bench 與 WebShop 上,它大幅降低失敗軌跡被誤判為通過的比例,並改善分級結果排序;但整體一致性並未顯著優於 G-Eval。
ArXiv AI · 33 天前
Qwen Code 宣布使用 Benchmark-Qwen-Ref v0.21.12 執行完整端到端基準測試。評估將先涵蓋 500 個 SWE-bench Verified 案例,待 SWE 結果成功發布後,再執行 89 個 Terminal-Bench 2.0 案例。
Qwen (GitHub Releases: qwen-code) · 35 天前
一項新研究發現,LLM 往往能與人類的道德判斷標籤一致,卻依賴不同的倫理原則與情境假設。研究團隊使用包含 500 個題目的 ETHICS 衍生基準,主張評估真正的對齊程度必須分析模型的推理依據。
ArXiv AI · 36 天前
NL2SHACL-Bench 提供專門基準,用於評估 LLM 將自然語言需求轉換為 SHACL shapes 的能力。對四個最先進 LLM 的測試顯示,它們擅長產生語法有效的 SHACL,但在複雜約束的語義等價性方面仍有明顯困難。
ArXiv AI · 39 天前