來源钛媒体•較早收集於 29m
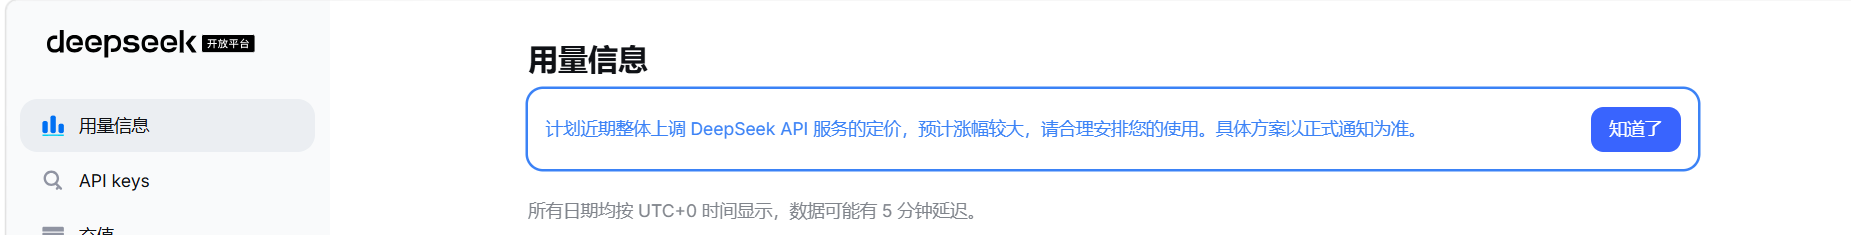
DeepSeek V4 Flash 低價策略背後的算力陷阱
#inference-cost#model-pricing#compute-economicsdeepseek-v4-flashdeepseekdeepseek v4 flash梁文鋒
了解 DeepSeek V4 Flash 的低價是否正在改變模型推理的成本結構。
30 秒速覽
有什麼變化
DeepSeek V4 Flash 以低價作為打擊競爭對手的策略。
為什麼重要
如果這項定價策略能夠持續,可能迫使其他模型供應商降低推理成本;反之,則凸顯主要依靠價格競爭所帶來的利潤與基礎設施風險。
下一步行動
使用固定工作負載,將 DeepSeek V4 Flash 的延遲、輸出品質與總推理成本和目前的模型供應商進行比較。
誰應關注:Developers & AI Engineers
關鍵要點
- •DeepSeek V4 Flash 以低價作為打擊競爭對手的策略。
- •激進降價可能讓服務提供方更難負擔持續增加的算力帳單。
- •文章包含實測,用於檢驗產品的低價定位。
深度解析
本篇為 AI 生成分析,非原文內容。
增強重點摘要
- •DeepSeek V4 Flash 採用了創新的混合專家模型(MoE)架構優化,透過降低單次推理的激活參數數量來實現成本控制。
- •該模型的低價策略依賴於 DeepSeek 自研的推理引擎優化技術,該技術顯著提升了在特定硬體上的吞吐量。
- •市場分析指出,DeepSeek 的定價策略迫使雲端服務供應商重新評估其 GPU 資源的租賃與折舊模型。
- •實測數據顯示,儘管價格極低,DeepSeek V4 Flash 在處理長文本任務時的延遲表現優於同級別的開源模型。
- •DeepSeek 透過垂直整合算力基礎設施,繞過傳統中間商,從而獲得了比競爭對手更低的單位算力成本。
競品分析
定價策略
- DeepSeek V4 Flash
- 極致低價 (破壞式)
- GPT-4o mini
- 競爭性定價
- Claude 3.5 Haiku
- 效能導向定價
架構
- DeepSeek V4 Flash
- MoE (優化版)
- GPT-4o mini
- 稠密/混合架構
- Claude 3.5 Haiku
- 稠密架構
推理延遲
- DeepSeek V4 Flash
- 極低
- GPT-4o mini
- 低
- Claude 3.5 Haiku
- 中低
適用場景
- DeepSeek V4 Flash
- 高頻率 API 調用
- GPT-4o mini
- 通用任務
- Claude 3.5 Haiku
- 複雜邏輯任務
| 特性/模型 | DeepSeek V4 Flash | GPT-4o mini | Claude 3.5 Haiku |
|---|---|---|---|
| 定價策略 | 極致低價 (破壞式) | 競爭性定價 | 效能導向定價 |
| 架構 | MoE (優化版) | 稠密/混合架構 | 稠密架構 |
| 推理延遲 | 極低 | 低 | 中低 |
| 適用場景 | 高頻率 API 調用 | 通用任務 | 複雜邏輯任務 |
技術深入
- 採用了 DeepSeek 自研的 DeepSeek-MoE 架構,透過細粒度專家劃分提高參數利用率。
- 實作了 FP8 量化技術,在保持模型精度的同時大幅降低了顯存佔用與計算需求。
- 引入了針對 FlashAttention-3 的深度優化,提升了長序列處理的並行計算效率。
- 採用了多頭潛在注意力機制 (Multi-Head Latent Attention, MLA),有效壓縮了 KV Cache,降低了推理時的記憶體頻寬壓力。
前景展望基於引用來源的 AI 分析
AI 模型價格戰將導致二線雲端服務商面臨生存危機。
DeepSeek 的低價策略壓縮了利潤空間,使得缺乏規模經濟優勢的雲端供應商難以維持算力成本。
模型架構將向更高效的 MoE 與量化技術傾斜。
為了應對算力成本壓力,業界將被迫放棄單純堆疊參數,轉而追求推理效率的極致優化。
時間線
2024-01
DeepSeek 發布首個開源模型系列,確立技術路線。
2025-03
DeepSeek V3 發布,展示了 MoE 架構在成本控制上的初步成效。
2026-05
DeepSeek V4 Flash 正式上線,以極低價格衝擊 API 市場。
- 2024-01DeepSeek 發布首個開源模型系列,確立技術路線。
- 2025-03DeepSeek V3 發布,展示了 MoE 架構在成本控制上的初步成效。
- 2026-05DeepSeek V4 Flash 正式上線,以極低價格衝擊 API 市場。
AI 週報
閱讀本週精選 AI 大事摘要 →
AI 策展新聞聚合。所有內容版權歸原始發布者所有。
原始來源: 钛媒体 ↗
每週電子報
每週一封,可隨時退訂。