SetupAI影片
影片
Tikkocampus:TikTok 轉 ML 資料集
Tikkocampus 將 TikTok 創作者時間軸轉換為帶時間戳、可搜尋的影片片段,用於 ML 實驗與 RAG 專案。它能輕鬆從 TikTok 影片建立資料集,並支援分析任務。
Reddit r/MachineLearning · 176 天前
RAG 是企業把大模型用到自有數據上的主流路徑。這裡追蹤相關技術、工具與落地經驗。
142 篇文章
Tikkocampus 將 TikTok 創作者時間軸轉換為帶時間戳、可搜尋的影片片段,用於 ML 實驗與 RAG 專案。它能輕鬆從 TikTok 影片建立資料集,並支援分析任務。
Reddit r/MachineLearning · 176 天前
開發者為房地產資料建置生產級 GraphRAG,困於 LightRAG、ApeRAG、Cognee 與 Graphiti 的時間感知與去重問題。Graphiti 提供時間驗證但大規模代幣成本過高。
Reddit r/LocalLLaMA · 176 天前
MiroThinker H1透過驗證中心推理,效能提升17%、互動輪次減43%。Local Verifier於難題提升Pass@1達26分,步驟減至1/6。
Reddit r/MachineLearning · 184 天前

GSI Agent 是一個框架,利用監督微調、來自市政文件的檢索增強生成,以及基於代理的推理管道,提升大型語言模型在綠色雨水基礎設施任務的表現。它引入了適用於真實檢查情境的新 GSI 資料集。
ArXiv AI · 185 天前
Weaviate 在僅 36 小時內建置生產就緒的端到端法律 RAG 應用程式。此專案利用 Query Agent 和新發布的 Weaviate Agent Skills 函式庫。
Weaviate Blog · 205 天前

Google 宣布 Developer Knowledge API 及 MCP Server 的公開預覽。此 API 讓生成 AI 擷取並參考 Google Cloud、Android、Firebase 等官方文件。
ITmedia AI+ (日本) · 214 天前
美國勞工統計局預測,2025 至 2035 年總就業將增加約 590 萬個職位,許多高 AI 暴露職業仍會成長。AI 更可能先拆解傳統職位中的任務,重新分配人類與機器的工作邊界。
虎嗅 · 10 天前
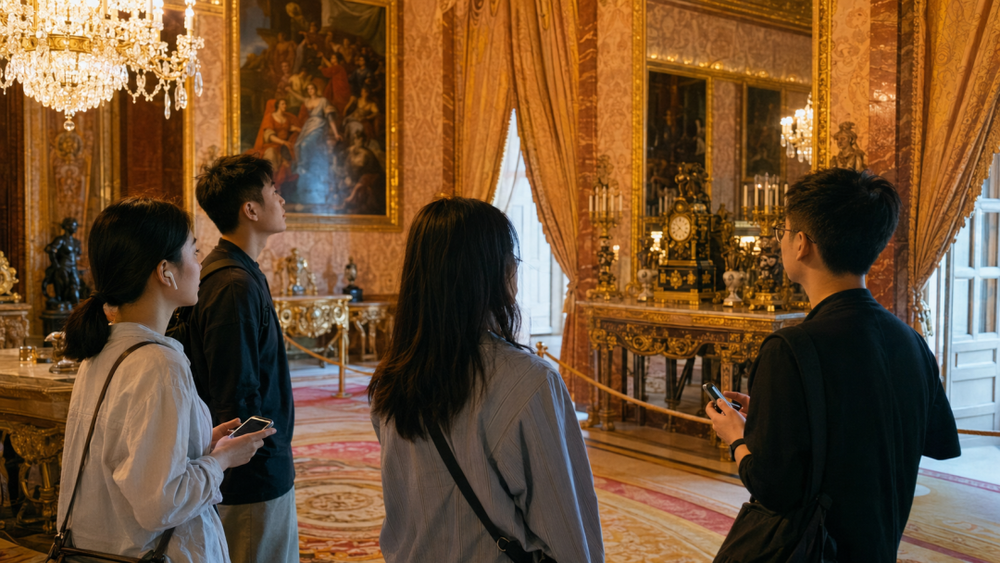
旅客越來越使用 ChatGPT、Gemini、豆包與 DeepSeek 來辨識並解說地標與博物館展品,導致基礎付費導覽需求下降。博物館則開始以策展與考古資料訓練垂直 AI 導覽員;真人導遊仍在行程安排、安全與察覺旅客未明說的需求方面具備優勢。
虎嗅 · 38 天前

Synthetic Query Probing 不直接比較 embedding 向量,而是測量 synthetic questions 與內容區塊之間的相似度分數,以比較不同 embedding models。研究顯示,Titan 與 Ada 等模型的分數範圍可能不同且呈非線性關係,會影響檢索門檻設定與模型遷移。
Reddit r/MachineLearning · 40 天前
本文調查一則由 AI 生成的故事,該故事聲稱索馬利蘭存在數十種私人發行貨幣且物價穩定,後來發現其混淆了索馬利亞、索馬利蘭與自媒體虛構敘事。文章警告,即使 AI 回答流暢且理論上具說服力,仍需獨立查證;而以 AI 生成內容訓練 AI 可能放大錯誤。
虎嗅 · 40 天前
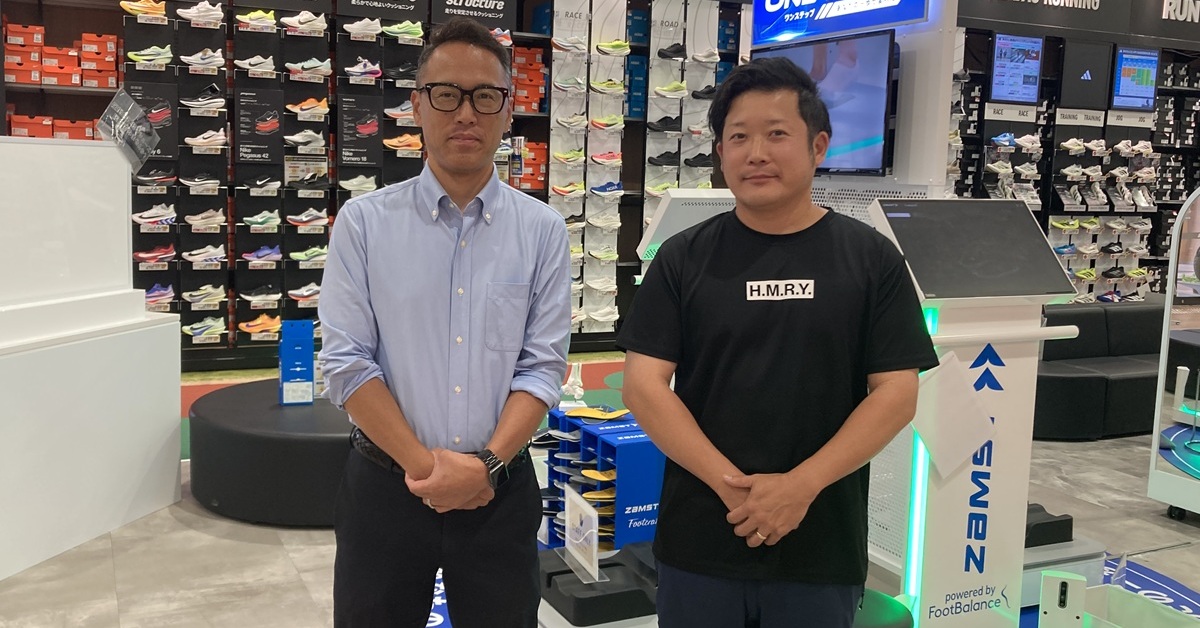
體育用品零售商 Himalaya 已在全日本 99 家門市部署名為「アイダ つなぐ」(Aida Tsunagu) 的「AI 副店長」。該 AI 學習了公司理念與特定的客戶服務知識,以協助門市營運。
ITmedia AI+ (日本) · 71 天前
東寶與 Accenture 合作,導入 AI 系統來監修 IP 周邊商品。該系統透過學習《排球少年!
ITmedia AI+ (日本) · 81 天前
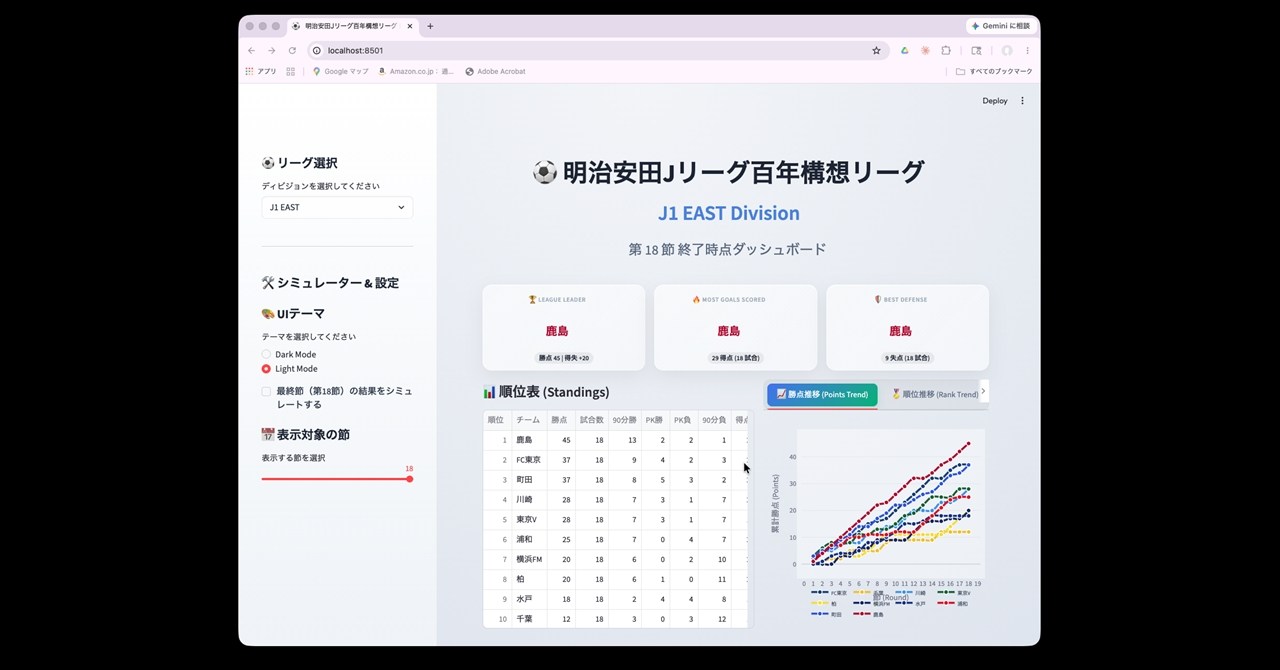
本文探討了生成式 AI 時代下教科書式內容的意義,並分享了利用 LLM Wiki 概念建立企業內部知識庫的實踐方法。內容涵蓋了開發者學習編碼方式的轉變以及組織知識管理的挑戰。
ITmedia AI+ (日本) · 114 天前

作者詳述三層AI脈絡:1) RAG個人資料事實;2) LLM Wiki結構化知識;3) 「哈勃半徑」將所有饋源/RSS索引至私有Meilisearch涵蓋潛在知識。讓AI存取用戶資訊宇宙無需公搜。
虎嗅 · 136 天前
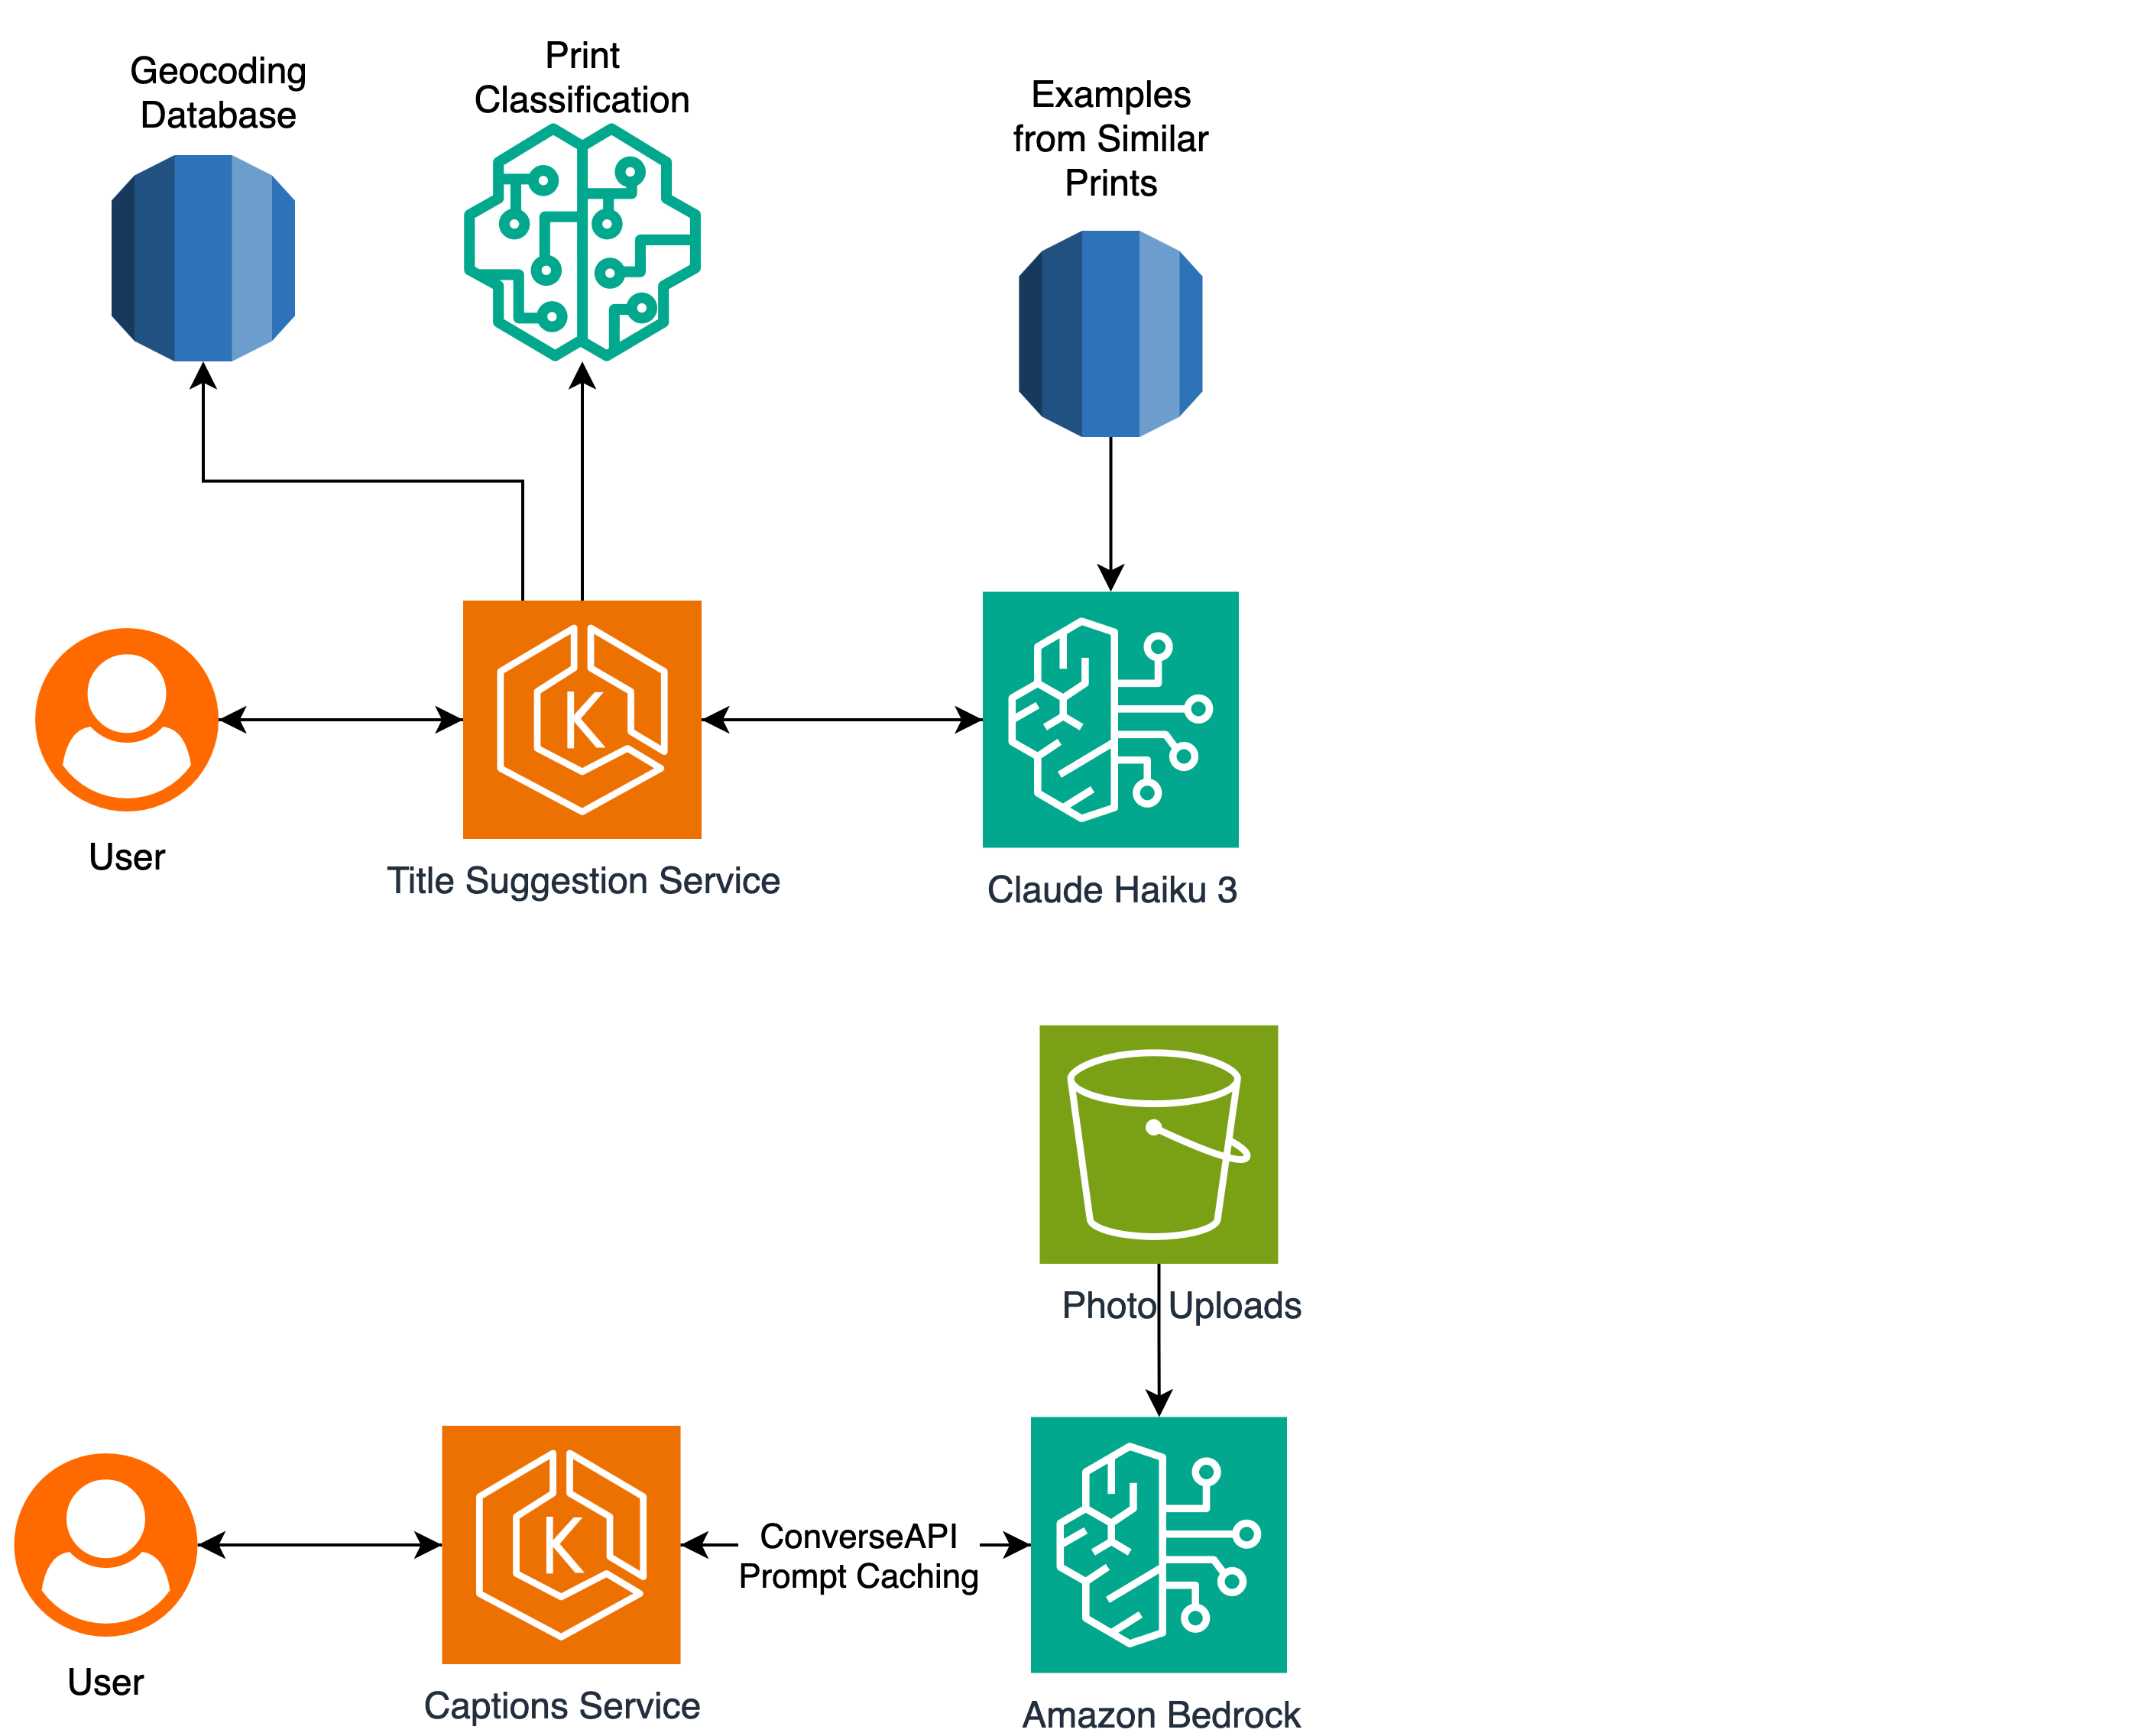
Popsa 使用 Amazon Bedrock 和 Nova 模型重新設計標題建議功能。結合中繼資料、電腦視覺與 RAG,自動產生符合品牌的創意多語言標題與副標題。
AWS Machine Learning Blog · 145 天前
使用者讚揚 Qwen 27B 分析密集 80K 令牌故事聖經,保留細節勝過 Gemma 3 27B 或 Reka Flash。27B 尺寸優於 9B(幻覺嚴重)及 35B。
Reddit r/LocalLLaMA · 188 天前
Google NotebookLM 將所有上傳文件傳至 Google 伺服器,不適合專有研究、臨床資料或受規範工作負載。使用者讚賞其文件基礎問答與引用功能,但尋求具合規保證的私密替代方案。
Reddit r/MachineLearning · 203 天前
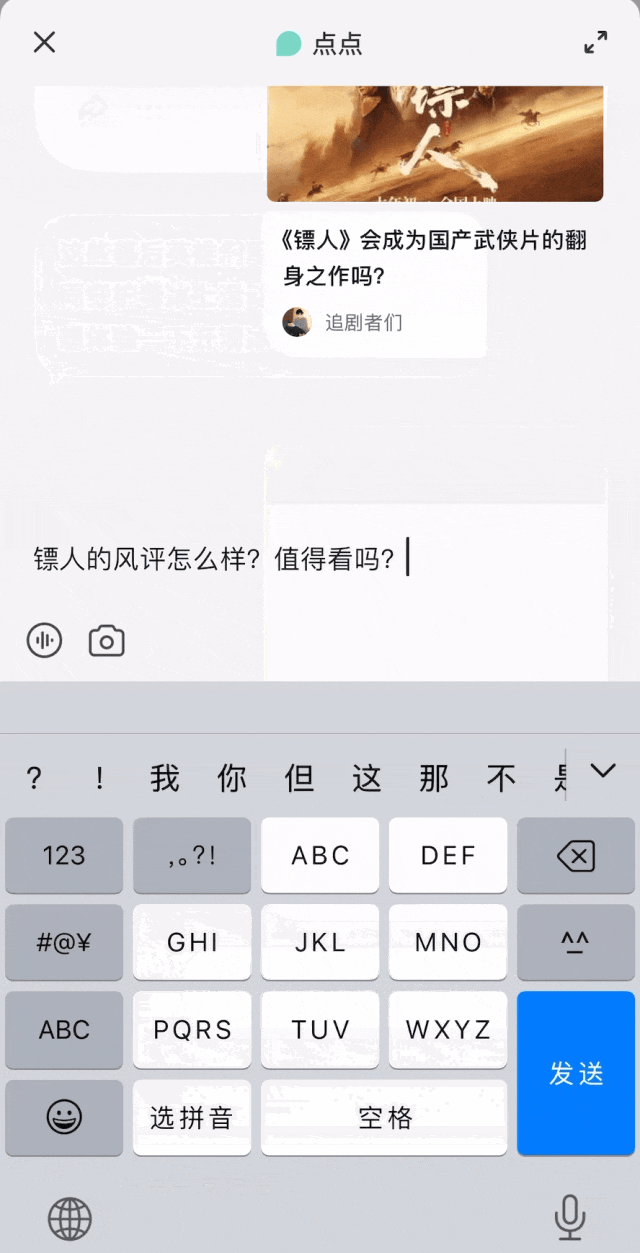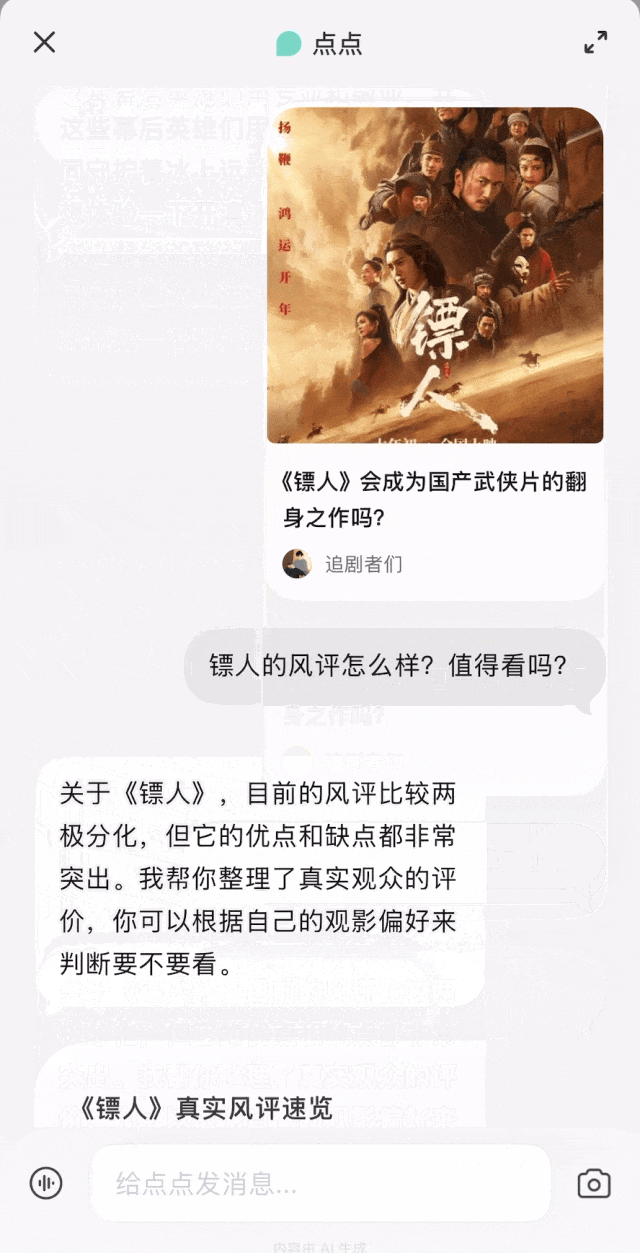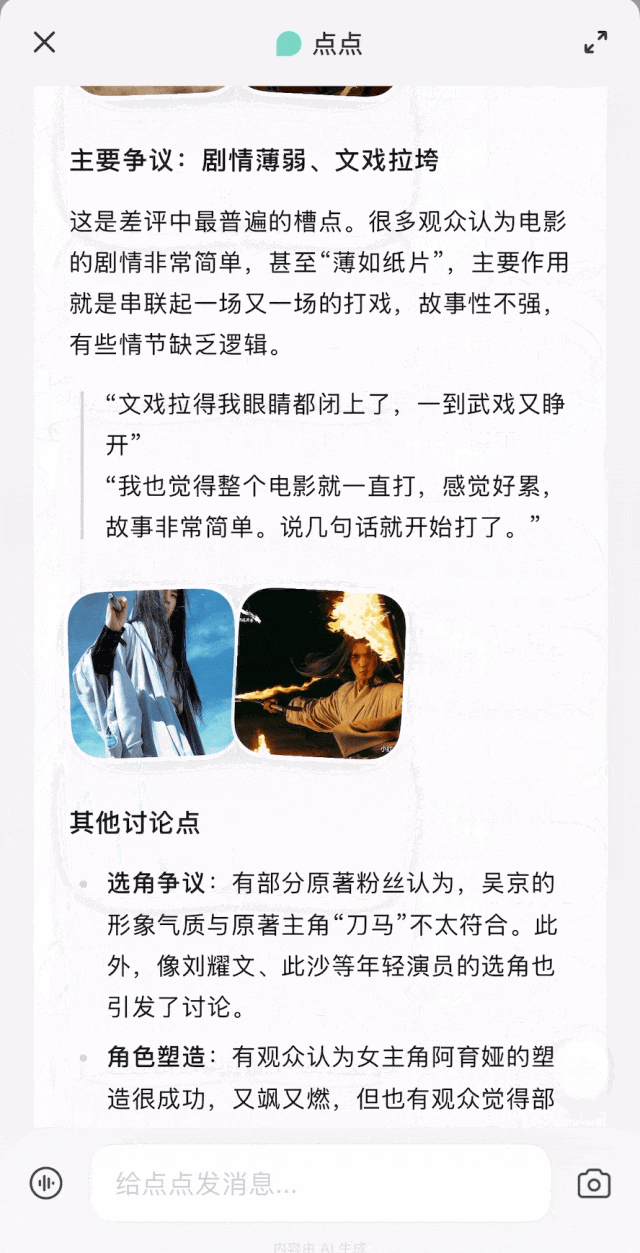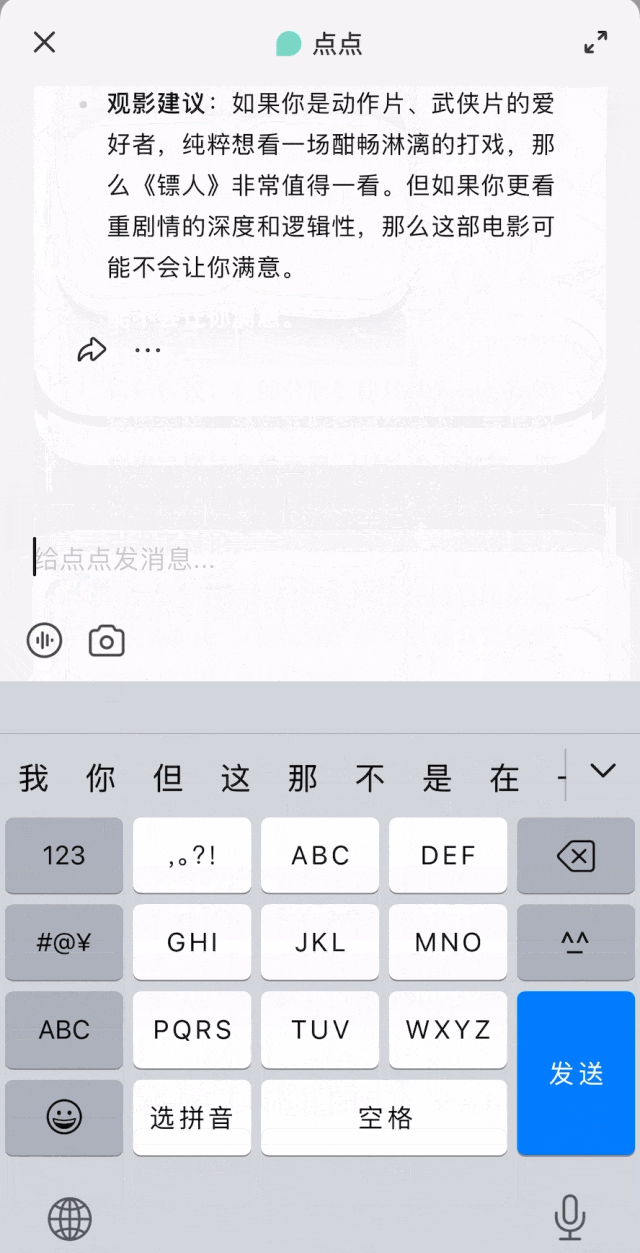
小紅書点点AI分析筆記、評論、影片提取洞見,歸納避雷,並推出「攻略模式」生成親子旅行等可執行計劃。利用社群真實經驗勝通用數據。
虎嗅 · 207 天前

AI工具正擾動高考志願填報諮詢市場,但許多服務質量低劣,僅使用過時數據或簡單的搜索封裝。該行業缺乏標準化,導致消費者質疑。
虎嗅 · 75 天前
一個探討本地 LLM 實用且節省時間的工作流程的社群討論串,包括 RAG、MCP 和編碼代理。討論重點在於實際應用而非僅僅是模型基準測試。
Reddit r/LocalLLaMA · 85 天前
律師建 10x Nvidia V100 SXM (320GB VRAM) Threadripper 伺服器,用於私人 RAG/QLORA 法律任務。分享 Linux 無頭 vLLM 初始基準,尋求寫作模擬及法律推理模型建議。
Reddit r/LocalLLaMA · 166 天前
Reddit 用戶讚揚 GPT-4.1 為可靠預設模型,擅長指令遵循和長上下文處理。他們希望 OpenAI 如先前 GPT-OSS 模型般開源它,特別因其優異 RAG 效能。
Reddit r/LocalLLaMA · 200 天前