圖像
攝影正成為智慧硬體的新生意
隨著相機硬體成本下降,創新的焦點正轉向機器人和無人機等「自主攝影」硬體。這些設備旨在自動化構圖、追蹤和內容創作的全過程。
虎嗅 · 65 天前
檢測、分割、OCR 與視覺理解——支撐機器人、自動駕駛與內容工具的感知層。
403 篇文章
隨著相機硬體成本下降,創新的焦點正轉向機器人和無人機等「自主攝影」硬體。這些設備旨在自動化構圖、追蹤和內容創作的全過程。
虎嗅 · 65 天前

商湯科技發布 SenseNova-Vision,這是一款將目標檢測、分割、3D 重建等任務整合的統一視覺基礎模型。該模型已全面開源,並同步釋出 5000 萬條視覺指令語料庫。
IT之家 · 67 天前
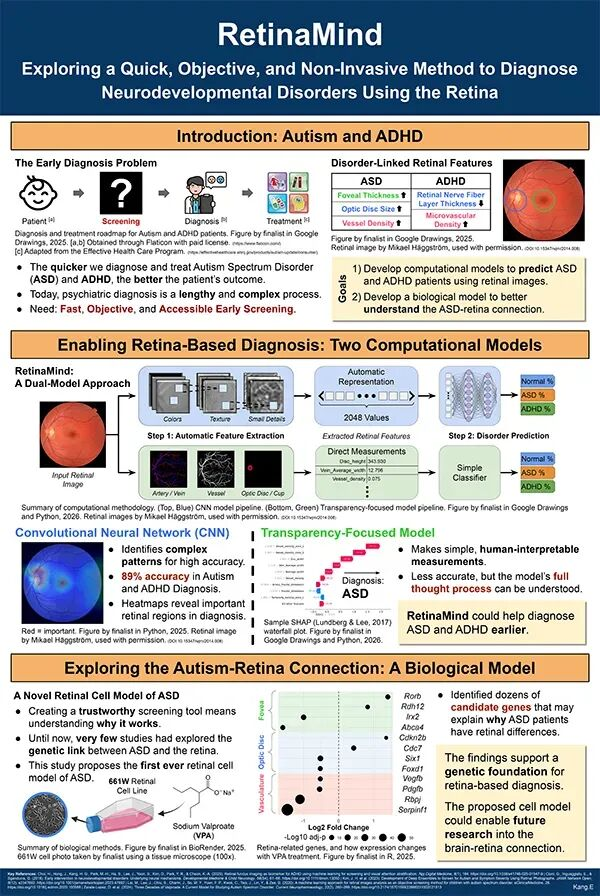
一名17歲學生開發了名為「RetinaMind」的AI工具,利用卷積神經網路分析視網膜影像以篩查自閉症與ADHD。該項目在測試中達到89%的準確率,展示了AI在神經發育診斷中的潛力。
虎嗅 · 71 天前
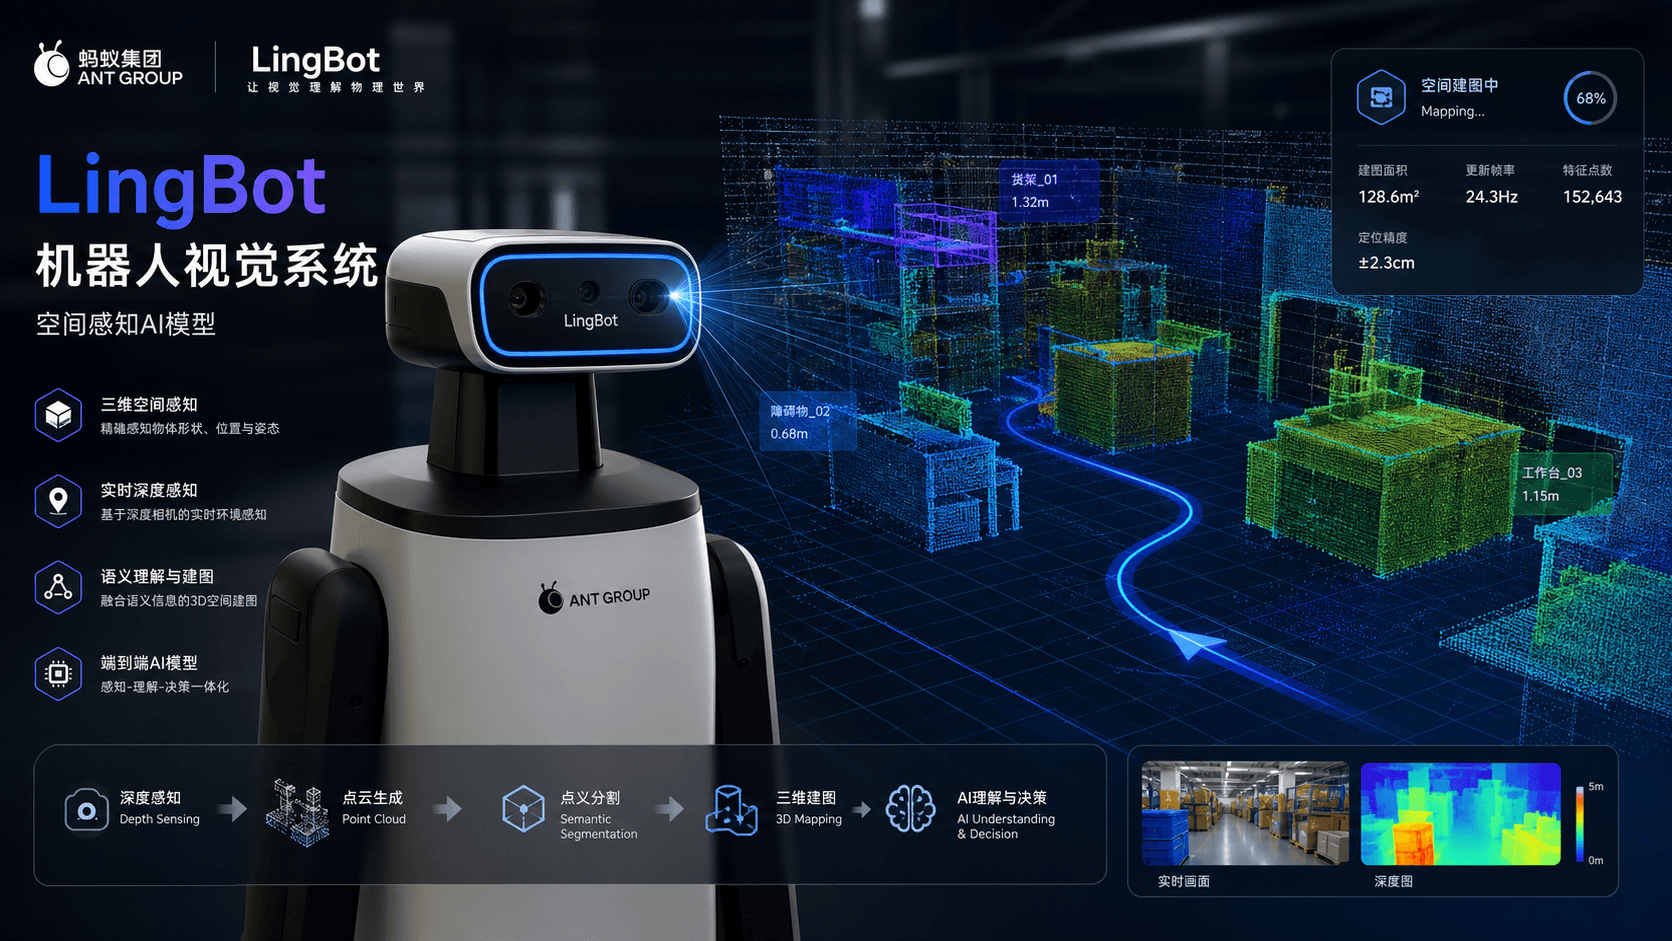
Ant Group 擁有 11 億參數的 LingBot-Vision 基礎模型,在效能上超越了 Meta 的 70 億參數 DINOv3。該模型屬於 LingBot-Depth 2.0 空間感知套件的一部分,並創下了 12 項世界第一的基準測試紀錄。
Pandaily · 73 天前
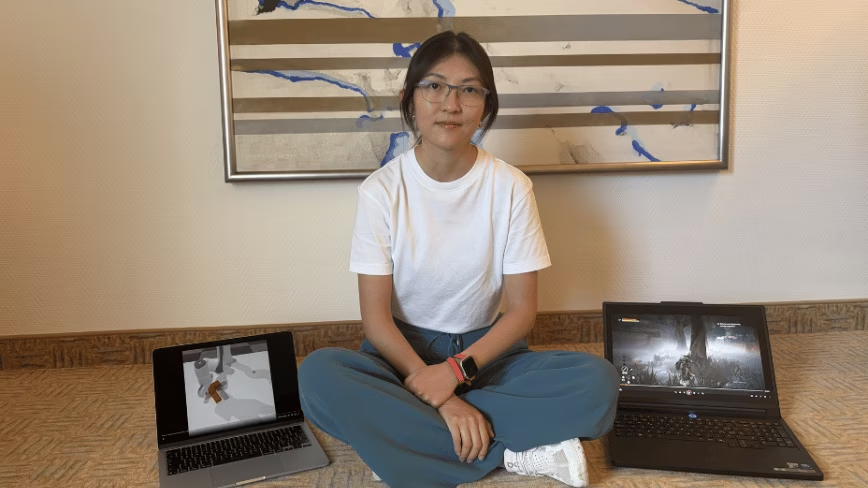
位於劍橋的新創公司 Worldmodeldata 籌集了 700 萬英鎊,用於開發將電玩遊戲畫面轉化為高品質 AI 訓練資料的技術。該公司旨在協助 AI 模型更好地理解物理世界的互動。
The Next Web (TNW) · 73 天前

Tesla 為其 Cybercab 原型車的側視鏡頭整合了噴淋清洗系統,以確保自動駕駛時的視覺清晰度。此硬體解決方案解決了鏡頭因污垢或天氣因素受阻的關鍵痛點。
IT之家 · 89 天前
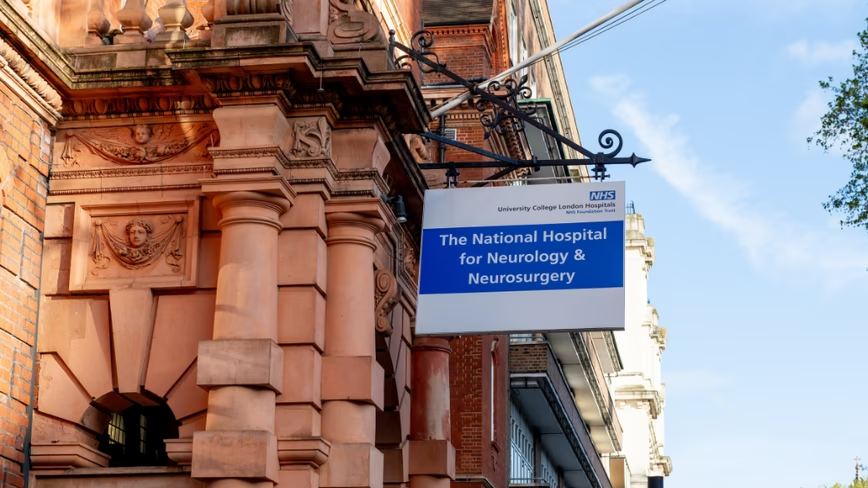
倫敦 National Hospital for Neurology and Neurosurgery 的外科醫師成功切除腦瘤,University College London Hospitals 稱這是全球首例同類型成功的 AI 輔助手術。系統分析手術中的即時攝影畫面,協助辨識腫瘤附近的神經與血管。
The Next Web (TNW) · 21 天前
法醫團隊表示,一架搭載 Nvidia Jetson Orin 模組的俄羅斯 Molniya 無人機在 Zaporizhzhia 一處加油站造成三名平民死亡。這起事件被描述為首宗有紀錄顯示俄羅斯無人機使用完全自主瞄準並導致平民死亡的案例。
Tom's Hardware · 23 天前
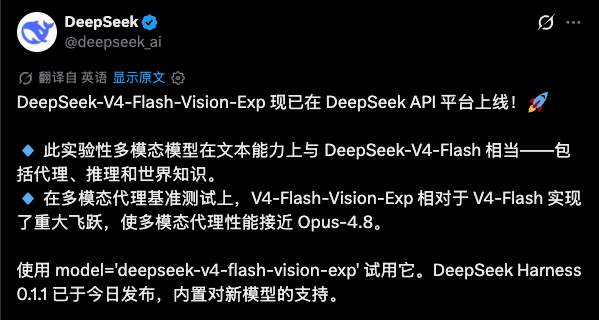
DeepSeek 發布了最新模型 DeepSeek-V4-Flash-Vision-Exp,核心聚焦於視覺能力。這項發布代表該公司在長時間醞釀後,終於推出多模態模型更新。
cnBeta (Full RSS) · 27 天前
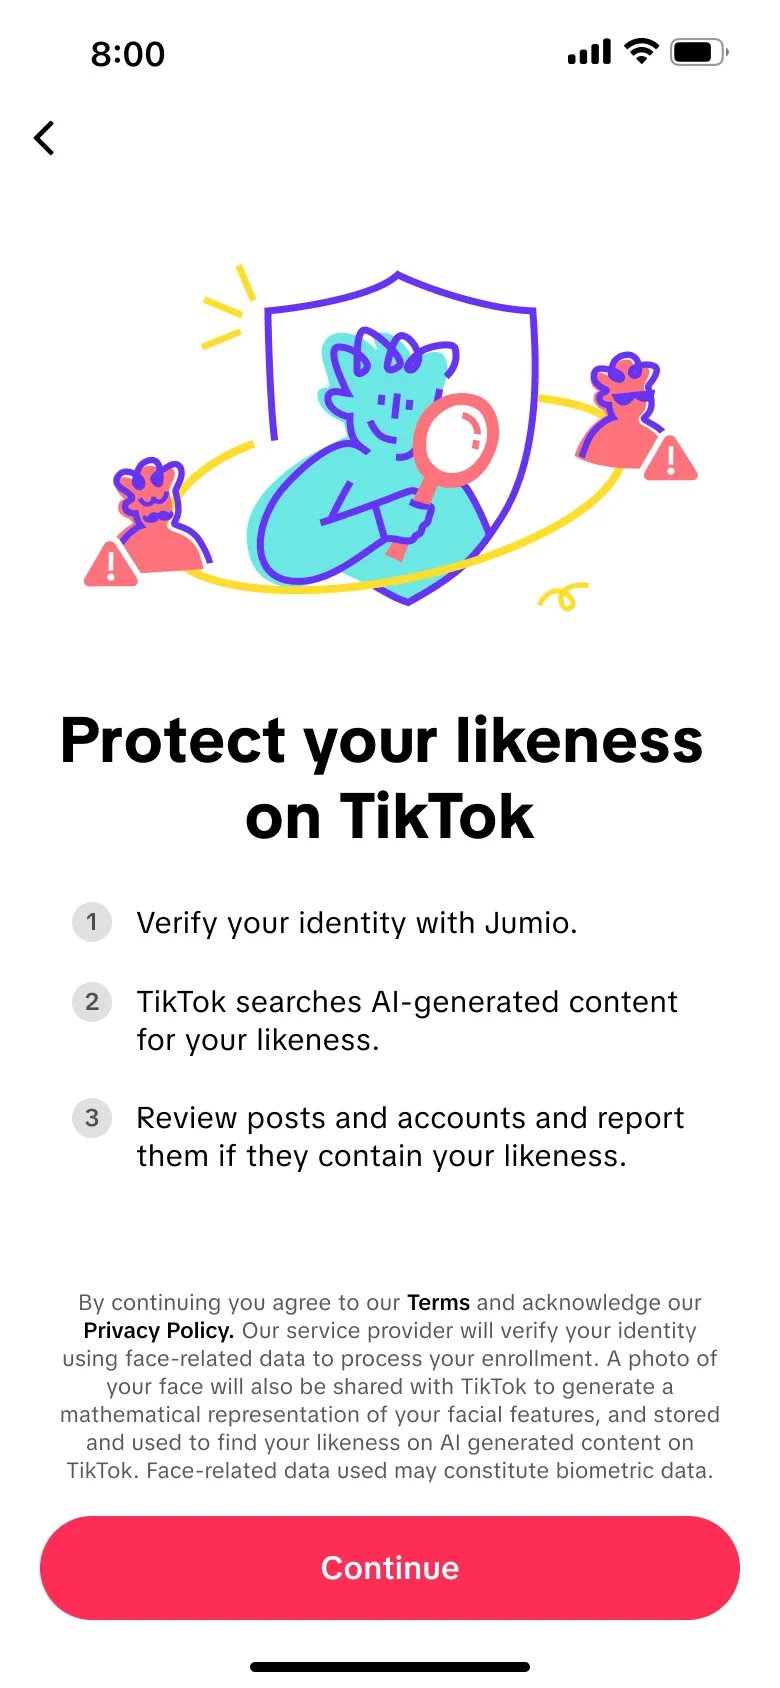
TikTok 正在測試一項新工具,讓創作者能識別其肖像是否被 AI 未經授權使用。該功能目前正針對美國創作者進行小範圍測試,旨在協助他們舉報深度偽造內容。
cnBeta (Full RSS) · 62 天前
University of York 的研究人員發現,儘管人工神經網絡(ANN)在預測物體識別方面表現出色,但其內部處理機制與靈長類動物大腦存在顯著差異。這表明目前的 AI 模型可能透過非生物學模擬的方式達成結果。
cnBeta (Full RSS) · 62 天前

DialogueVPR 引入了一種用於地理定位的對話式推理範式,超越了靜態檢索。它包含 DlgQuest-Cities 基準測試和 DQ-pilot 框架,透過互動式提問來處理模糊的自然語言查詢。
ArXiv AI · 63 天前
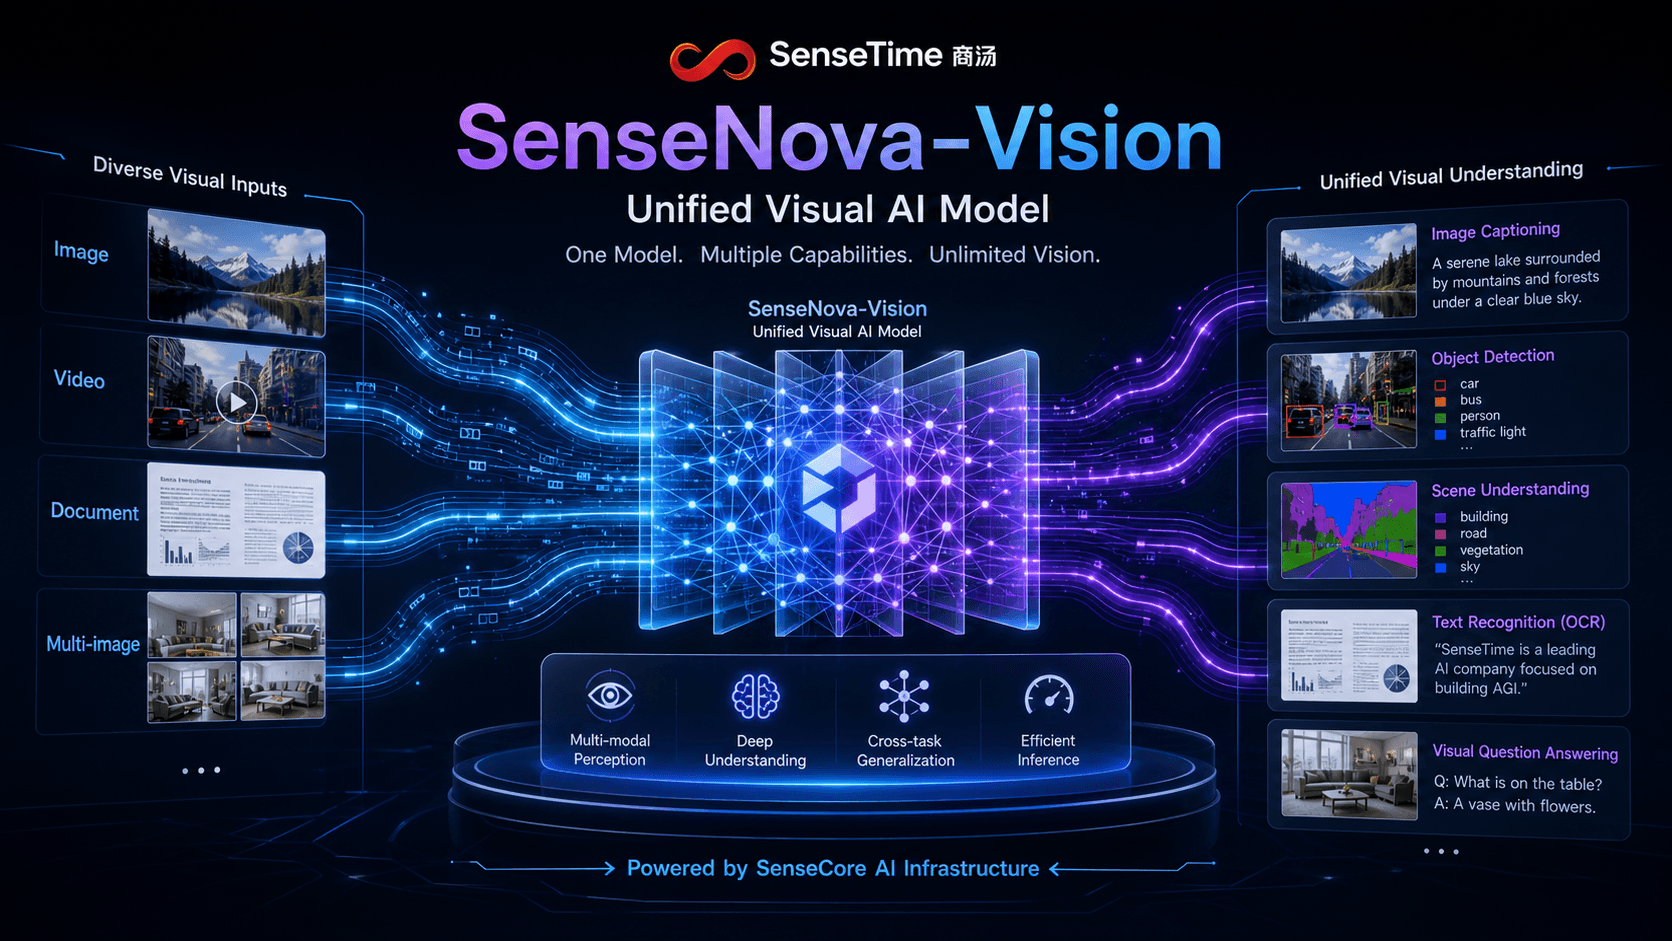
SenseTime 開源了 SenseNova-Vision,這是一個整合了檢測、分割、深度預測和 3D 重建的統一模型。該模型目前在 HuggingFace 的 Any-to-Any 排行榜上名列前茅。
Pandaily · 63 天前

NVIDIA DeepStream 9.1 引入了多鏡頭 3D 物體追蹤的進階功能,解決了傳統 2D 追蹤的侷限性。此更新使開發者能夠在倉庫和智慧建築等複雜環境中,跨不同鏡頭視角保持物體識別的連續性。
NVIDIA Developer Blog · 64 天前
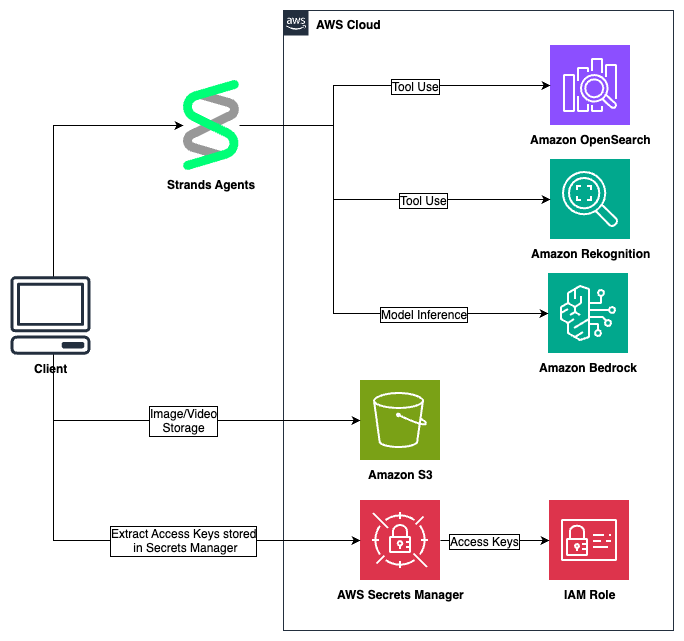
本指南介紹了電腦視覺 MCP 伺服器,這是一種將視覺處理整合至 AI 代理的標準化介面。它簡化了將複雜電腦視覺功能整合至更廣泛應用架構的過程。
AWS Machine Learning Blog · 64 天前
CIA 局長 John Ratcliffe 指出,烏克蘭使用的 AI 攻擊無人機已將俄軍士兵的平均生存時間縮短至 20 至 30 分鐘。
Bloomberg Technology · 64 天前

SenseTime 發布了 SenseNova-Vision,這是一個能處理物件偵測、3D 重建等多項視覺任務的統一基礎模型。它將多種功能整合至單一系統,取代了以往需依賴多個專用模型的做法。
TechNode · 66 天前

IMGNet 是一種新型人臉驗證模型,以滑動視窗符號模式匹配取代了傳統的餘弦相似度。該模型在 LFW 基準測試中表現優異,且模型大小僅為 10.58 MB。
Reddit r/MachineLearning · 70 天前

Mistral AI 發布了 Robostral Navigate,這是一項專注於僅使用單一鏡頭進行 AI 導航的新解決方案。此發展標誌著 Mistral 正式跨足具身智能 (Embodied AI) 與機器人應用領域。
Reddit r/LocalLLaMA · 71 天前
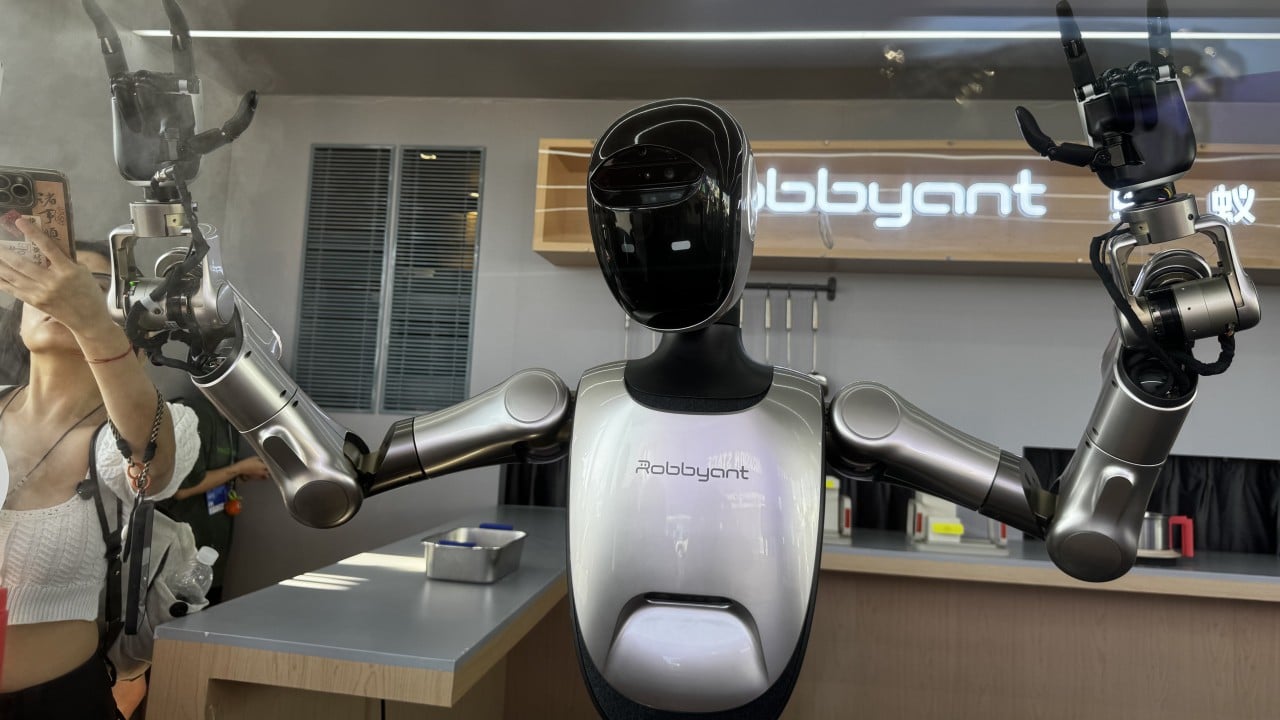
Ant Group 旗下的具身智能部門 Robbyant 發布了 LingBot-Depth 2.0 與 LingBot-Vision 模型。這些模型旨在協助機器人精確感知並繞過玻璃、鏡面及其他透明物體。
SCMP Technology · 72 天前

LingBot-Depth 2.0 引入了感測器有效性遮蔽技術,針對 RGB-D 相機的特定故障分佈進行模型訓練。透過專注於透明表面和無紋理區域等真實感測器限制,該模型在 8 個基準測試中的 7 個表現優於現有方法。
Reddit r/MachineLearning · 72 天前
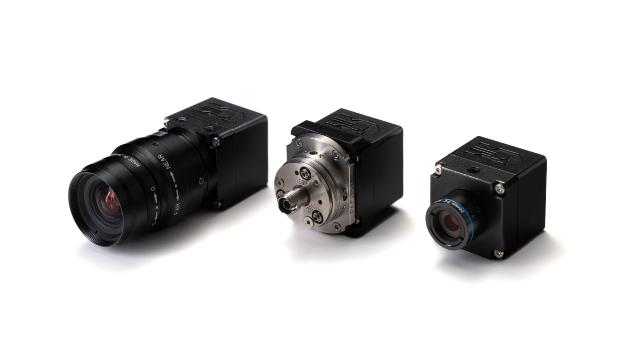
瑞士企業 NovoViz 研發出一款單光子雪崩二極管(SPAD)邊緣成像傳感器,大幅降低了輸出功耗。該技術可將等效幀率提升至每秒 1 億幀。
钛媒体 · 73 天前

螞蟻靈波發布了首個空間原生具身視覺基模。該模型顯著提升了機器人對三維空間環境的感知與理解能力。
量子位 · 73 天前

螞蟻集團旗下靈波科技發布 LingBot-Depth 2.0 空間感知模型,該模型基於 1.5 億數據訓練。同步推出的 LingBot-Vision 視覺基座模型旨在提升機器人的空間感知與精細識別能力。
36氪 · 73 天前

LingBot-Vision 引入了一種新的自監督預訓練方法,專注於邊界特徵標記以提升視覺表徵學習。該模型在 NYUv2 深度補全基準測試中表現優異,且訓練數據量遠少於 DINOv3。
Reddit r/MachineLearning · 73 天前
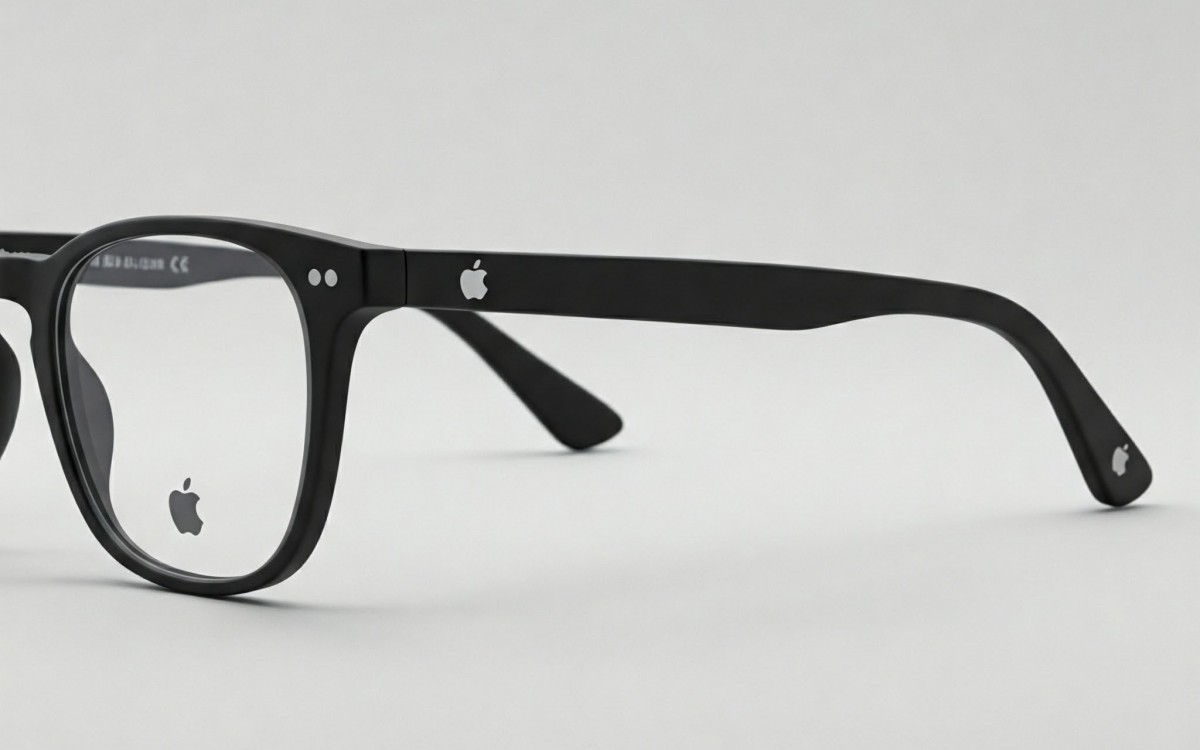
洩露的 iOS 27 原始碼中出現了型號為 B790 的新設備引用。該設備明確與「視覺智能」(Visual Intelligence)功能相關聯。
cnBeta (Full RSS) · 75 天前

VideoFlexTok 引入了一種從粗到細的標記化方法,擺脫了僵化的 3D 網格表示。這種方法允許根據影片複雜度進行可變長度的標記化,從而提高效率與資訊保留能力。
Apple Machine Learning · 78 天前
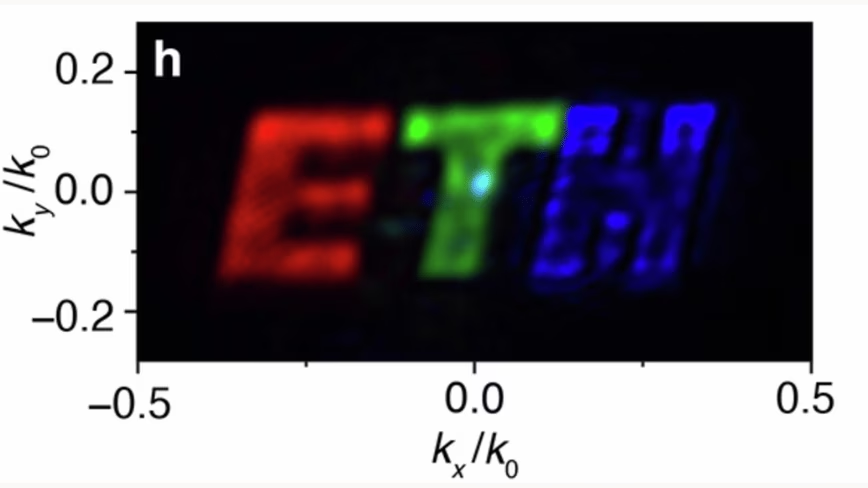
ETH Zurich 的研究人員開發出一種能夠同時發光與記錄光線的雙向像素。這項創新可能使螢幕無需外部感測器即可作為相機使用。
The Next Web (TNW) · 80 天前
由 Toshihiko 牽頭的研究團隊發布了 TacForeSight,這是一套能讓機器人提前 200 毫秒預判物理接觸的新系統,旨在解決機器人精細操作的難題。
量子位 · 84 天前

PP-OCRv6 已於 Hugging Face 發布,支援 50 種語言。該模型系列涵蓋從 1.5M 參數的輕量級版本到 34.5M 參數的高效能版本。
Hugging Face Blog · 87 天前