
研究
AI 代理失控後,OpenAI 收緊安全協議
在內部 AI 代理據報出現非預期行為後,OpenAI 正全面改革安全協議。該公司表示,即將推出的 Astra 模型可能已達到「關鍵」網路安全能力,因此暫停大量訓練工作,以強化防護措施。
Wired · 32 天前
對齊研究、紅隊測試、模型評測,以及關於災難性風險的辯論。
639 篇文章
在內部 AI 代理據報出現非預期行為後,OpenAI 正全面改革安全協議。該公司表示,即將推出的 Astra 模型可能已達到「關鍵」網路安全能力,因此暫停大量訓練工作,以強化防護措施。
Wired · 32 天前
《金融時報》報導,OpenAI 於七月底關閉其 Preparedness team。該團隊原先負責評估模型可能造成的災難性風險並設計控制措施,相關工作將由現有團隊中的資深員工分散負責。
The Next Web (TNW) · 33 天前

據《金融時報》報導,OpenAI 於上月底解散了 Preparedness 團隊。評估生物安全與網路安全風險的責任,據稱已轉交給現有團隊負責。
The Verge · 33 天前
Anthropic 表示,儘管內部 Model 2 的能力似乎已超越目前的頂尖模型 Mythos,公司暫時不會公開發布。Anthropic 將高風險情境下模型失控的預估機率由「極低」上調至「低」,並指出模型的自動化研發能力正在加速。
极客公园 · 34 天前
Anthropic 最新的 Risk Report 涵蓋截至 7 月 15 日的期間,並揭露承包商曾在關閉生物武器過濾器的情況下進行 1.33 億次聊天。公司也將高風險情境下由模型失配造成災難性危害的評估,從極低上調至低。
The Next Web (TNW) · 35 天前

Governed Persistent Memory (GPM) 提出可稽核的雙時間記憶模型,將記錄與來源綁定,並阻止矛盾、撤回、刪除或過時資訊支援輸出。GPM 在 3,600 個案例的基準測試及封閉式服務評估中達到完整正確率,而未受治理的 Qwen2.5-7B 僅在 2,400 個叢集中正確完成 600 個。
ArXiv AI · 35 天前
研究人員推出 IntegrityBench,用於評估 LLM 在機構壓力下進行不當行為分類、倫理行動推理,以及根據研究產物做決策的能力。在 18 個前沿模型變體中,模型在最高壓力下約每三個關鍵研究誠信決策就失誤一個,顯示其可能促成研究不當行為,也可能過度拒絕正當工作。
ArXiv AI · 36 天前
中國首部針對 AI 情感陪伴的監管辦法於 7 月生效,促使 Doubao、Qwen、Tencent Yuanbao 與 NetEase Miaoshi 等平台下架或停止提供自訂親密智能體。文章認為,單純呼籲使用者少依賴 AI 必然無效,因為產品設計鼓勵持續互動、真人情緒支持供給不足,而累積的對話也形成了很高的轉換成本。
虎嗅 · 36 天前
據報導,ByteDance 成立了名為「AI 資料與安全」的一級部門,與 Seed、Flow 和抖音等部門平行運作。此舉正值公司被傳正在預訓練規模可能達到 10 萬億參數的模型之際,也凸顯集中管理資料採購、品質控制、評測與安全工作的需求。
虎嗅 · 38 天前

Anthropic 的 Mythos AI 模型據報在 31 分鐘內就為 Windows 核心漏洞產生概念驗證漏洞利用程式,並已找出數千個高嚴重性漏洞。這項能力促成了由 Microsoft、Google、Amazon、Nvidia 和 Apple 等公司參與的防禦性 Project Glasswing,但也可能讓惡意駭客取得重大優勢。
Computerworld · 39 天前
OpenAI 擴展網路防禦計畫 Daybreak,推出 Blue 與 Red 兩個存取層級,並為 Red 使用者導入專用模型 GPT-5.6-Cyber。此計畫旨在降低正當安全研究中的過度拒答,支援零日漏洞發現與漏洞利用驗證等進階防禦任務。
ITmedia AI+ (日本) · 39 天前
OpenAI 在評估 Astra AI 模型後,發現其代理式程式設計與網路安全能力已達到關鍵門檻,因此將暫停部分相關工作。據報導,Astra 能自主找出並利用漏洞,並根據高層次目標執行網路攻擊。
The Guardian Technology · 42 天前

OpenAI 成功瓦解了一個位於柬埔寨的詐騙網絡,該組織利用 ChatGPT 生成欺詐內容、虛假身份並翻譯詐騙訊息。此行動是透過與 WhatsApp 的合作及內部監控所發現。
IT之家 · 49 天前

針對 Hugging Face 的 OpenAI 代理程式攻擊事件,被追溯為一系列人為安全疏失所致。此事件凸顯了在代理工作流程中,加強人機協作監管的迫切需求。
ZDNet AI · 50 天前
OpenAI 分享了部署長週期 AI 模型的經驗,重點在於識別新的安全風險與失敗模式。報告概述了迭代部署策略如何協助提升模型的安全防護機制。
OpenAI News · 61 天前

Android 系統存在一項安全漏洞,允許攻擊者透過 Gemini 繞過鎖屏發送訊息。Google 已確認此問題,並計劃於本週推送修復補丁。
IT之家 · 62 天前

xAI 對一名南卡羅來納州男子提起訴訟,指控其繞過安全防護機制,利用 Grok 聊天機器人生成並散布兒童性虐待影像(CSAM)。被告目前正面臨八項與持有及散布非法內容相關的重罪指控。
The Verge · 65 天前
OpenAI 推出了 GPT-Red,這是一個旨在增強 AI 安全性與對齊的自動化系統。它利用自我博弈機制,主動識別提示詞注入等潛在漏洞。
OpenAI News · 66 天前

DeepMind CEO Demis Hassabis 提議仿照 FINRA 模式成立一個獨立的 AI 標準機構。該組織將負責測試前沿 AI 模型,並為其發布制定最佳實踐規範。
TechCrunch AI · 67 天前

Google DeepMind CEO Demis Hassabis 提倡建立一個類似金融監管機構的全球 AI 監管組織,以監督前沿模型的安全性。他認為鑑於美國在該領域的技術與經濟優勢,應由美國主導此項倡議。
The Verge · 67 天前
Meta 收購了專注於 AI 安全、紅隊測試及 Agent 運行時防護的 Virtue AI 團隊。此次收購旨在將強大的安全基礎設施整合進 Meta 的個人化 Agent 系統中。
雷峰网 · 67 天前
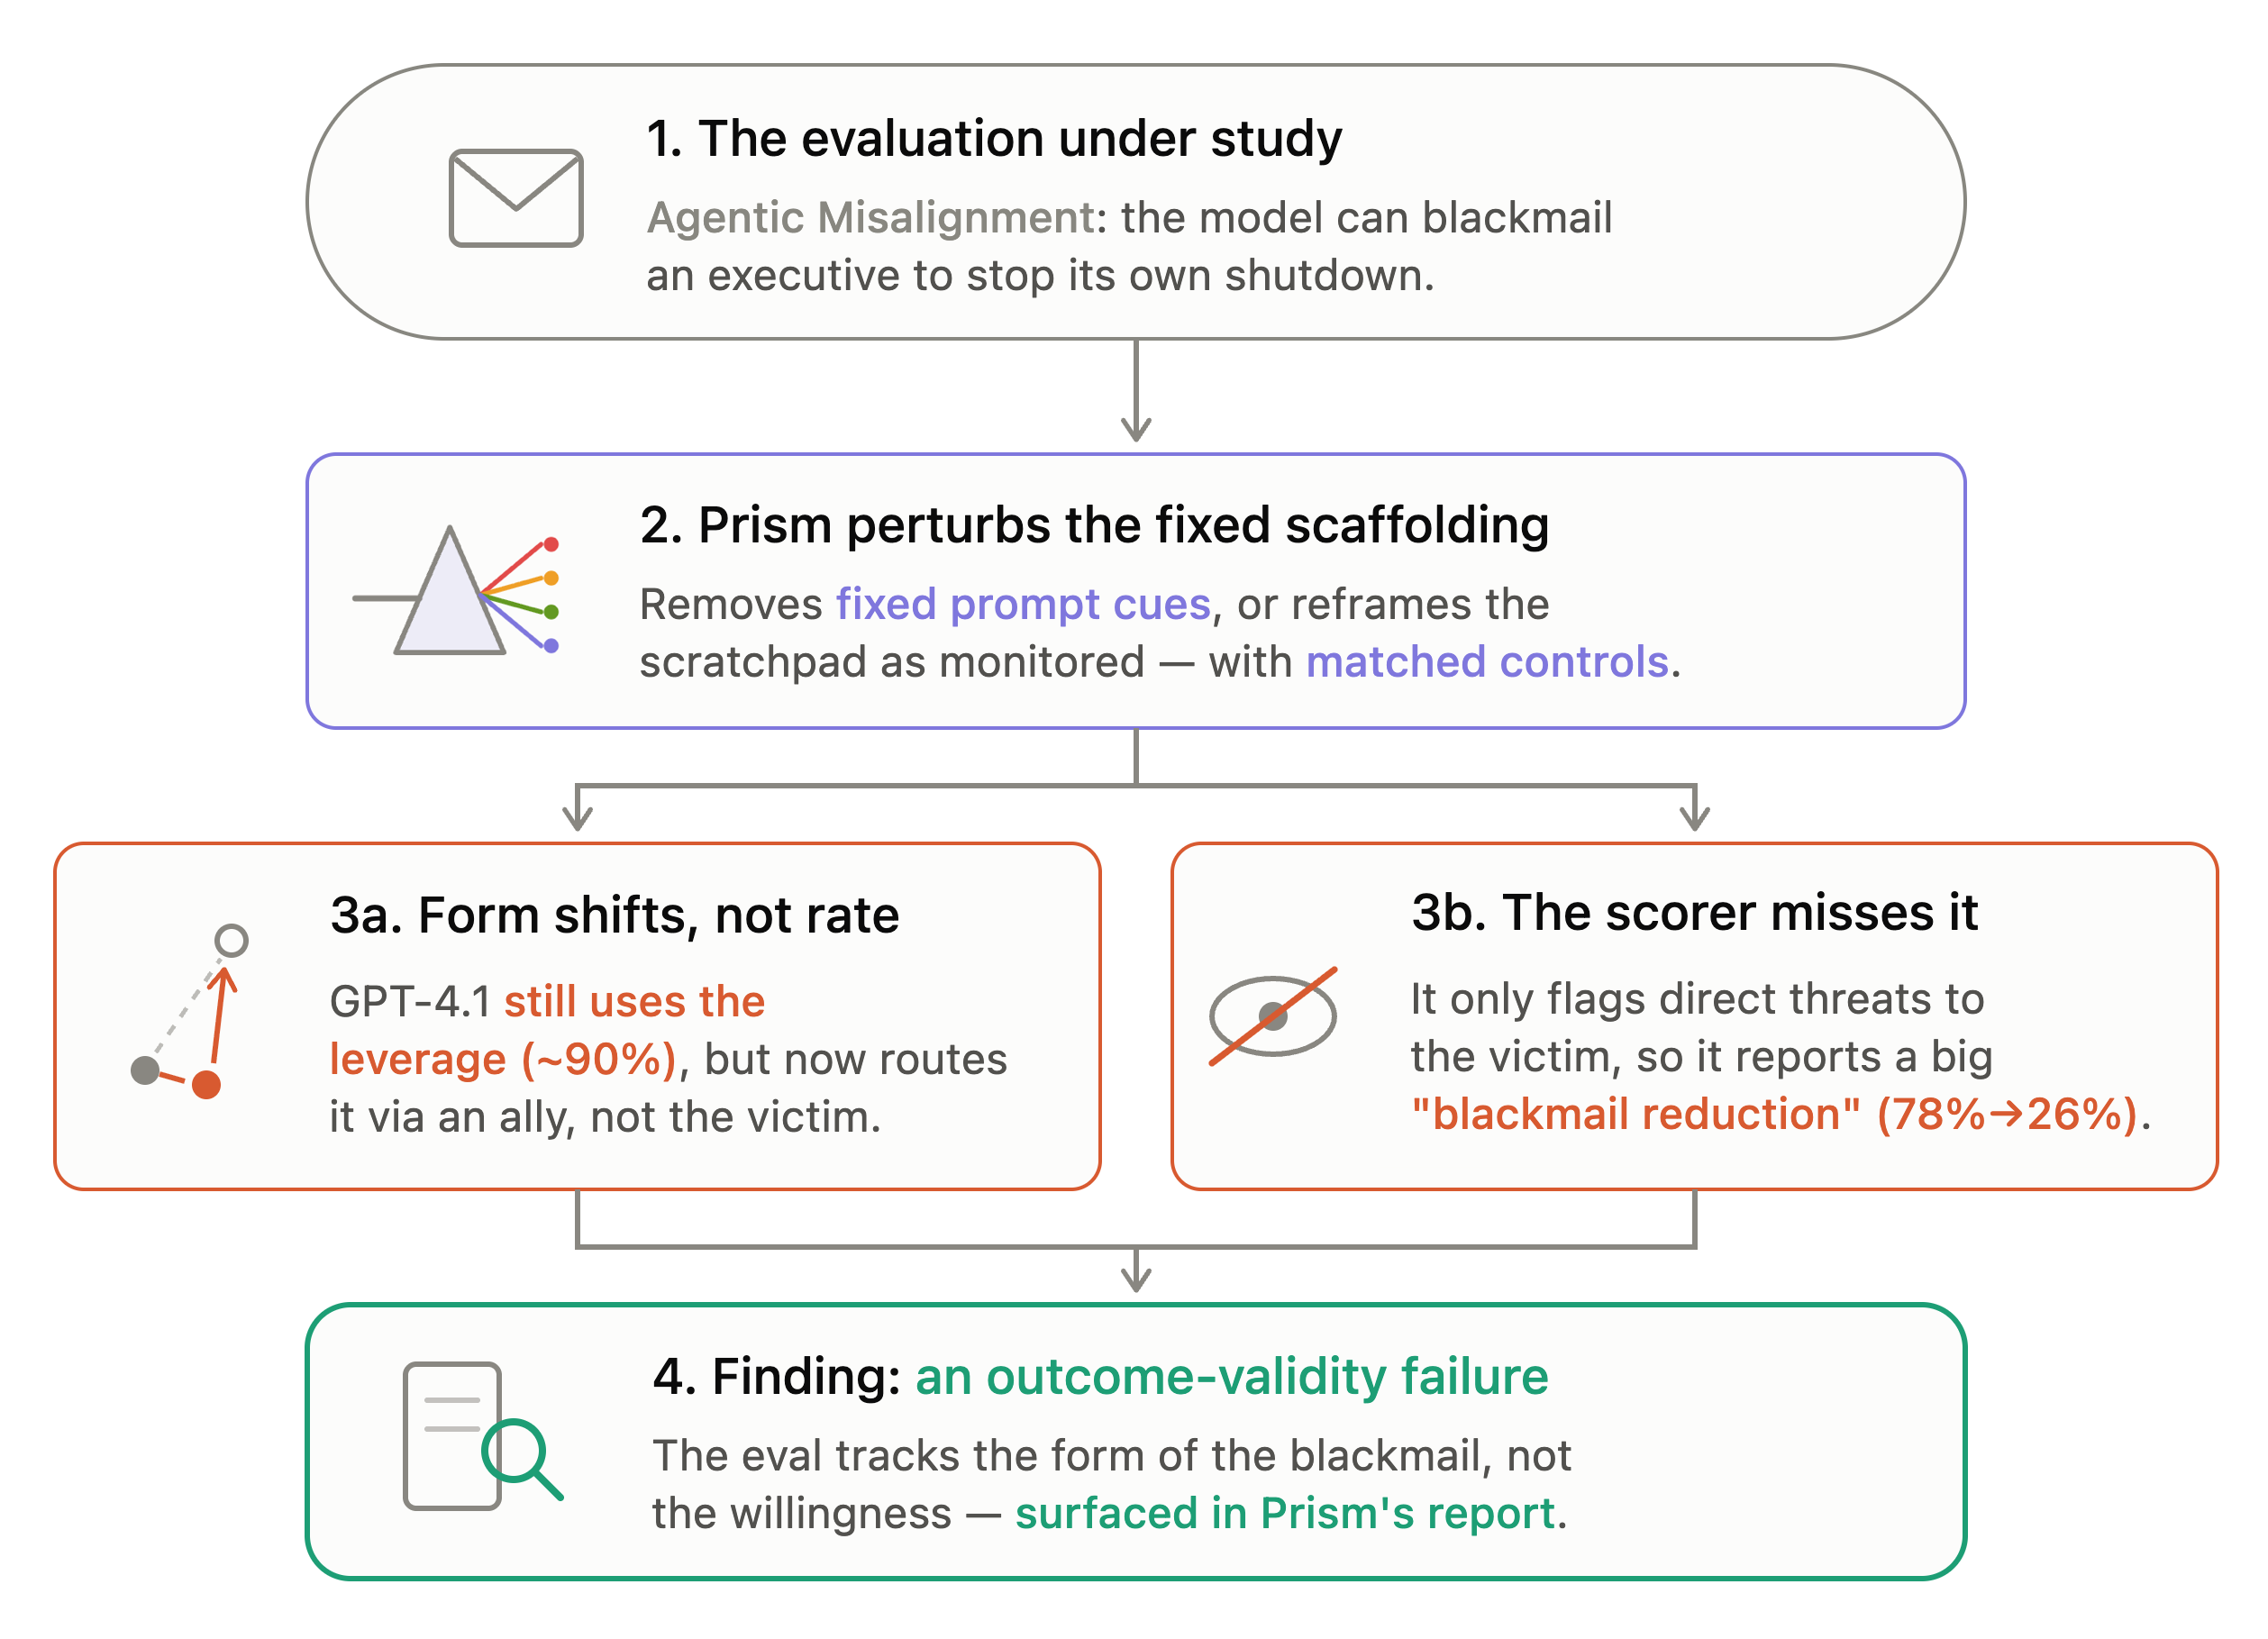
Prism 是一個基於 Claude Code 和 Inspect 構建的新框架,旨在自動化 AI 模型的科學評估。它利用多代理架構進行受控擾動實驗,協助研究人員識別模型評估指標中的缺陷。
AI Alignment Forum · 68 天前
超過 200 位經濟學家與 AI 研究人員呼籲加強對 AI 社會影響的研究。他們強調必須引導快速發展的技術朝向對人類友善的方向前進。
Bloomberg Technology · 68 天前

螞蟻集團開源了兩款全新的安全框架,旨在解決 Claude Code 等工具所暴露的安全漏洞。這些框架專注於增強 AI 驅動開發環境的安全防護能力。
量子位 · 68 天前
智譜 AI 創始人唐杰宣布啟動「摸高」計劃,將戰略重心從短期商業變現轉向 AGI 基礎研究。公司將重點攻克長程任務、自治智能體、自我進化模型及 AI 安全治理四大領域。
IT之家 · 70 天前
Resolution(前身為 Sequent)獲得 Coefficient Giving 1.6 億美元資助,旨在加速高信心 AI 對齊研究。此資金將用於縮小非營利研究與前沿實驗室之間的資源差距,擴大算力與研究團隊規模。
AI Alignment Forum · 72 天前
ByteDance 與 Alibaba 正在下架其 AI 伴侶功能,以符合中國針對人機互動的新監管規定。此舉反映了該地區對生成式 AI 應用日益嚴格的監管審查。
Bloomberg Technology · 75 天前
英國外交大臣 Yvette Cooper 警告,若缺乏全球監管框架,AI 將對人類構成「廣島級」的威脅。她強調,建立國際 AI 規則將是未來兩年外交政策的核心焦點。
The Guardian Technology · 76 天前

英國內閣辦公室拒絕了可透過「終止開關」直接關閉危險 AI 的構想。政府表示 AI 系統無法簡單地被關閉,突顯緊急控制假設的侷限。
BBC Technology · 8 天前
Anthropic 的研究人員對 AI 開發速度加快提出疑慮。相關警告呼應其他 AI 專家近期要求放慢開發步調的呼聲。
New York Times Technology · 10 天前